Модель
dots.tts: безперервні акустичні латентні змінні, узгодження потоку та 48 кГц далекого мовлення
Синтез мовлення / Інтенсивне читання робіт
Синтез мовлення / Інтенсивне читання робіт
© 2026 TelkNet. Всі права захищені.
СИНТЕЗ МОВЛЕННЯ
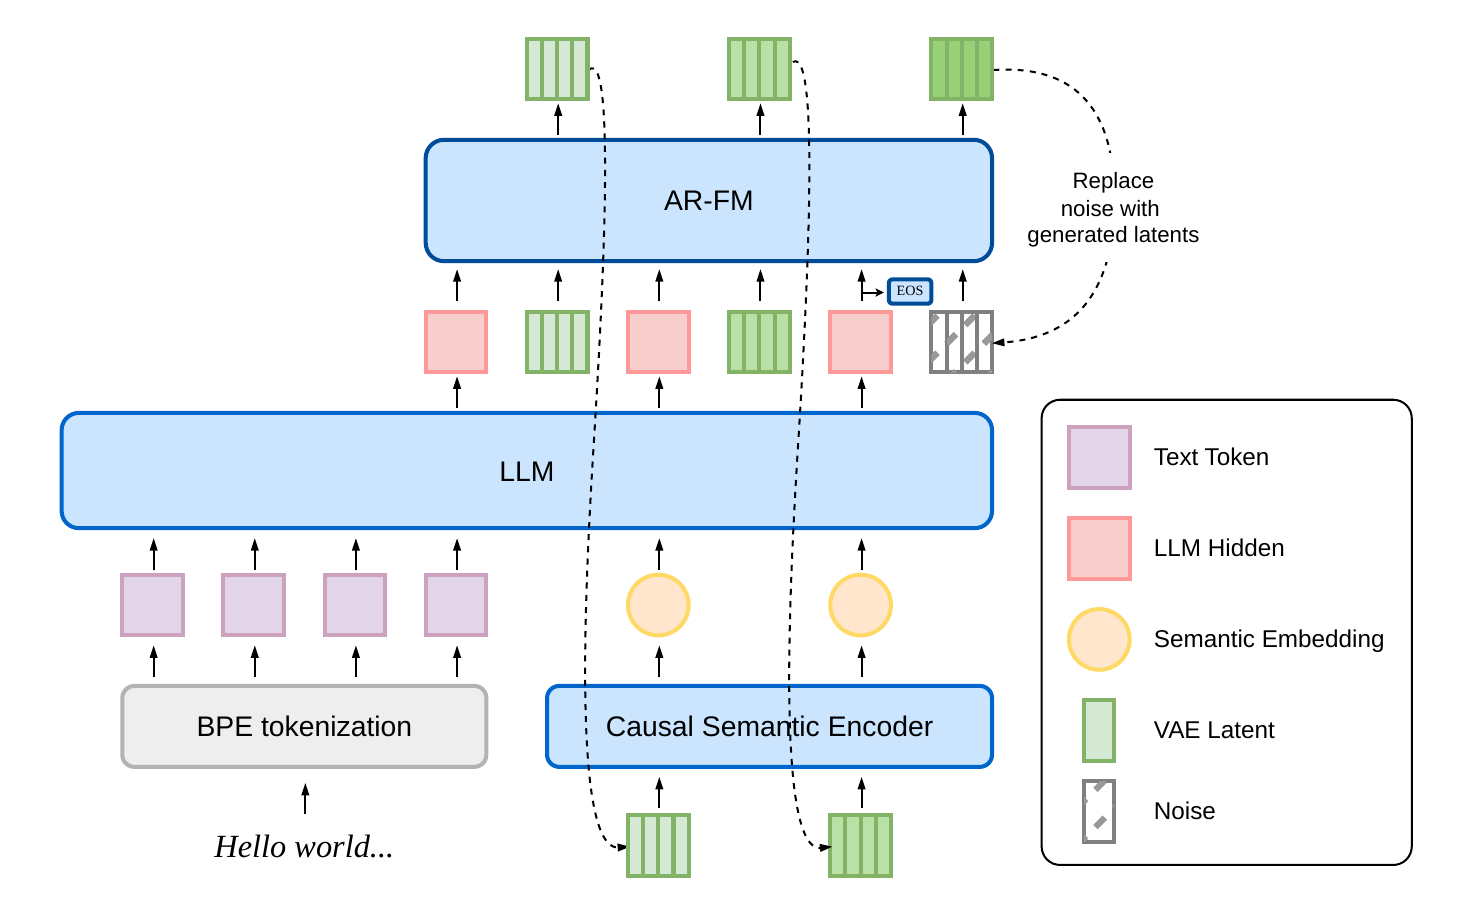
dots.tts не зводить мовлення до дискретних аудіотокенів. AudioVAE видає неперервні латенти, семантичний енкодер стискає згенеровані патчі для мовної основи, а flow-голова передбачає наступну акустичну траєкторію.
Модель навчається на L=E||v_θ(x_t,t,h,s)-u_t||², за умови прихованого стану мовної моделі h та інформації про спікера s. SOAR додає самокоригувальне вирівнювання; MF дистилює траєкторію до чотирьох обчислень.
Офіційна таблиця Seed-TTS-Eval дає SOAR у середньому 79.2 SIM за трьома опублікованими сплітами, а чотирикроковій моделі MeanFlow — 78.2. SOAR вирівняна самокорекцією; MeanFlow дистилює довшу траєкторію вчителя в чотирикрокового студента, що змінює і швидкість, і характер акустичних збоїв.
Офіційні нотатки щодо використання радять короткий, чистий референс, транскрипція якого відповідає запису. Приблизно десяти секунд зазвичай достатньо; довші підказки не покращують клонування автоматично. Випадкове семплювання без референсу — це не стала голосова ідентичність персонажа.
dots.tts обумовлює неперервний flow matching текстом, референсом спікера та акустичним контекстом. dots.tts-soar коригує навчання та ваги задля стійкості у відкритій області й поведінки під час інференсу. LongCat-AudioDiT також використовує неперервну генерацію, але це не та сама задача й не той самий протокол.
Синтез мовлення пройшов шлях від акустичних ознак із вокодерами через авторегресійні кодек-токени до дифузії та flow matching. Важлива зміна — траєкторія й обумовлення, а не простий ярлик «старе проти нового». Короткий референс несе тембр, акцент, мікрофон і кімнату водночас.
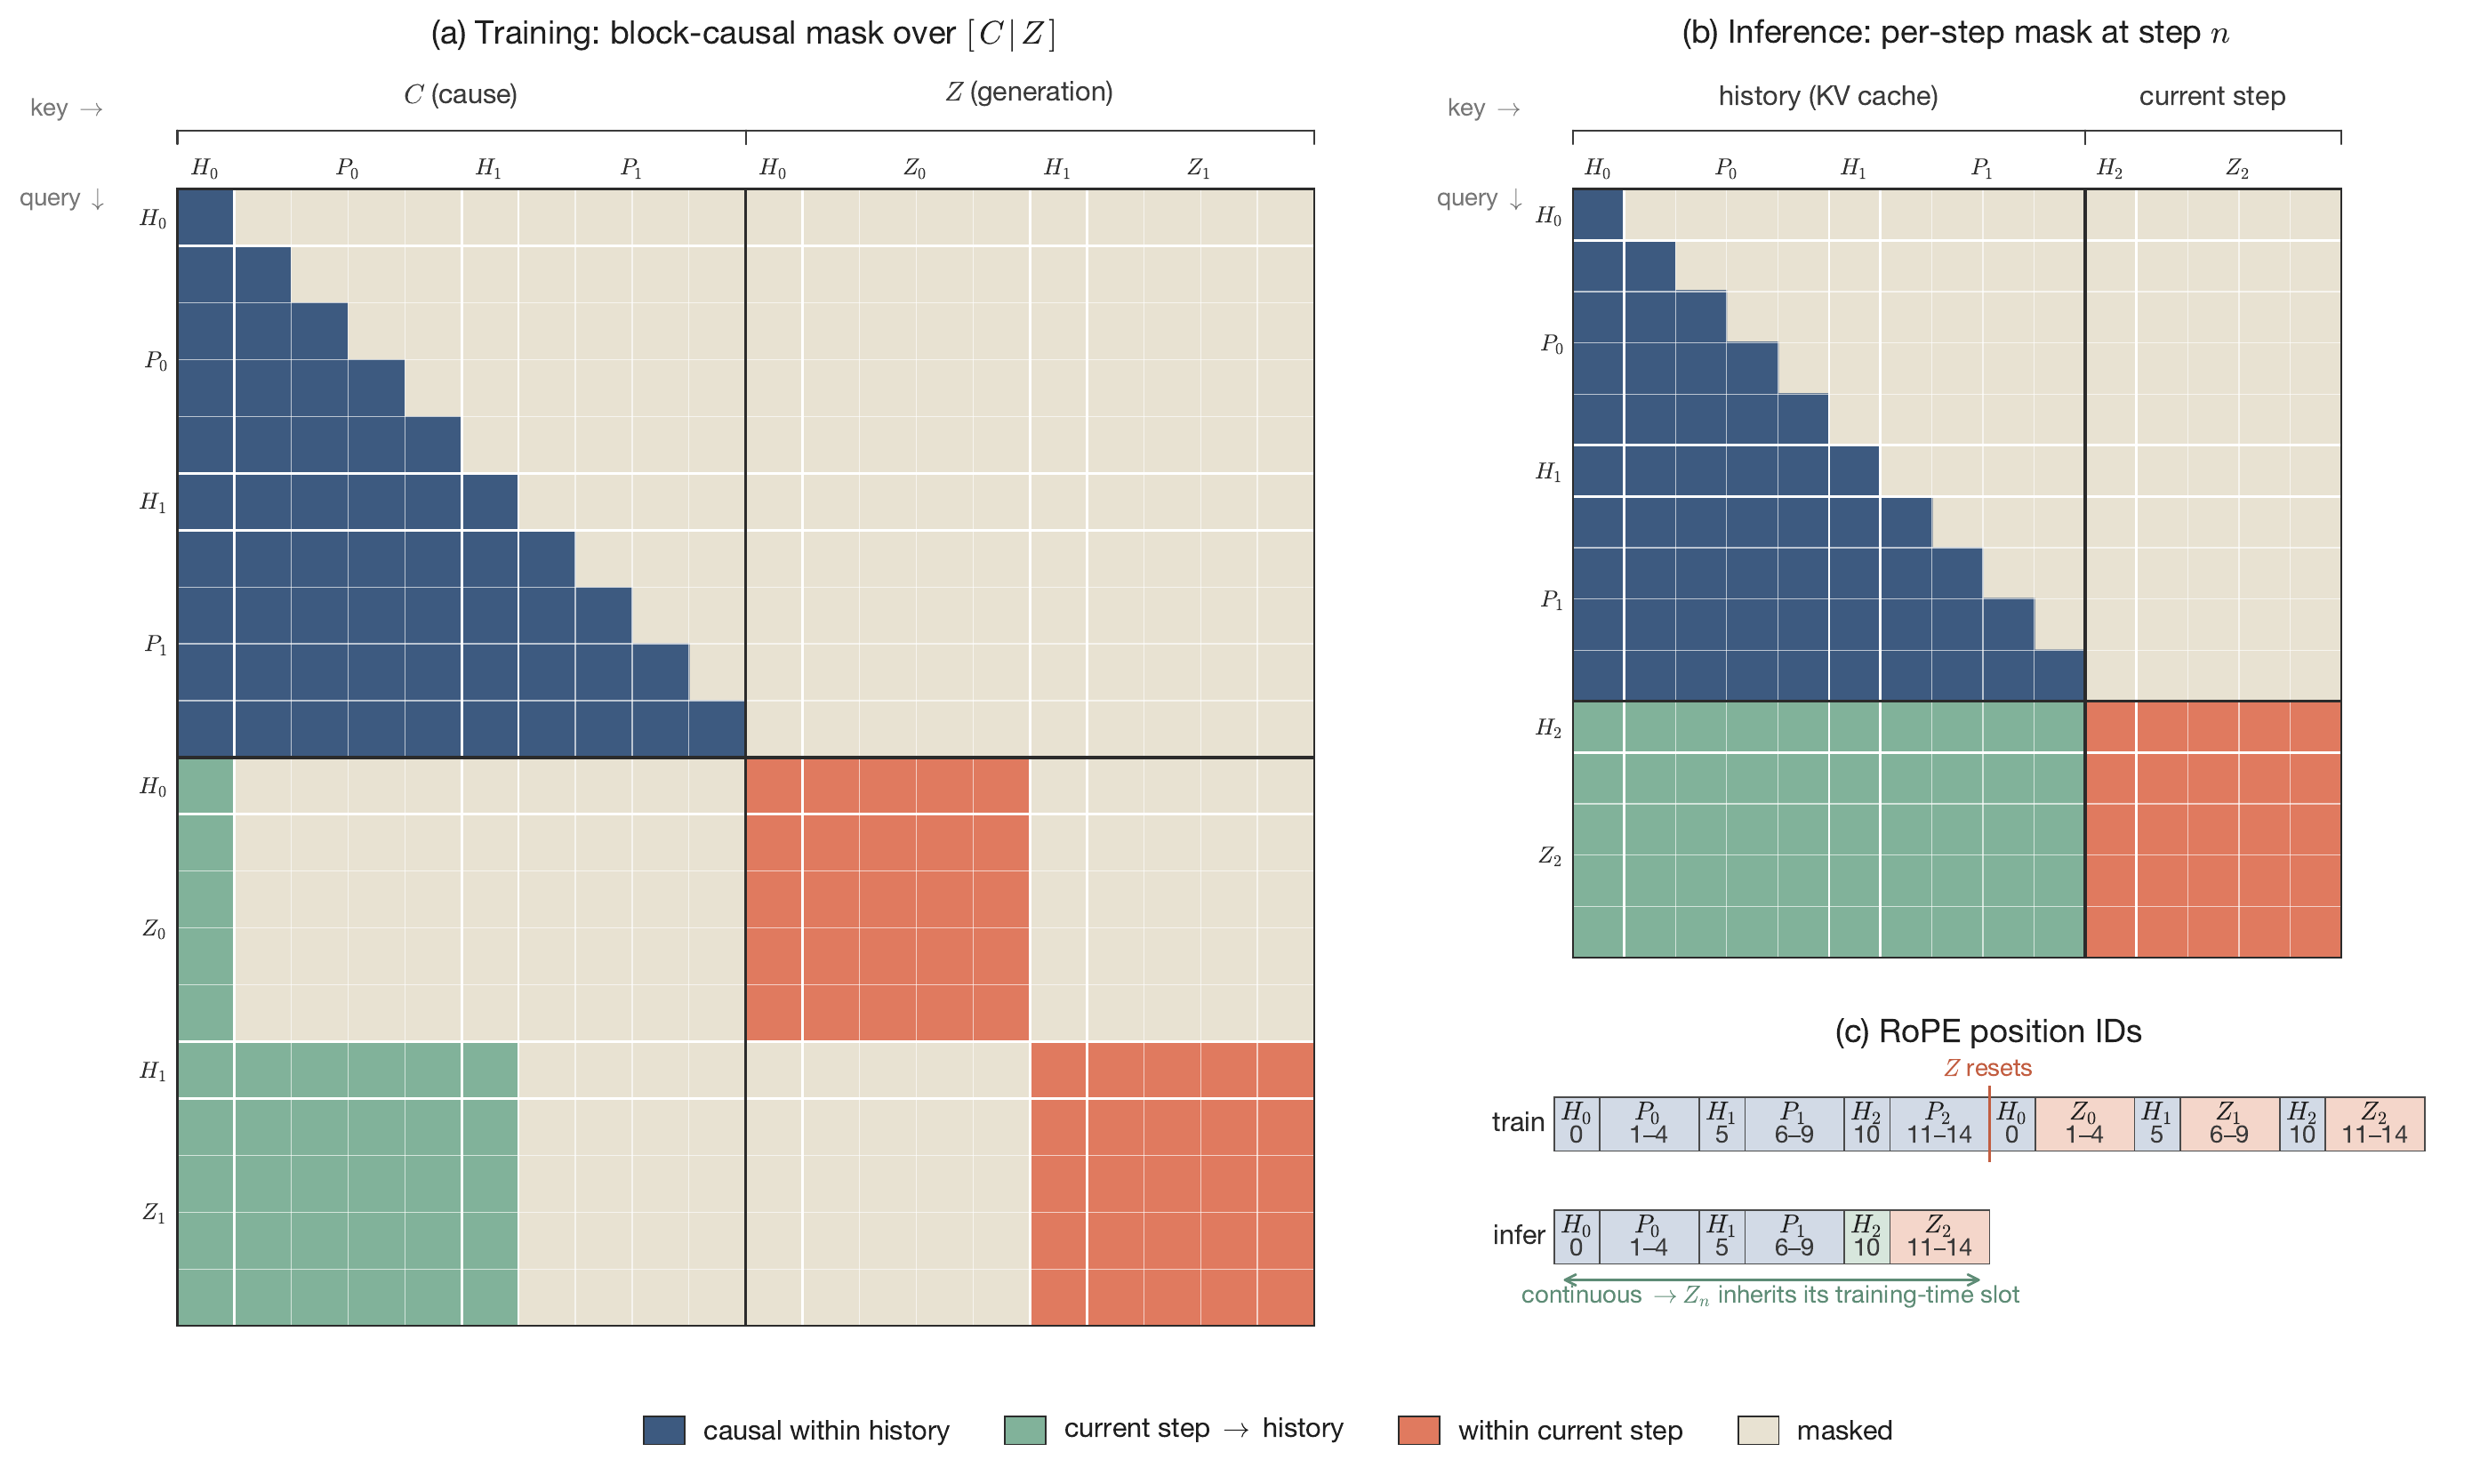
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tнеперервний акустичний латентz_<tпопередній акустичний контекстtextнормалізований текст і керуванняAudioVAE стискає форми хвиль 48 кГц у неперервні латенти, семантичне повторне кодування повертає змістовні ознаки, основа Qwen2.5 моделює контекст, а flow-голова відновлює акустику. Неперервний z — це не дискретний токен кодека.
SOAR на 32 кроках і MF на чотирьох кроках демонструють компроміс між якістю та затримкою. Подібність, WER, затримка до першого аудіо та повний коефіцієнт реального часу мають лишатися окремими.
Статтю, код і ваги можна простежити через dots.tts / dots.tts-soar / Technical report.
Кожен рядок зберігає власну архітектуру джерела, метрику чи визначення задачі; результати без спільного протоколу лишаються окремо.
| Модель | Архітектура або докази | Область |
|---|---|---|
| dots.tts | базовий чекпоінт неперервного потоку | зміст, тембр і узгодженість довгих форм |
| dots.tts-soar | модель для відкритої області та інференсу | стабільність і затримка за того самого референсу |
| авторегресійний кодек-TTS | базова лінія токен за токеном | перше аудіо, повтори та накопичення помилок |
Перш ніж судити про подібність, перевіряйте числа, абревіатури, багатозначні вимови та паузи слово за словом. Оцінки спікера можуть пропустити пропуски й повтори; ASR може не помітити скопійований шум і забарвлення кімнати.
Порівнюйте SOAR і базову модель з однаковим текстом і референсом. Час до першого аудіо, коефіцієнт реального часу, пікову пам’ять і стабільність довгих форм записуйте окремо, а не узагальнюйте систему одним плавним реченням.
Zero-shot обумовлення голосом — це не згода спікера. Публічне використання потребує дозволу, обмежень за метою та шляху для відкликання.
Емоцію, акцент і оточення можна скопіювати разом із тембром; модель не може гарантувати виокремлення чистого чинника ідентичності.
Назви моделей, числа й обмеження простежуються до статей, репозиторіїв або карток моделей нижче.