Modello
dots.tts: variabili latenti acustiche continue, corrispondenza del flusso e parlato a lungo raggio a 48 kHz
Sintesi vocale / Lettura intensiva di articoli
Sintesi vocale / Lettura intensiva di articoli
© 2026 TelkNet. Tutti i diritti riservati.
SINTESI VOCALE
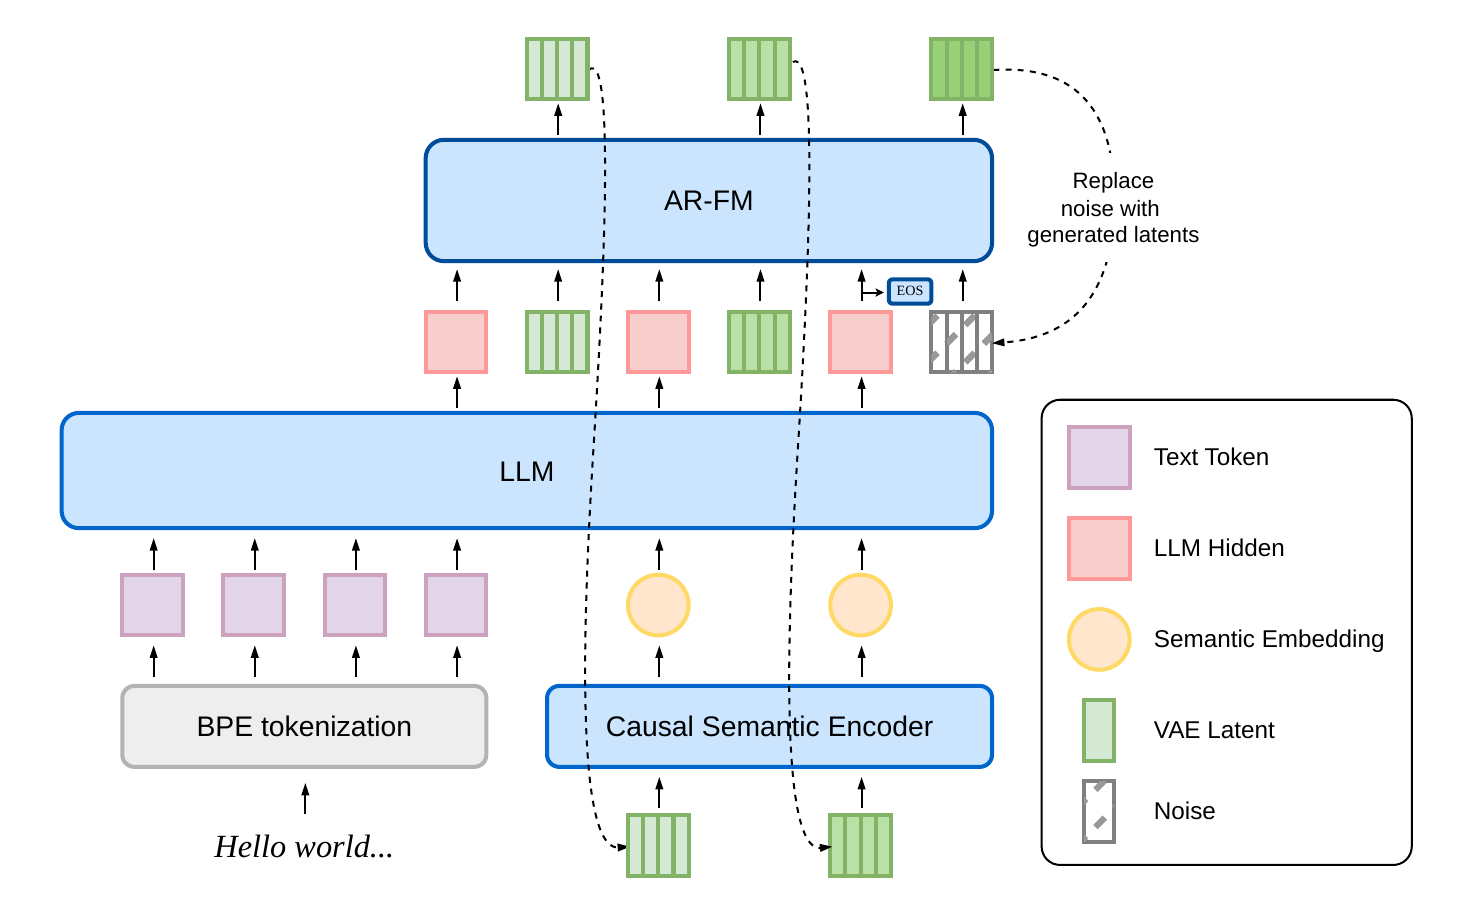
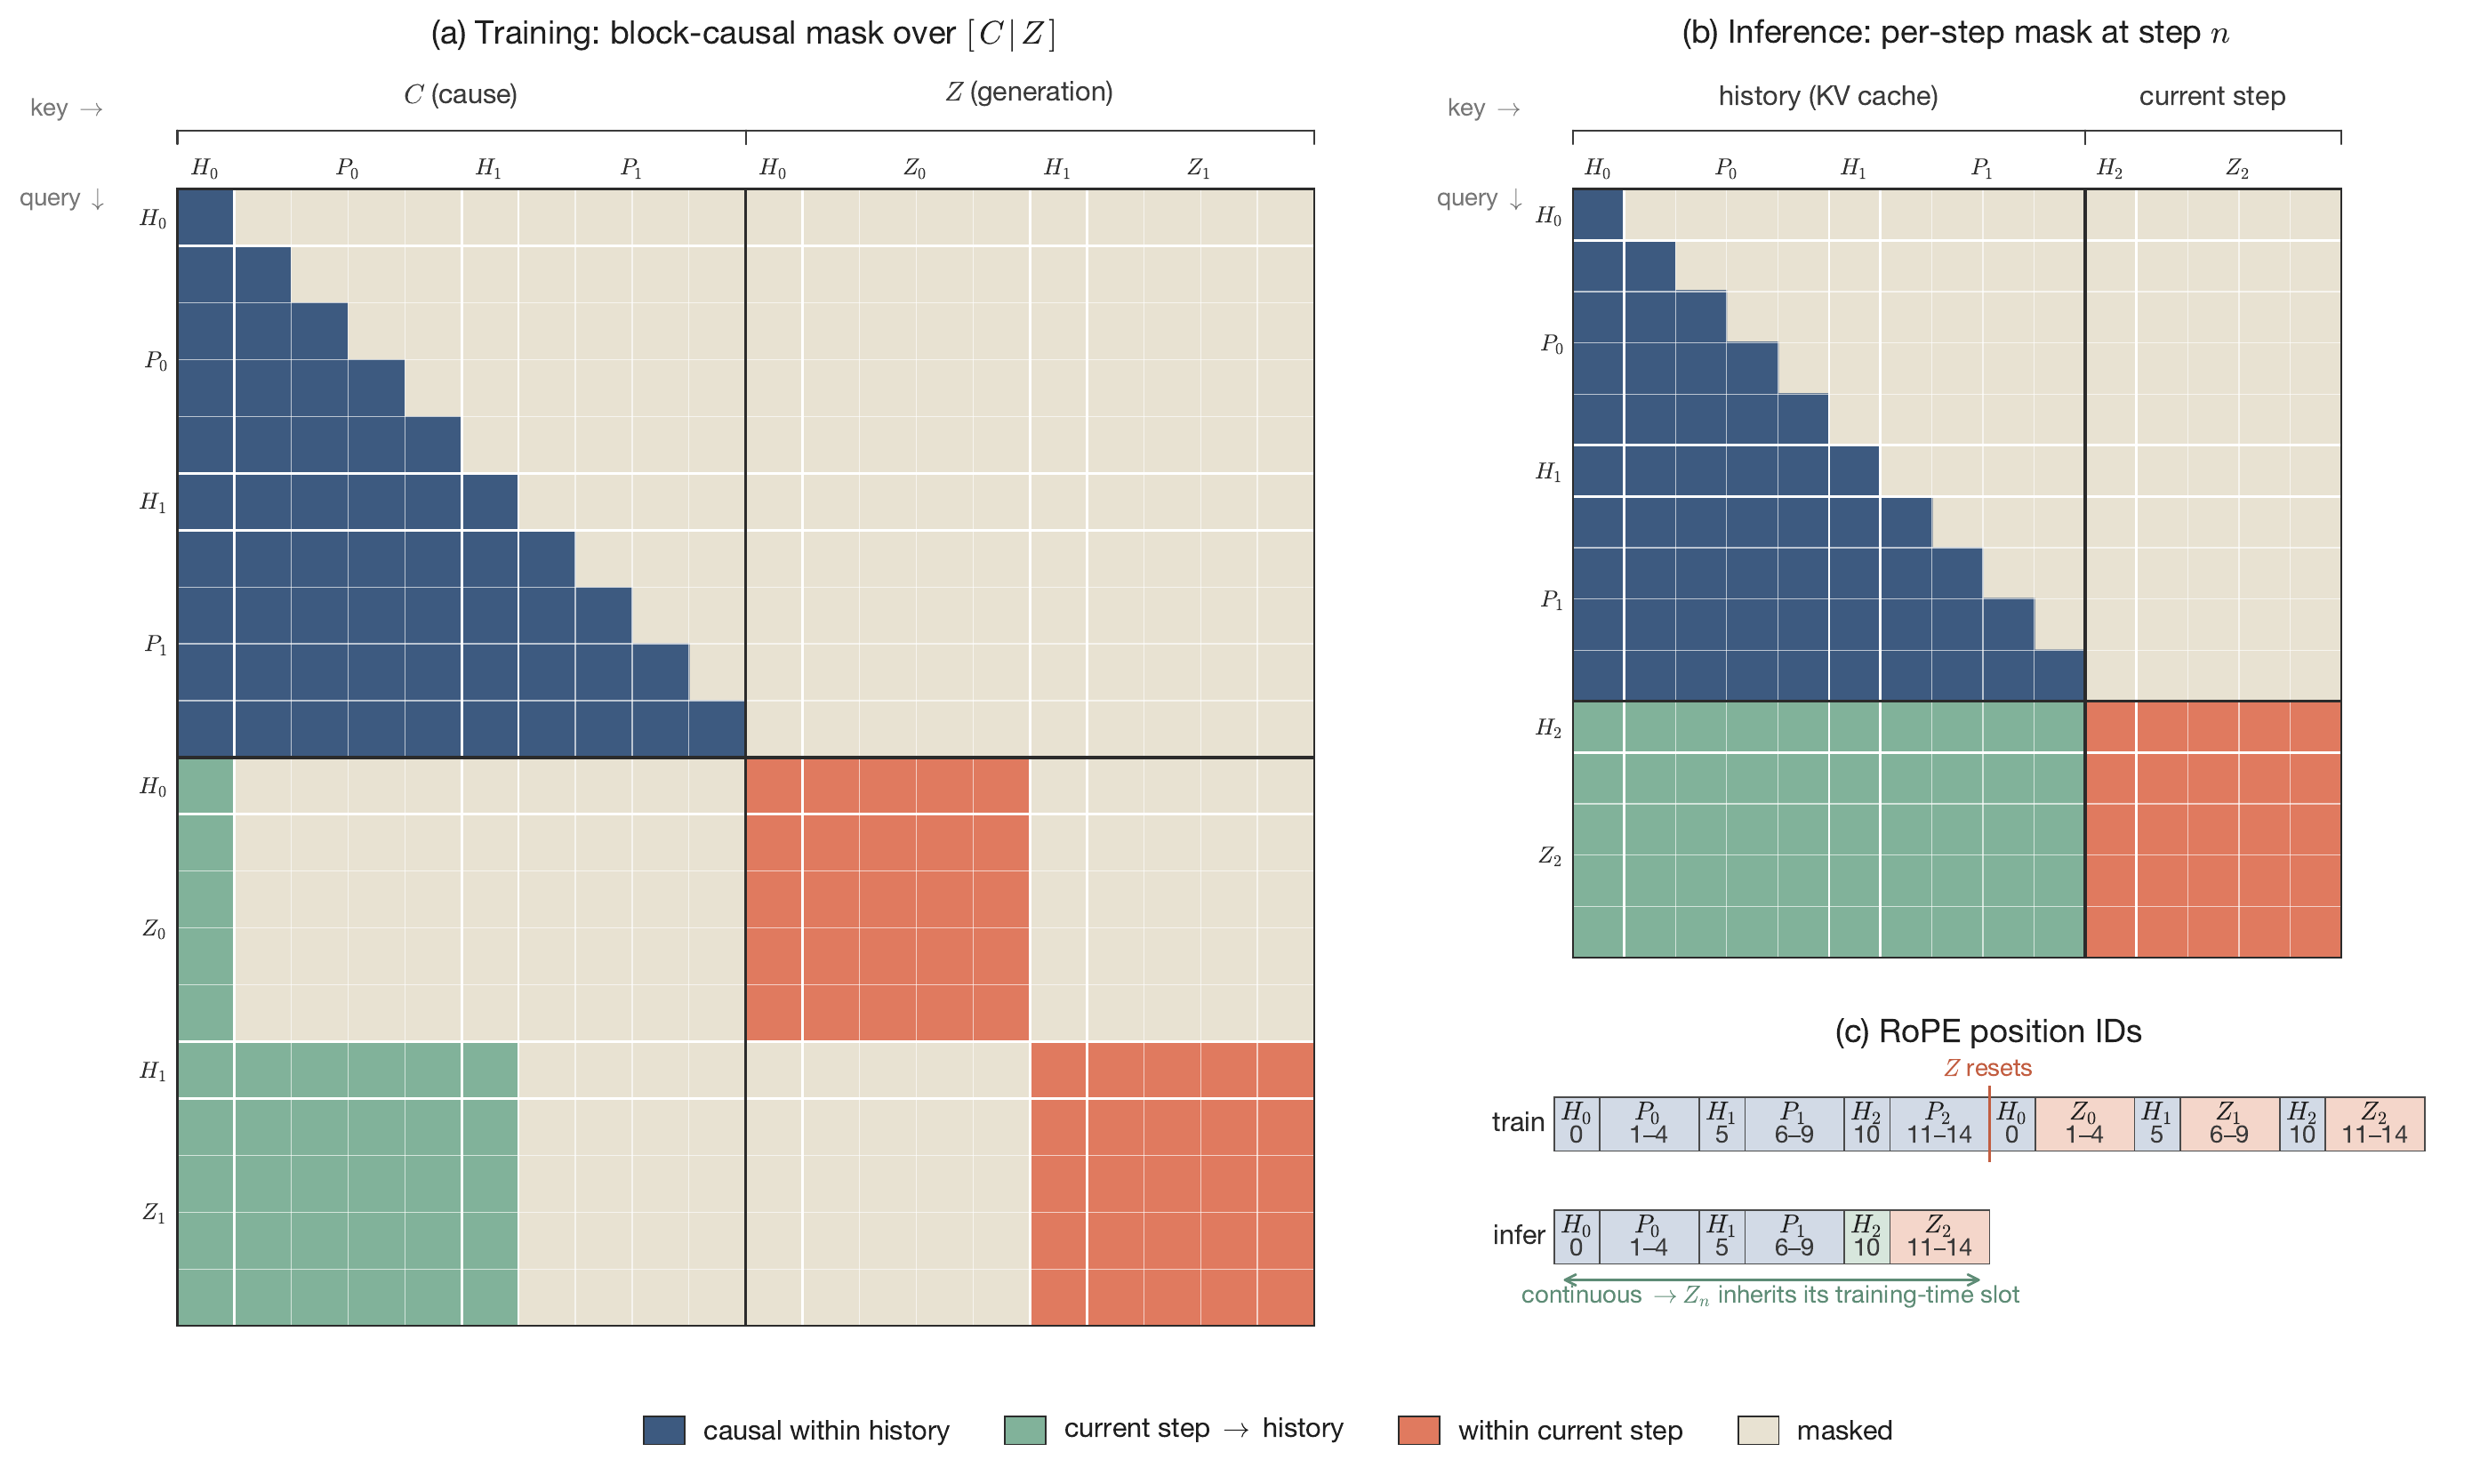
dots.tts non riduce il parlato a token audio discreti. AudioVAE fornisce latenti continui, un codificatore semantico comprime le patch generate per il backbone linguistico e una testa di flusso predice la traiettoria acustica successiva.
Il modello apprende L=E||v_θ(x_t,t,h,s)-u_t||², condizionato dallo stato nascosto linguistico h e dalle informazioni sul parlante s. SOAR aggiunge un allineamento autocorrettivo; MF distilla la traiettoria in quattro valutazioni.
La tabella ufficiale di Seed-TTS-Eval assegna a SOAR un SIM medio di 79.2 sulle tre split pubblicate e al modello MeanFlow a quattro passi 78.2. SOAR è allineato in modo autocorrettivo; MeanFlow distilla una traiettoria insegnante più lunga in uno studente a quattro passi, cambiando sia la velocità sia i modi di fallimento acustico.
Le note d'uso ufficiali consigliano un riferimento breve e pulito, la cui trascrizione corrisponda alla registrazione. Una decina di secondi è di norma sufficiente; prompt più lunghi non migliorano automaticamente la clonazione. Il campionamento casuale senza riferimento non è un'identità vocale persistente.
dots.tts condiziona il flow matching continuo su testo, riferimento del parlante e contesto acustico. dots.tts-soar adatta addestramento e pesi per la robustezza in dominio aperto e il comportamento in inferenza. Anche LongCat-AudioDiT usa la generazione continua, ma non è lo stesso compito né lo stesso protocollo.
La sintesi vocale è passata dalle caratteristiche acustiche con vocoder ai token codec autoregressivi, fino alla diffusione e al flow matching. Il cambiamento importante riguarda la traiettoria e il condizionamento, non una semplice etichetta dal vecchio al nuovo. Un riferimento breve porta con sé timbro, accento, microfono e ambiente insieme.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tlatente acustico continuoz_<tcontesto acustico precedentetexttesto normalizzato e controlliAudioVAE comprime le forme d'onda a 48 kHz in latenti continui, la ricodifica semantica ripristina gli indizi di contenuto, il backbone Qwen2.5 modella il contesto e una testa di flusso ricostruisce l'acustica. La z continua non è un token codec discreto.
SOAR a 32 passi e MF a quattro passi espongono un compromesso tra qualità e latenza. Similarità, WER, latenza del primo audio e fattore di tempo reale completo devono restare separati.
Paper, codice e pesi si possono seguire tramite dots.tts / dots.tts-soar / Relazione tecnica.
Ogni riga conserva la propria architettura, metrica o definizione di compito d'origine; i risultati senza un protocollo condiviso restano separati.
| Modello | Architettura o evidenza | Ambito |
|---|---|---|
| dots.tts | checkpoint base a flusso continuo | contenuto, timbro e coerenza sul lungo formato |
| dots.tts-soar | modello per dominio aperto/inferenza | stabilità e latenza a parità di riferimento |
| TTS codec autoregressivo | baseline token per token | primo audio, ripetizione e accumulo di errori |
Verificare numeri, abbreviazioni, omografi e pause parola per parola prima di giudicare la similarità. I punteggi di parlante possono non cogliere omissioni e ripetizioni; l'ASR può non cogliere il rumore copiato e la colorazione dell'ambiente.
Confrontare SOAR e base con testo e riferimento identici. Registrare separatamente tempo al primo audio, fattore di tempo reale, memoria di picco e stabilità sul lungo formato, invece di riassumere un sistema con una sola frase fluente.
Il condizionamento vocale zero-shot non è il consenso del parlante. L'uso pubblico richiede autorizzazione, limiti di scopo e un percorso di ritiro.
Emozione, accento e ambiente possono essere copiati insieme al timbro; il modello non può garantire l'estrazione di un fattore di identità puro.
Nomi dei modelli, numeri e limitazioni rimandano ai paper, ai repository o alle model card qui sotto.