dots.tts: 連続音響潜在変数、フローマッチング、および 48 kHz 長距離音声
音声合成 / 論文の精読
音声合成
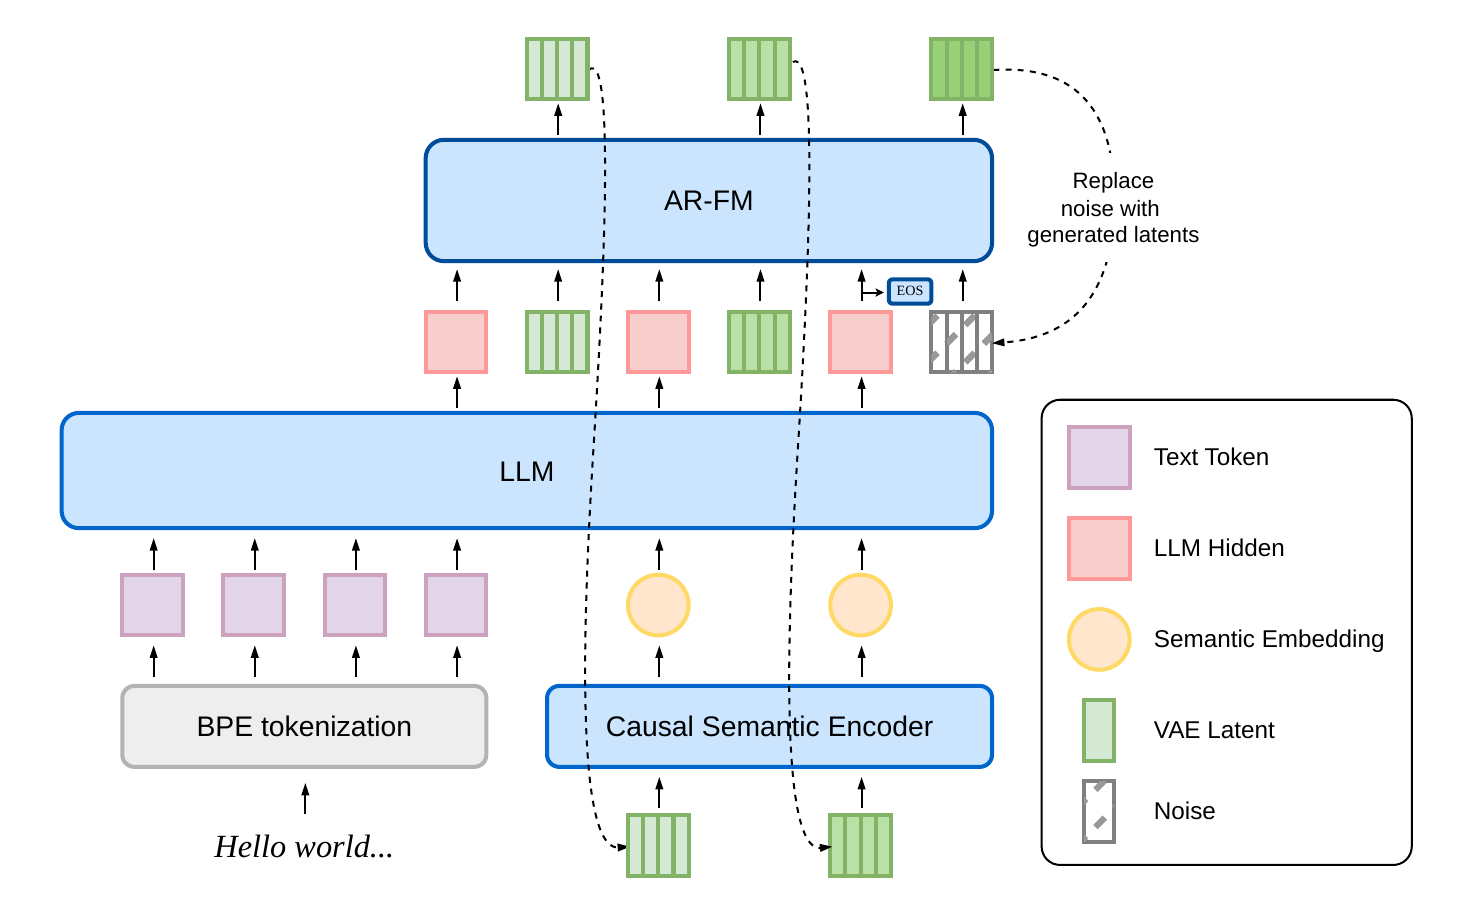
dots.tts は音声を離散的なオーディオトークンに還元しない。AudioVAE が連続潜在変数を供給し、セマンティックエンコーダが生成パッチを言語バックボーン向けに圧縮し、フローヘッドが次の音響軌道を予測する。
条件付きフローマッチング
このモデルは L=E||v_θ(x_t,t,h,s)-u_t||² を学習する。言語の隠れ状態 h と話者情報 s が条件だ。SOAR は自己修正アライメントを加え、MF は軌道を 4 回の評価に蒸留する。
SOAR と MeanFlow は異なる誤差を引き受ける
公式の Seed-TTS-Eval の表では、公開された 3 つの分割における平均 SIM が SOAR で 79.2、4 ステップの MeanFlow モデルで 78.2 となっている。SOAR は自己修正アライメント済みで、MeanFlow はより長い教師軌道を 4 ステップの生徒に蒸留したものだ。速度と音響的な失敗の様子がどちらも変わる。
参照音声とランダムな声
公式の利用上の注意は、録音内容と一致する書き起こしを持つ短くクリーンな参照を勧めている。通常は 10 秒ほどで十分で、長いプロンプトが自動的にクローニングを改善するわけではない。参照なしのランダムサンプリングは、持続的なキャラクター同一性にはならない。
音響表現はどう変化してきたか
dots.tts は連続フローマッチングをテキスト、話者参照、音響コンテキストに条件付ける。dots.tts-soar はオープンドメインでの頑健性と推論挙動のために学習と重みを調整したものだ。LongCat-AudioDiT も連続生成を採用しているが、課題もプロトコルも同じではない。
音声合成は、音響特徴とボコーダの組み合わせから自己回帰コーデックトークンを経て、拡散とフローマッチングへと移ってきた。重要な変化は軌道と条件付けであり、新旧の単純なラベルではない。短い参照には音色、アクセント、マイク、部屋の響きがまとめて乗る。
連続音響潜在変数上の自己回帰フローマッチング
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_t連続音響潜在変数z_<t過去の音響コンテキストtext正規化されたテキストと制御情報
AudioVAE が 48 kHz の波形を連続潜在変数に圧縮し、セマンティック再エンコードが内容の手がかりを復元し、Qwen2.5 バックボーンがコンテキストをモデル化し、フローヘッドが音響を復元する。連続の z は離散コーデックトークンではない。
32 ステップの SOAR と 4 ステップの MF は品質とレイテンシのトレードオフを示している。類似度、WER、初回音声までのレイテンシ、全体のリアルタイム係数は分けて扱う必要がある。
論文、コード、重みは dots.tts / dots.tts-soar / Technical report からたどれる。
各音声指標が答えるもの
各行は出典となるアーキテクチャ、指標、課題定義をそのまま保持している。共通プロトコルのない結果は分けたままにする。
| モデル | アーキテクチャまたは根拠 | 範囲 |
|---|---|---|
| dots.tts | ベースの連続フローチェックポイント | 内容、音色、長編の一貫性 |
| dots.tts-soar | オープンドメイン/推論モデル | 同一参照下での安定性とレイテンシ |
| 自己回帰コーデック TTS | トークンごとのベースライン | 初回音声、繰り返し、誤差の蓄積 |
内容、音色、長編の試聴
類似度を判断する前に、数字、略語、多音字、ポーズを一語ずつ確認する。話者スコアは脱落や繰り返しを見逃すことがあり、ASR はコピーされたノイズや部屋の色付けを見逃すことがある。
SOAR とベースは同一のテキストと参照で比較する。初回音声までの時間、リアルタイム係数、ピークメモリ、長編での安定性は別々に記録し、流暢な一文でシステムをまとめて評価しない。
声の類似が残すリスク
ゼロショットの声の条件付けは話者の同意ではない。公開利用には許可、目的の制限、撤回の経路が必要だ。
感情、アクセント、環境は音色と一緒にコピーされうる。モデルは純粋な同一性因子だけを抽出できると保証できない。
dots.tts の論文と公開ファイル
モデル名、数値、制約は以下の論文、リポジトリ、モデルカードにたどれる。