โมเดล
dots.tts: ตัวแปรแฝงเสียงต่อเนื่อง การจับคู่โฟลว์ และคำพูดระยะไกล 48 kHz
การสังเคราะห์คำพูด / การอ่านบทความอย่างเข้มข้น
การสังเคราะห์คำพูด / การอ่านบทความอย่างเข้มข้น
© 2026 TelkNet สงวนลิขสิทธิ์.
การสังเคราะห์เสียงพูด
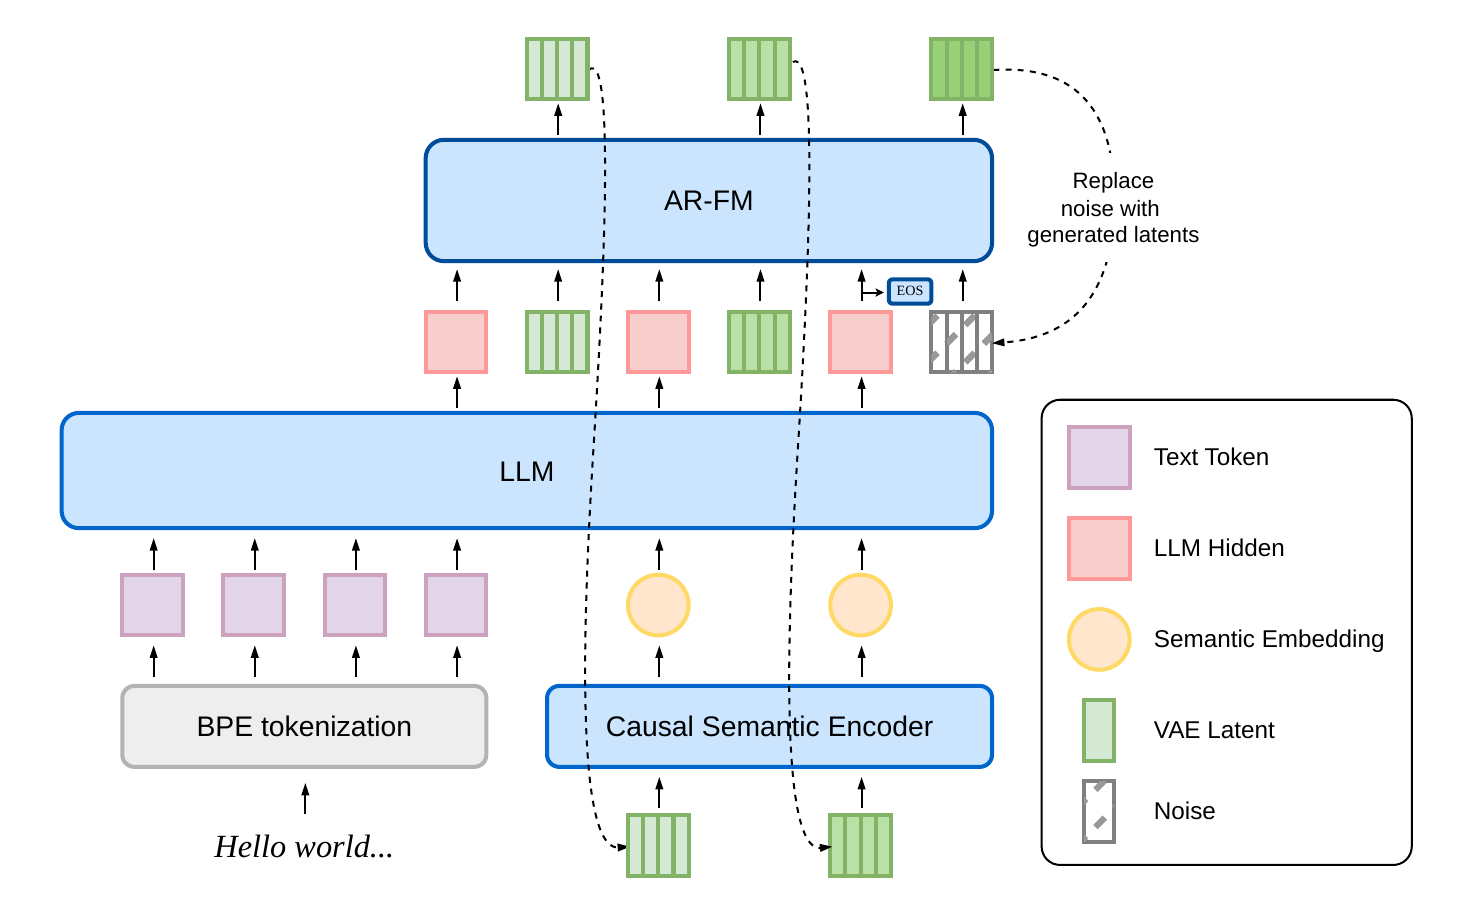
dots.tts ไม่ได้ย่อเสียงพูดให้กลายเป็นโทเค็นเสียงแบบไม่ต่อเนื่อง AudioVAE จัดเตรียมตัวแปรแฝงแบบต่อเนื่อง ตัวเข้ารหัสเชิงความหมายบีบอัดแพตช์ที่สร้างขึ้นให้กับโครงหลักภาษา และหัว flow ทำนายวิถีเชิงเสียงถัดไป
โมเดลเรียนรู้ L=E||v_θ(x_t,t,h,s)-u_t||² โดยมีเงื่อนไขจากสถานะซ่อนของภาษา h และข้อมูลผู้พูด s SOAR เพิ่มการจัดเรียงแบบแก้ไขตนเอง ส่วน MF กลั่นวิถีให้เหลือเพียงสี่การประเมิน
ตาราง Seed-TTS-Eval อย่างเป็นทางการให้ SOAR มีค่า SIM เฉลี่ย 79.2 ในทั้งสามชุดแบ่งที่เผยแพร่ และโมเดล MeanFlow สี่ขั้นตอนได้ 78.2 SOAR ถูกจัดเรียงแบบแก้ไขตนเอง ส่วน MeanFlow กลั่นวิถีครูที่ยาวกว่าให้เป็นศิษย์สี่ขั้นตอน ซึ่งเปลี่ยนทั้งความเร็วและรูปแบบความล้มเหลวเชิงเสียง
คำแนะนำการใช้งานอย่างเป็นทางการแนะให้ใช้เสียงอ้างอิงที่สั้นและสะอาด โดยถ้อยคำถอดเทปต้องตรงกับการบันทึก โดยปกติประมาณสิบวินาทีก็เพียงพอแล้ว พรอมป์ที่ยาวกว่าไม่ได้ทำให้การโคลนดีขึ้นโดยอัตโนมัติ การสุ่มโดยไม่มีเสียงอ้างอิงไม่ใช่ตัวตนของตัวละครที่คงอยู่ถาวร
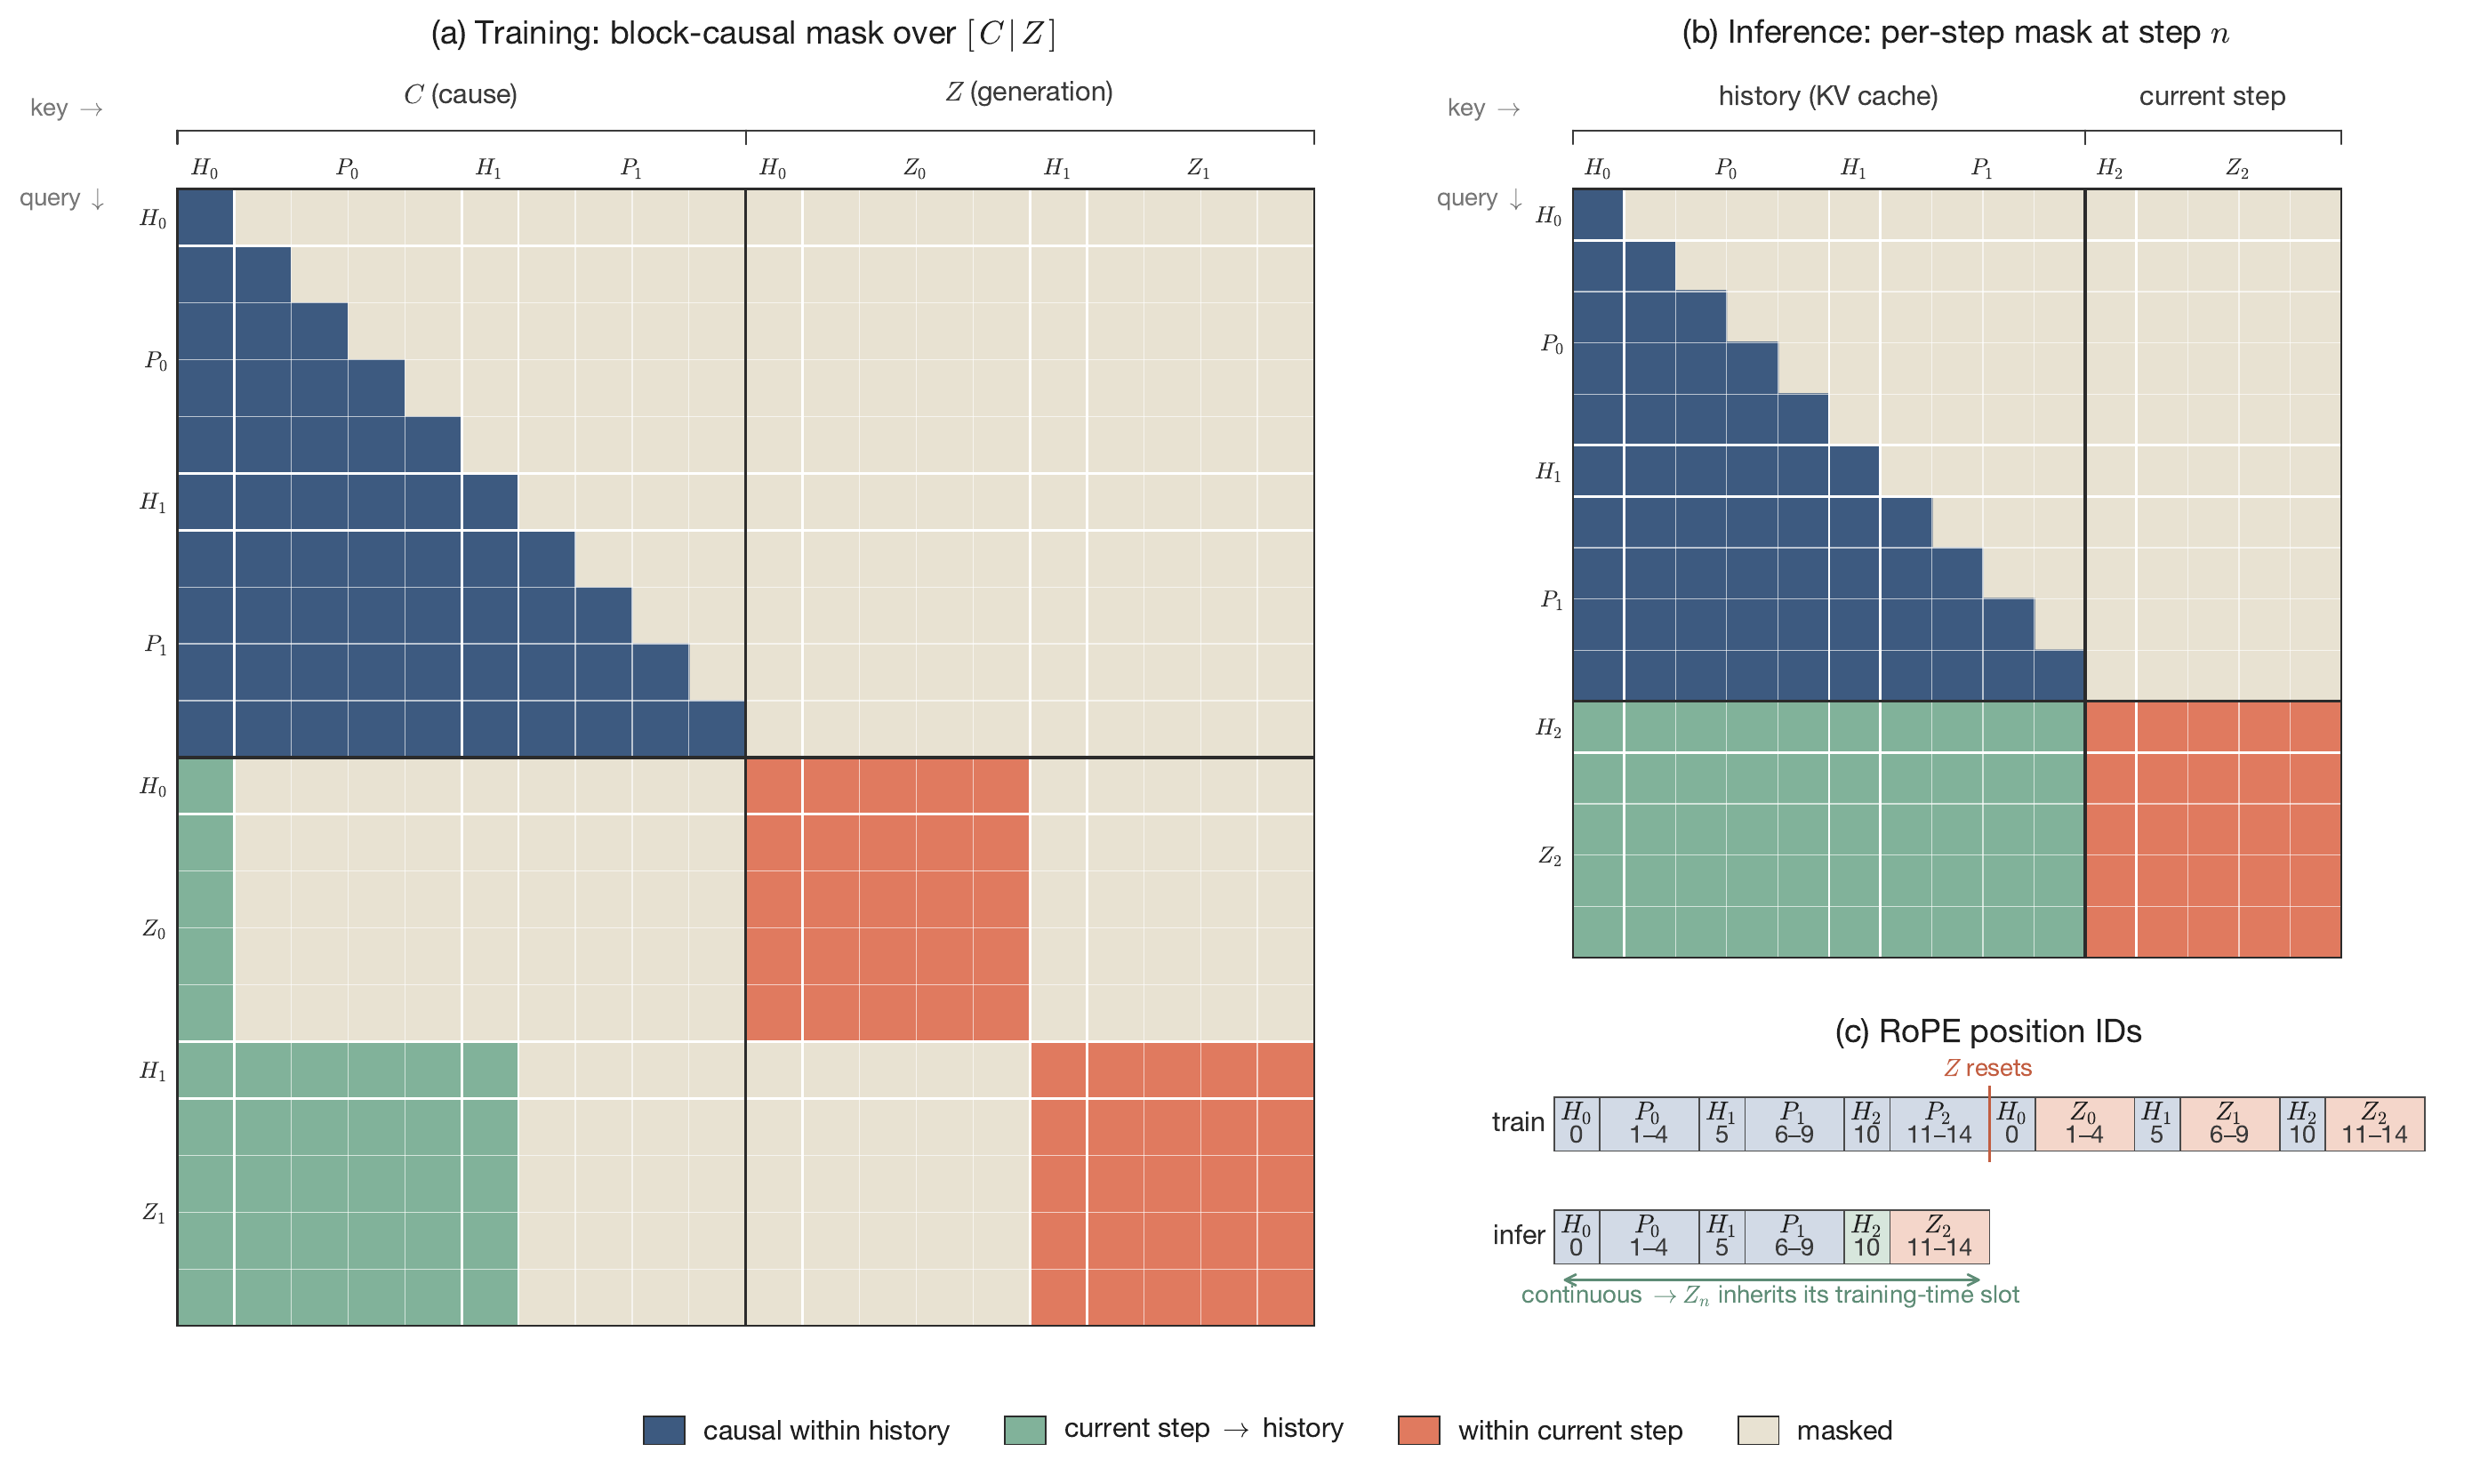
dots.tts กำหนดเงื่อนไขของ flow matching แบบต่อเนื่องด้วยข้อความ เสียงอ้างอิงผู้พูด และบริบทเชิงเสียง dots.tts-soar ปรับการฝึกและน้ำหนักเพื่อความคงทนในโดเมนเปิดและพฤติกรรมการอนุมาน LongCat-AudioDiT ก็ใช้การสร้างแบบต่อเนื่องเช่นกัน แต่ไม่ใช่งานหรือโปรโตคอลเดียวกัน
การสังเคราะห์เสียงพูดเคลื่อนจากคุณลักษณะเชิงเสียงบวกโวโคเดอร์ ผ่านโทเค็นโคเดกแบบออโตรีเกรสซีฟ มาสู่ดิฟฟิวชันและ flow matching การเปลี่ยนแปลงที่สำคัญคือวิถีและเงื่อนไข ไม่ใช่ป้ายเก่า-ใหม่ธรรมดา เสียงอ้างอิงสั้น ๆ หอบเอาทั้งทิมเบอร์ สำเนียง ไมโครโฟน และห้องไปด้วยกัน
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tตัวแปรแฝงเชิงเสียงแบบต่อเนื่องz_<tบริบทเชิงเสียงก่อนหน้าtextข้อความที่ทำให้เป็นมาตรฐานและตัวควบคุมAudioVAE บีบอัดคลื่นเสียง 48 kHz ให้เป็นตัวแปรแฝงแบบต่อเนื่อง การเข้ารหัสเชิงความหมายซ้ำกู้คืนสัญญาณเนื้อหา โครงหลัก Qwen2.5 จำลองบริบท และหัว flow กู้คืนเสียง ตัวแปร z ต่อเนื่องไม่ใช่โทเค็นโคเดกแบบไม่ต่อเนื่อง
SOAR ที่ 32 ขั้นตอนและ MF ที่สี่ขั้นตอนเผยให้เห็นการแลกเปลี่ยนระหว่างคุณภาพกับความหน่วง ความคล้าย WER ความหน่วงเสียงแรก และปัจจัยเรียลไทม์เต็มรูปแบบต้องแยกกันไว้
บทความ โค้ด และน้ำหนักติดตามได้ผ่าน dots.tts / dots.tts-soar / Technical report
แต่ละแถวคงสถาปัตยกรรมต้นทาง เมตริก หรือนิยามงานของตนไว้ ผลลัพธ์ที่ไม่มีโปรโตคอลร่วมยังคงแยกจากกัน
| โมเดล | สถาปัตยกรรมหรือหลักฐาน | ขอบเขต |
|---|---|---|
| dots.tts | จุดตรวจสอบพื้นฐานแบบ continuous-flow | เนื้อหา ทิมเบอร์ และความสม่ำเสมอในเสียงยาว |
| dots.tts-soar | โมเดลโดเมนเปิด/การอนุมาน | ความเสถียรและความหน่วงภายใต้เสียงอ้างอิงเดียวกัน |
| autoregressive codec TTS | เส้นฐานแบบทีละโทเค็น | เสียงแรก การทำซ้ำ และการสะสมข้อผิดพลาด |
ตรวจตัวเลข ตัวย่อ คำหลายเสียง และช่วงหยุดทีละคำก่อนตัดสินความคล้าย คะแนนผู้พูดอาจพลาดการละคำและการทำซ้ำ ASR อาจพลาดเสียงรบกวนที่ถูกคัดลอกและสีของห้อง
เปรียบเทียบ SOAR กับตัวพื้นฐานด้วยข้อความและเสียงอ้างอิงที่เหมือนกัน บันทึกเวลาถึงเสียงแรก ปัจจัยเรียลไทม์ หน่วยความจำสูงสุด และความเสถียรของเสียงยาวแยกกัน แทนที่จะสรุประบบด้วยประโยคลื่นไหลเพียงประโยคเดียว
การกำหนดเงื่อนไขเสียงแบบ zero-shot ไม่ใช่ความยินยอมของผู้พูด การใช้งานสาธารณะต้องมีการอนุญาต ข้อจำกัดวัตถุประสงค์ และช่องทางถอนตัว
อารมณ์ สำเนียง และสภาพแวดล้อมอาจถูกคัดลอกไปพร้อมทิมเบอร์ โมเดลไม่สามารถรับประกันการแยกปัจจัยตัวตนที่บริสุทธิ์ออกมาได้
ชื่อโมเดล ตัวเลข และข้อจำกัดสืบย้อนไปถึงบทความ ที่เก็บโค้ด หรือการ์ดโมเดลด้านล่าง