মডেল
dots.tts: ক্রমাগত শাব্দিক সুপ্ত ভেরিয়েবল, ফ্লো ম্যাচিং, এবং 48 kHz দীর্ঘ-পরিসীমা বক্তৃতা
বক্তৃতা সংশ্লেষণ / কাগজপত্রের নিবিড় পঠন
বক্তৃতা সংশ্লেষণ / কাগজপত্রের নিবিড় পঠন
© 2026 টেলকনেট। সর্বস্বত্ব সংরক্ষিত।
স্পিচ সিন্থেসিস
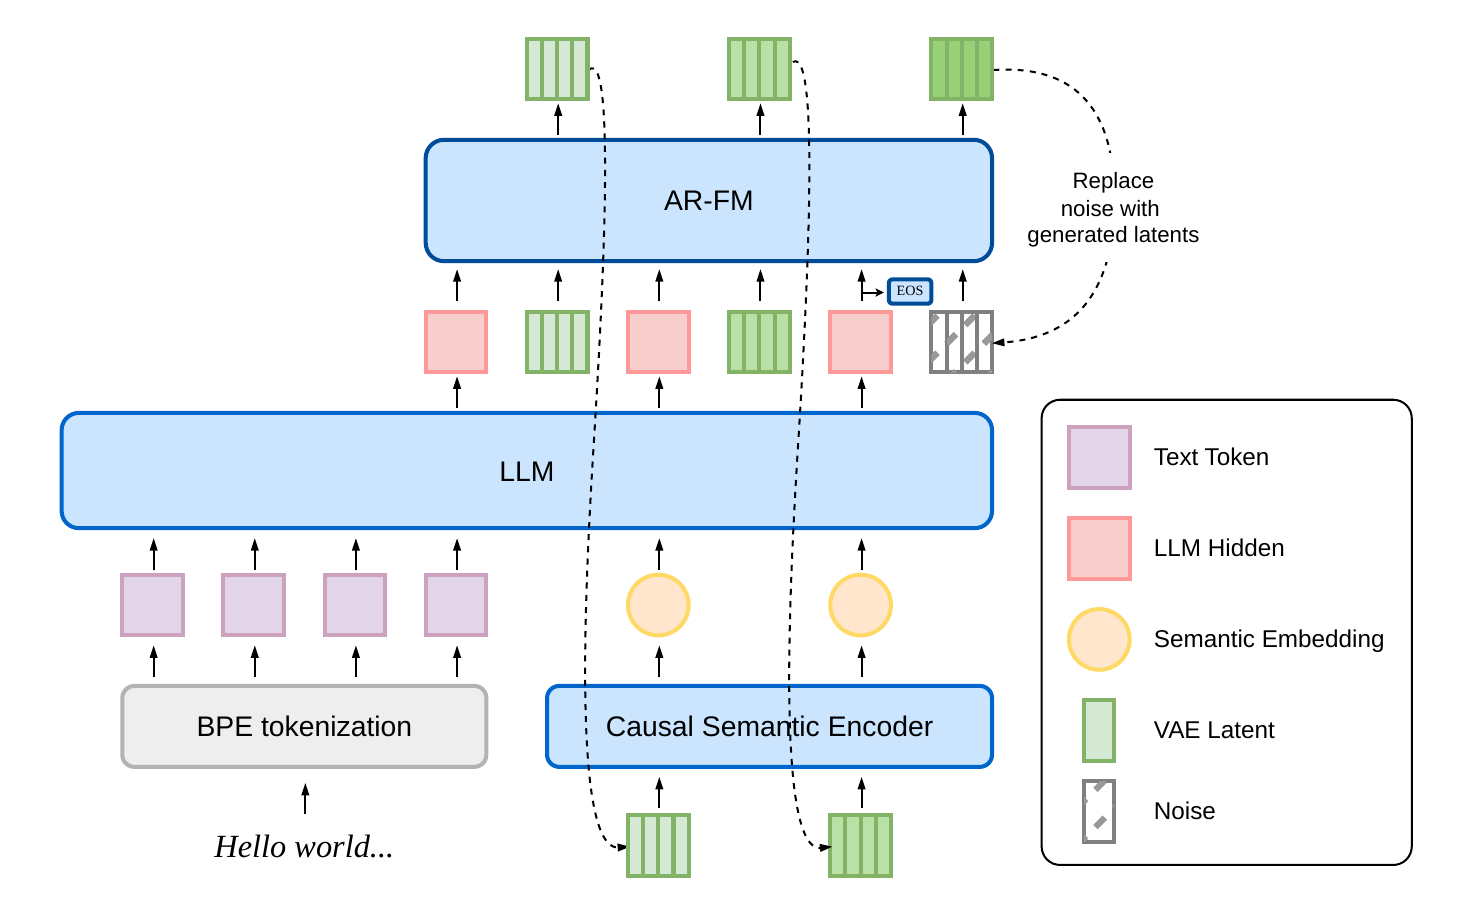
dots.tts স্পিচকে বিচ্ছিন্ন অডিও টোকেনে ভাঙে না। AudioVAE জোগায় ক্রমাগত লেটেন্ট, একটি সেমান্টিক এনকোডার তৈরি হওয়া প্যাচগুলো চেপে পৌঁছে দেয় ভাষা-ব্যাকবোনের কাছে, আর ফ্লো হেড অনুমান করে পরবর্তী অ্যাকুস্টিক ট্রাজেক্টরি।
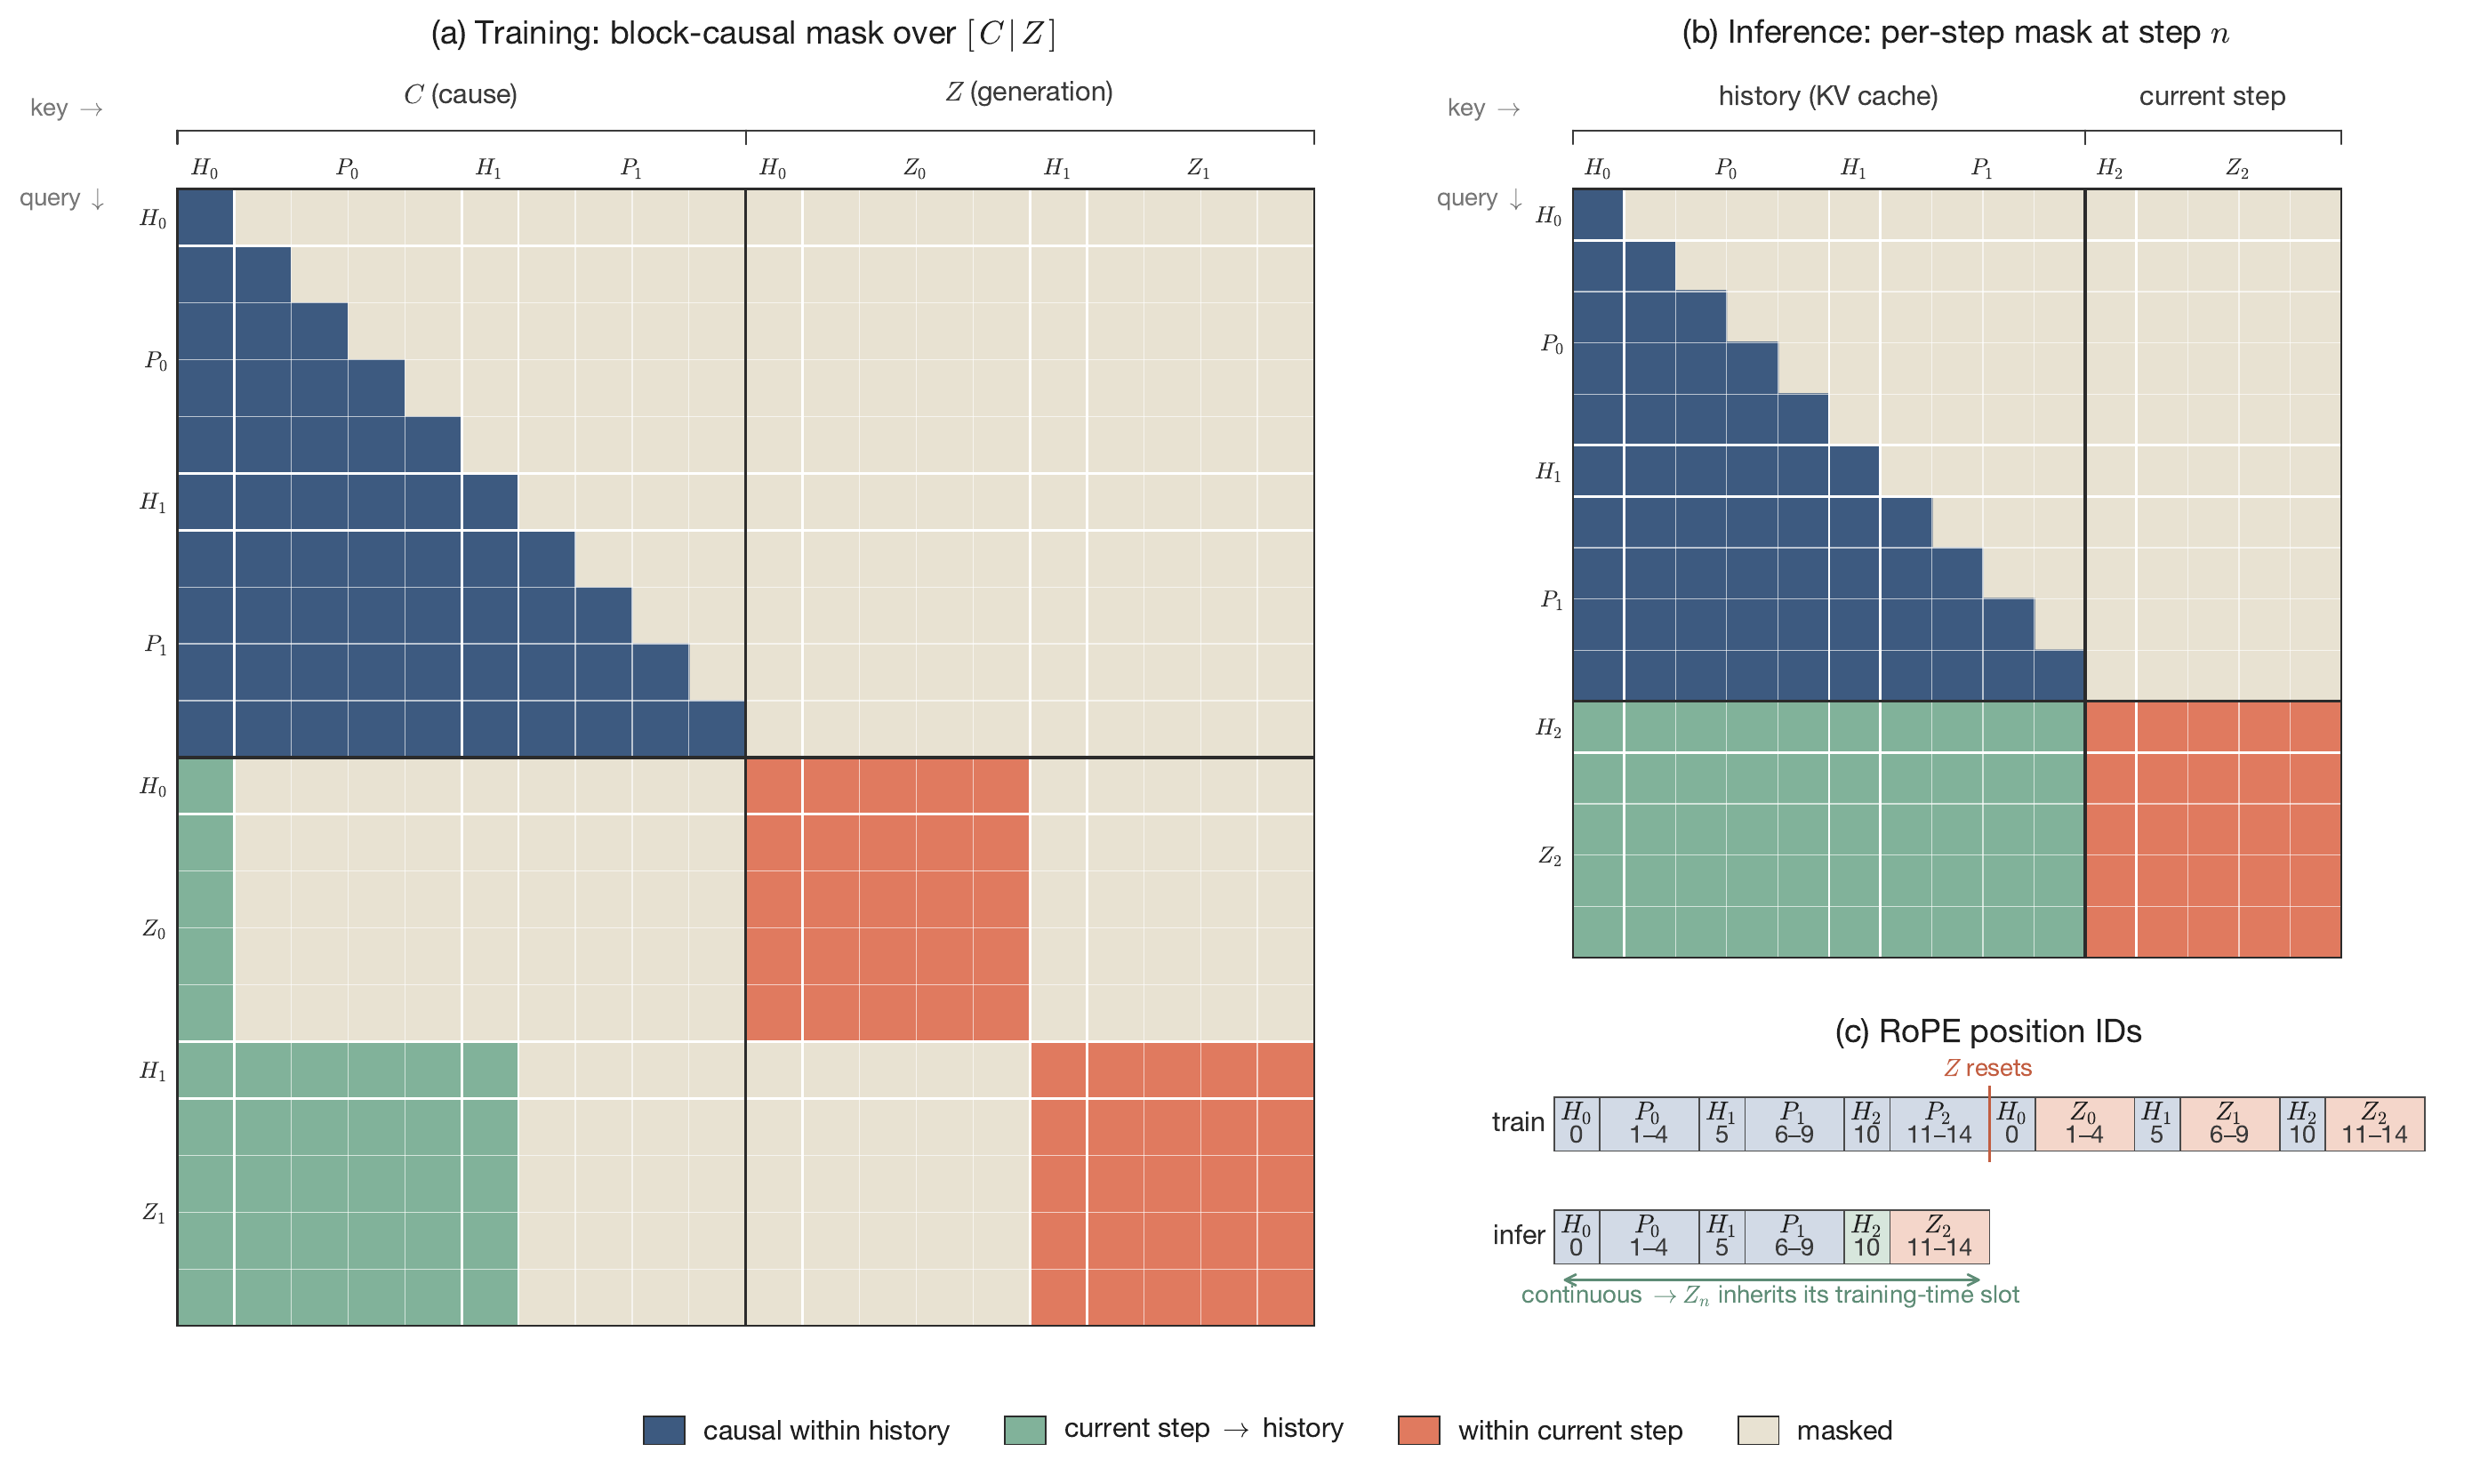
মডেলটি শেখে L=E||v_θ(x_t,t,h,s)-u_t||², শর্ত হিসেবে থাকে ভাষার হিডেন স্টেট h ও স্পিকারের তথ্য s। SOAR যোগ করে স্ব-সংশোধনমূলক অ্যালাইনমেন্ট; MF ট্রাজেক্টরিটাকে চারটি মূল্যায়নে ডিস্টিল করে।
অফিসিয়াল Seed-TTS-Eval টেবিলে প্রকাশিত তিনটি স্প্লিট জুড়ে SOAR-এর গড় SIM 79.2, আর চার-ধাপের MeanFlow মডেলের 78.2। SOAR স্ব-সংশোধনের সঙ্গে অ্যালাইনড; MeanFlow লম্বা টিচার ট্রাজেক্টরিকে চার-ধাপের স্টুডেন্টে ডিস্টিল করে, যা গতি ও অ্যাকুস্টিক ব্যর্থতার ধরন—দুটোই বদলে দেয়।
অফিসিয়াল ব্যবহার-নির্দেশিকায় ছোট, পরিষ্কার রেফারেন্সের পরামর্শ দেওয়া হয়েছে, যার ট্রান্সক্রিপ্ট রেকর্ডিংয়ের সঙ্গে মিলে যায়। সাধারণত দশ সেকেন্ডের মতোই যথেষ্ট; লম্বা প্রম্পট আপনাআপনি ক্লোনিং ভালো করে না। রেফারেন্স ছাড়া র্যান্ডম স্যাম্পলিং কোনো স্থায়ী চরিত্র-পরিচয় নয়।
dots.tts টেক্সট, স্পিকার রেফারেন্স ও অ্যাকুস্টিক প্রেক্ষাপটের ওপর শর্ত দিয়ে ক্রমাগত ফ্লো ম্যাচিং চালায়। dots.tts-soar ওপেন-ডোমেইন দৃঢ়তা ও ইনফারেন্স আচরণের জন্য প্রশিক্ষণ ও ওজন ঠিক করে। LongCat-AudioDiT-ও ক্রমাগত জেনারেশন ব্যবহার করে, তবে কাজ ও প্রোটোকল এক নয়।
স্পিচ সিন্থেসিস এগিয়েছে অ্যাকুস্টিক ফিচার আর ভোকোডার থেকে অটোরিগ্রেসিভ কোডেক টোকেন হয়ে ডিফিউশন ও ফ্লো ম্যাচিং পর্যন্ত। আসল পরিবর্তন ট্রাজেক্টরি আর কন্ডিশনিংয়ে, শুধু পুরোনো-থেকে-নতুন তকমায় নয়। ছোট একটা রেফারেন্স একসঙ্গে বয়ে আনে টিম্বার, উচ্চারণ, মাইক্রোফোন আর ঘরের শব্দ।
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tক্রমাগত অ্যাকুস্টিক লেটেন্টz_<tআগের অ্যাকুস্টিক প্রেক্ষাপটtextস্বাভাবিকীকৃত টেক্সট ও নিয়ন্ত্রণAudioVAE 48 kHz তরঙ্গরূপকে ক্রমাগত লেটেন্টে চাপে, সেমান্টিক পুনঃ-এনকোডিং কনটেন্টের সূত্র ফেরত আনে, Qwen2.5 ব্যাকবোন প্রেক্ষাপট মডেল করে, আর ফ্লো হেড অ্যাকুস্টিক পুনরুদ্ধার করে। ক্রমাগত z কোনো বিচ্ছিন্ন কোডেক টোকেন নয়।
৩২ ধাপে SOAR আর চার ধাপে MF মান-বিলম্বের এক ট্রেডঅফ উন্মোচন করে। সিমিলারিটি, WER, প্রথম-অডিও লেটেন্সি আর পূর্ণ রিয়েল-টাইম ফ্যাক্টর—এগুলো আলাদাই রাখতে হবে।
পেপার, কোড ও ওজন পাওয়া যাবে dots.tts / dots.tts-soar / Technical report-এ।
প্রতিটি সারিতে নিজস্ব আর্কিটেকচার, মেট্রিক বা কাজের সংজ্ঞা রক্ষা করা হয়েছে; ভাগ করা প্রোটোকল ছাড়া ফলাফল আলাদাই থাকে।
| মডেল | আর্কিটেকচার বা প্রমাণ | পরিধি |
|---|---|---|
| dots.tts | বেস ক্রমাগত-ফ্লো চেকপয়েন্ট | কনটেন্ট, টিম্বার ও দীর্ঘ অংশের ধারাবাহিকতা |
| dots.tts-soar | ওপেন-ডোমেইন/ইনফারেন্স মডেল | একই রেফারেন্সে স্থিতিশীলতা ও লেটেন্সি |
| অটোরিগ্রেসিভ কোডেক TTS | টোকেন-বাই-টোকেন বেসলাইন | প্রথম অডিও, পুনরাবৃত্তি ও ত্রুটি-সঞ্চয় |
সাদৃশ্য বিচারের আগে সংখ্যা, সংক্ষিপ্ত রূপ, বহু-উচ্চারণ শব্দ আর বিরতি শব্দে শব্দে যাচাই করুন। স্পিকার স্কোর বাদ পড়া বা পুনরাবৃত্তি ধরতে পারে না; ASR সঙ্গে-কপি হওয়া নয়েজ আর ঘরের আবহও ধরতে ব্যর্থ হতে পারে।
একই টেক্সট ও রেফারেন্সে SOAR আর বেস মডেল তুলনা করুন। প্রথম অডিও পর্যন্ত সময়, রিয়েল-টাইম ফ্যাক্টর, সর্বোচ্চ মেমরি আর দীর্ঘ-অংশের স্থিতিশীলতা আলাদাভাবে লিখে রাখুন—একটা সাবলীল বাক্য দিয়ে পুরো সিস্টেম সারসংক্ষেপ করবেন না।
জিরো-শট ভয়েস কন্ডিশনিং মানে স্পিকারের সম্মতি নয়। প্রকাশ্য ব্যবহারে চাই অনুমতি, উদ্দেশ্যের সীমা আর প্রত্যাহারের পথ।
টিম্বারের সঙ্গে আবেগ, উচ্চারণ আর পরিবেশও কপি হয়ে যেতে পারে; বিশুদ্ধ পরিচয়-উপাদান আলাদা করার নিশ্চয়তা মডেল দিতে পারে না।
মডেলের নাম, সংখ্যা ও সীমাবদ্ধতার উৎস নিচের পেপার, রিপোজিটরি বা মডেল কার্ডে পাওয়া যাবে।