Model
dots.tts: ciągłe utajone zmienne akustyczne, dopasowanie przepływu i mowa dalekiego zasięgu 48 kHz
Synteza mowy / Intensywne czytanie artykułów
Synteza mowy / Intensywne czytanie artykułów
© 2026 TelkNet. Wszelkie prawa zastrzeżone.
SYNTEZA MOWY
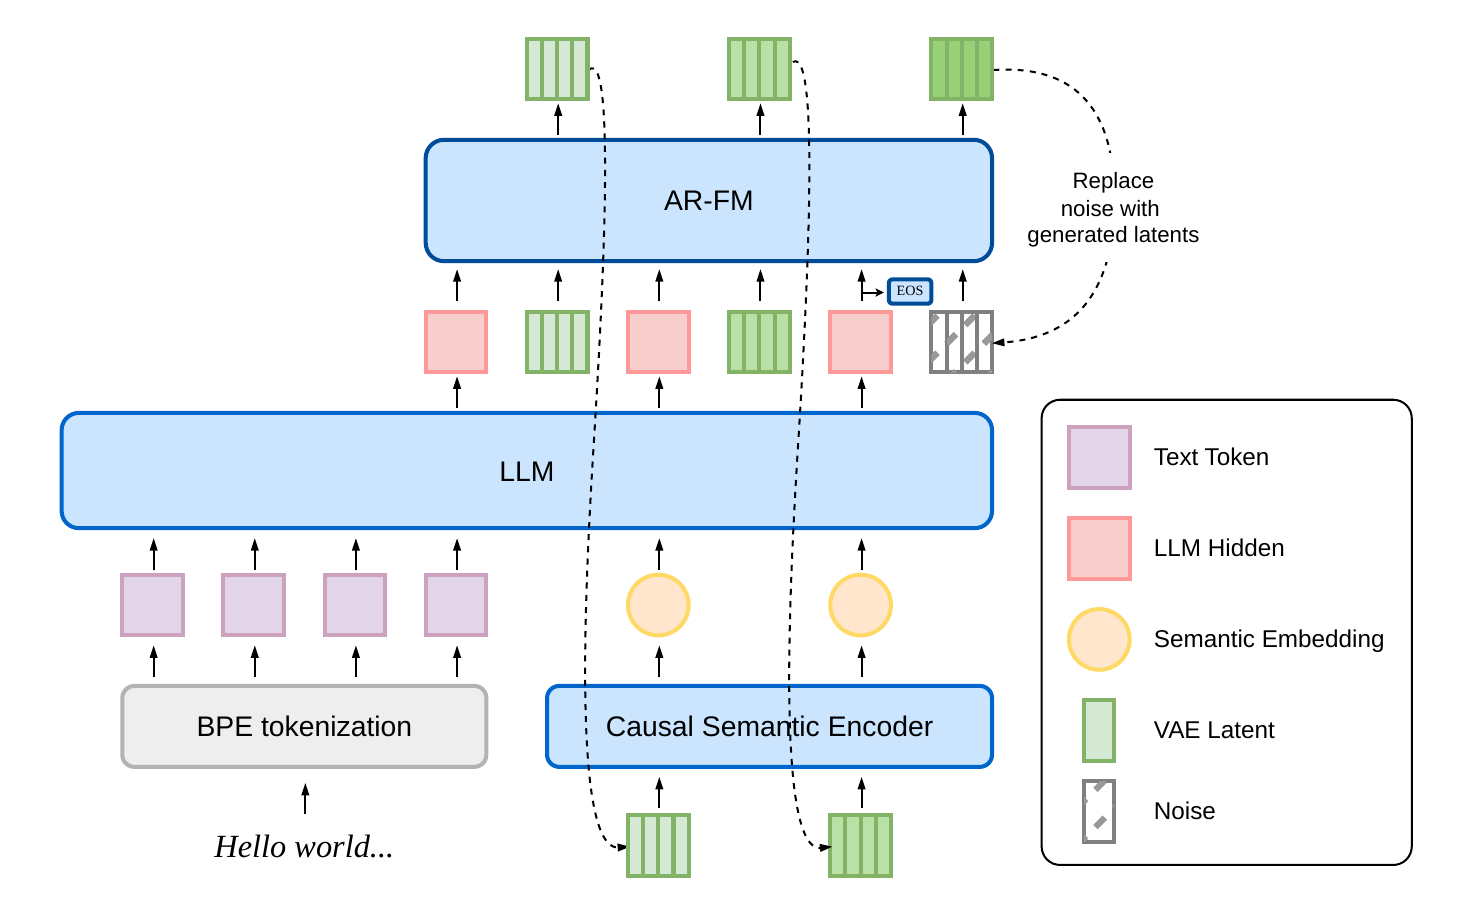
dots.tts nie sprowadza mowy do dyskretnych tokenów audio. AudioVAE dostarcza ciągłe zmienne ukryte, enkoder semantyczny kompresuje generowane fragmenty dla trzonu językowego, a głowica przepływowa przewiduje kolejną trajektorię akustyczną.
Model uczy się funkcji L=E||v_θ(x_t,t,h,s)-u_t||², uwarunkowanej stanem ukrytym modelu językowego h oraz informacją o mówcy s. SOAR dodaje samokorygujące wyrównanie; MF destyluje trajektorię do czterech ewaluacji.
Oficjalna tabela Seed-TTS-Eval daje SOAR średnio 79.2 SIM na trzech opublikowanych podziałach, a czterokrokowemu modelowi MeanFlow 78.2. SOAR jest samokorygująco wyrównany; MeanFlow destyluje dłuższą trajektorię nauczyciela do czterokrokowego ucznia, co zmienia zarówno szybkość, jak i charakter błędów akustycznych.
Oficjalne wskazówki zalecają krótką, czystą referencję, której transkrypcja zgadza się z nagraniem. Zwykle wystarcza około dziesięciu sekund; dłuższe podpowiedzi nie poprawiają automatycznie klonowania. Losowe próbkowanie bez referencji nie daje trwałej tożsamości głosu.
dots.tts uwarunkowuje ciągłe dopasowanie przepływu tekstem, referencją mówcy i kontekstem akustycznym. dots.tts-soar dostosowuje trening i wagi pod kątem odporności w otwartej domenie oraz zachowania w inferencji. LongCat-AudioDiT również korzysta z ciągłej generacji, ale to nie to samo zadanie ani protokół.
Synteza mowy przeszła od cech akustycznych z wokoderami, przez autoregresyjne tokeny kodekowe, do dyfuzji i dopasowania przepływu. Istotna zmiana dotyczy trajektorii i uwarunkowania, a nie prostej etykiety „stare na nowe". Krótka referencja niesie razem barwę, akcent, mikrofon i pomieszczenie.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tciągła zmienna ukryta akustykiz_<twcześniejszy kontekst akustycznytextznormalizowany tekst i sterowanieAudioVAE kompresuje przebiegi 48 kHz do ciągłych zmiennych ukrytych, semantyczne ponowne kodowanie przywraca wskazówki treściowe, trzon Qwen2.5 modeluje kontekst, a głowica przepływowa odtwarza akustykę. Ciągłe z nie jest dyskretnym tokenem kodekowym.
SOAR przy 32 krokach i MF przy czterech krokach obnażają kompromis między jakością a opóźnieniem. Podobieństwo, WER, opóźnienie pierwszego dźwięku i pełny współczynnik czasu rzeczywistego muszą pozostać rozdzielne.
Pracę, kod i wagi można śledzić przez dots.tts / dots.tts-soar / Technical report.
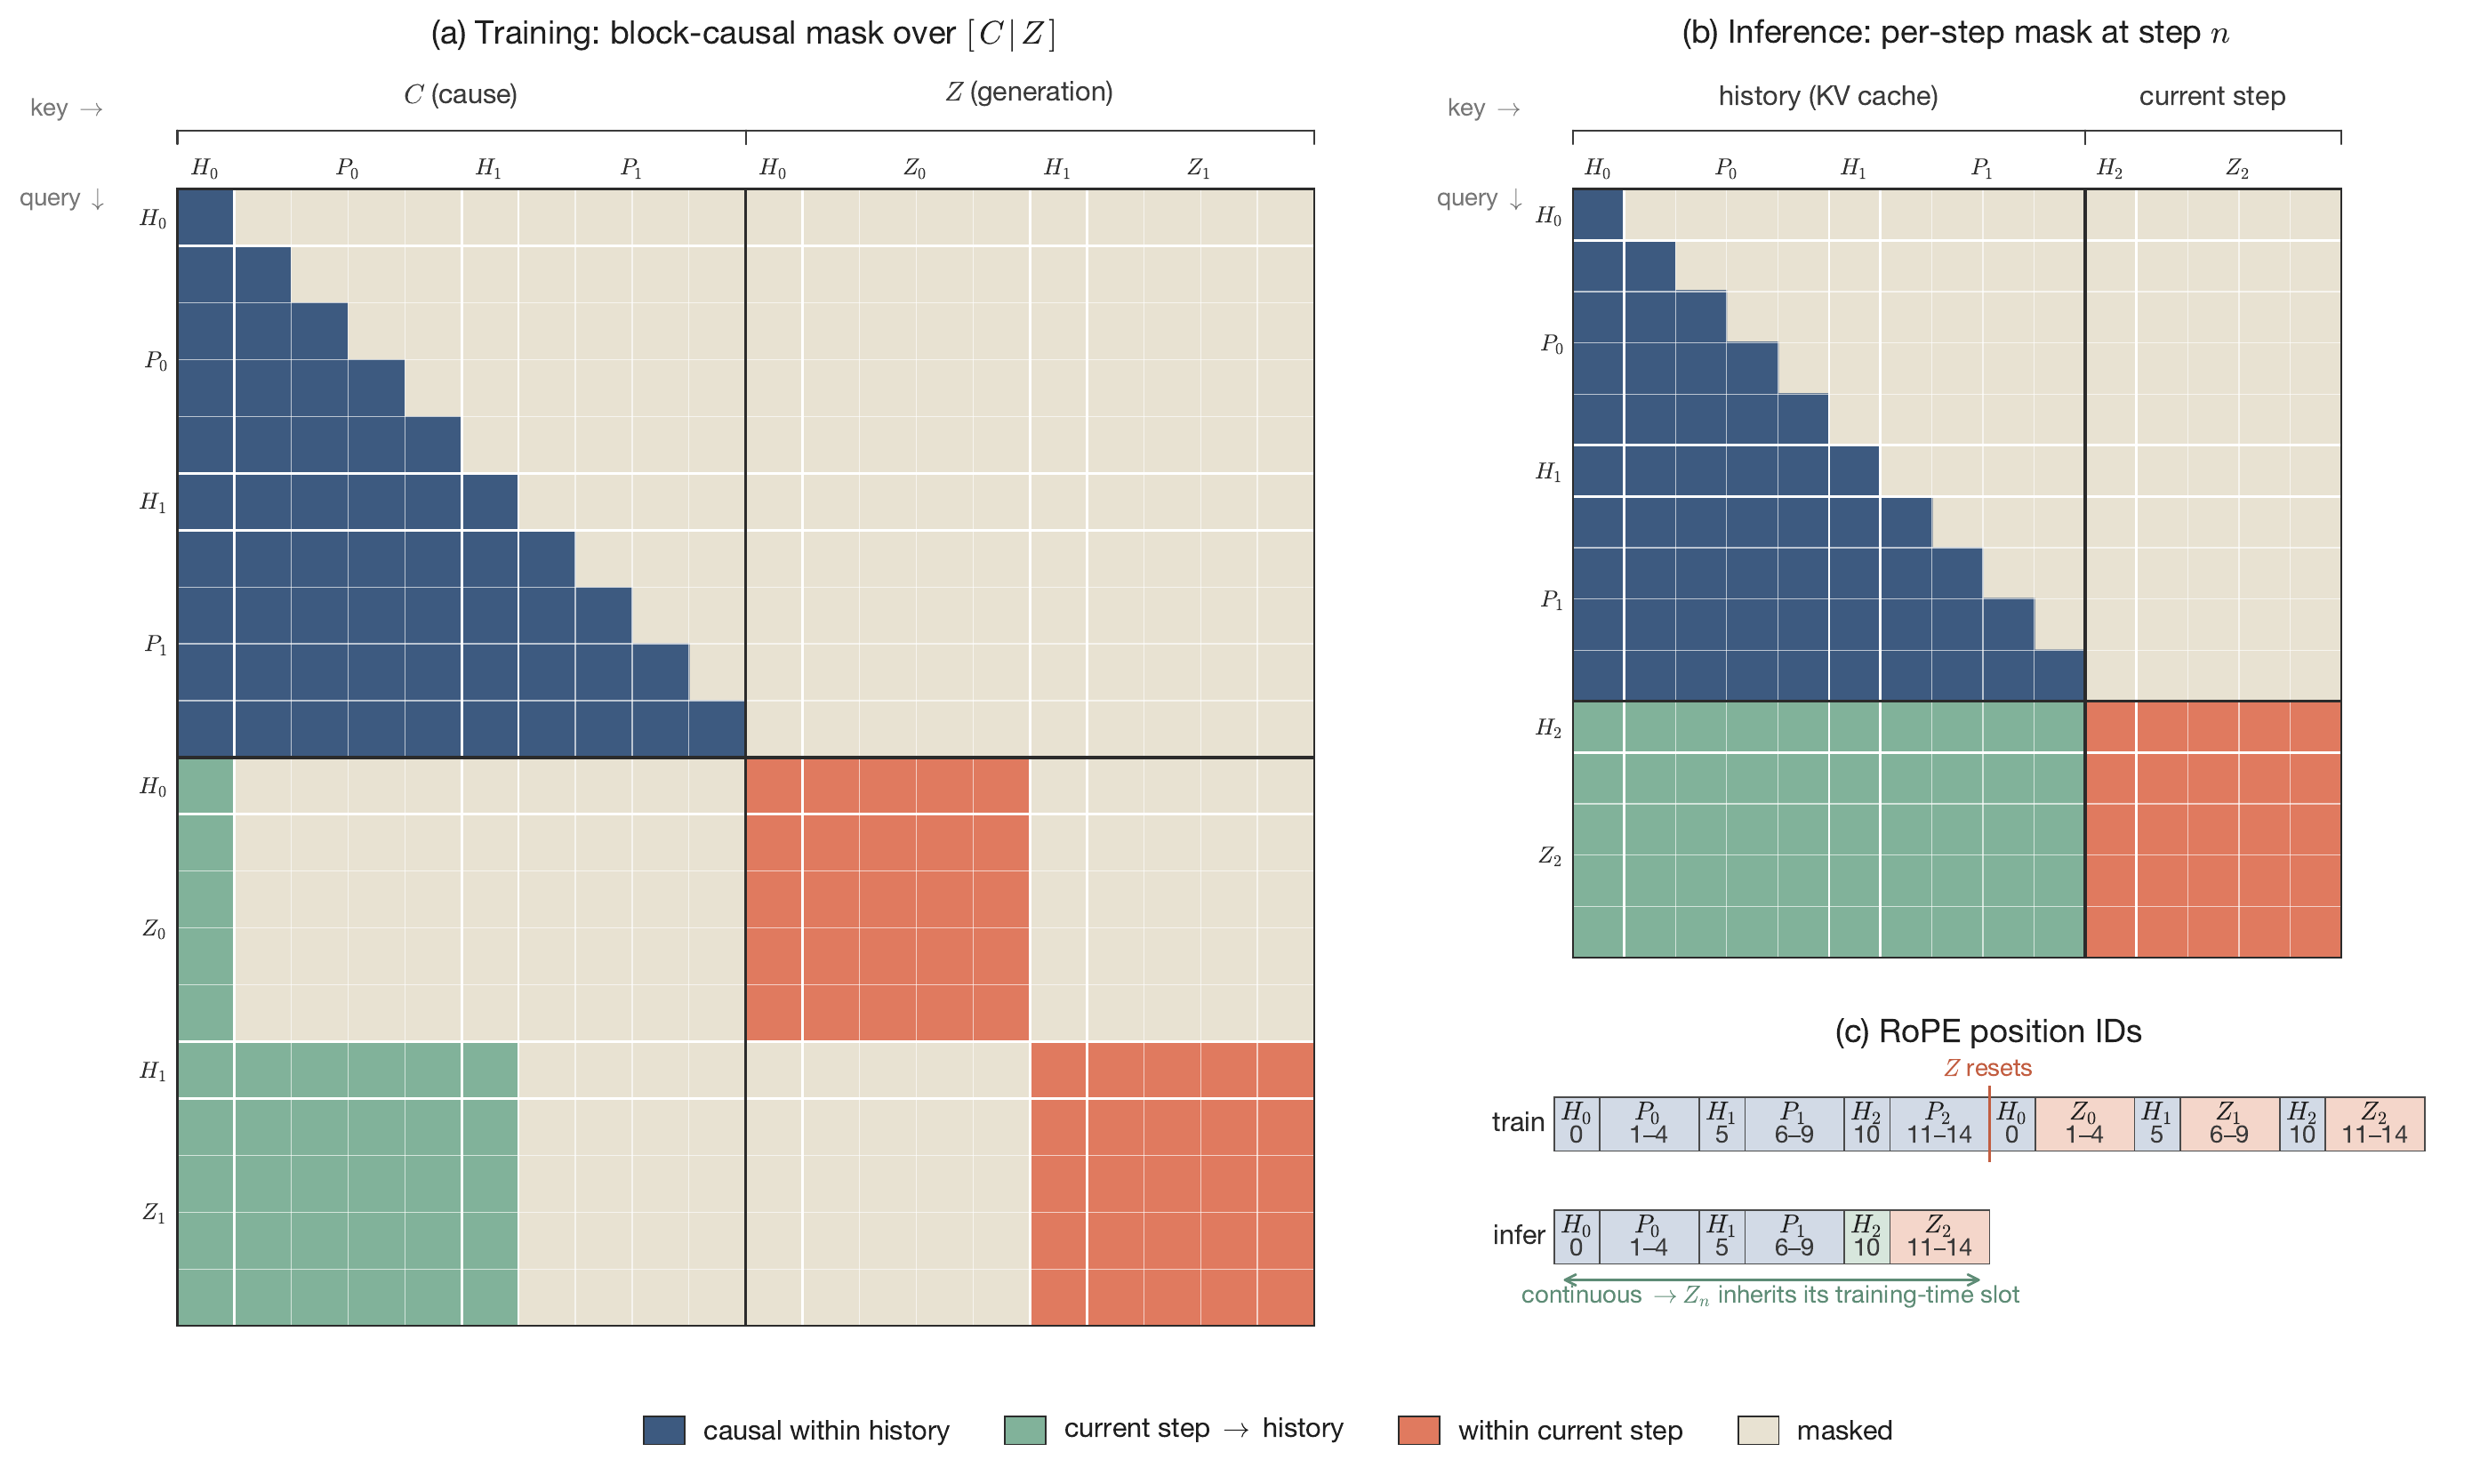
Każdy wiersz zachowuje własną architekturę źródłową, metrykę lub definicję zadania; wyniki bez wspólnego protokołu pozostają rozdzielne.
| Model | Architektura lub dowód | Zakres |
|---|---|---|
| dots.tts | bazowy punkt kontrolny ciągłego przepływu | treść, barwa i spójność długich form |
| dots.tts-soar | model otwartej domeny / inferencji | stabilność i opóźnienie przy tej samej referencji |
| autoregresyjne TTS kodekowe | linia bazowa token po tokenie | pierwszy dźwięk, powtórzenia i kumulacja błędów |
Zanim ocenisz podobieństwo, sprawdź słowo po słowie liczby, skróty, wyrazy wieloznaczne i pauzy. Wyniki podobieństwa mówców mogą przeoczyć pominięcia i powtórzenia; ASR może nie wychwycić skopiowanego szumu i barwy pomieszczenia.
Porównuj SOAR i wersję bazową na identycznym tekście i referencji. Czas do pierwszego dźwięku, współczynnik czasu rzeczywistego, szczytowe zużycie pamięci i stabilność długich form rejestruj osobno, zamiast podsumowywać system jednym płynnym zdaniem.
Zero-shotowe uwarunkowanie głosem nie jest zgodą mówcy. Publiczne użycie wymaga zgody, ograniczeń celu i drogi wycofania.
Emocje, akcent i otoczenie mogą zostać skopiowane razem z barwą; model nie gwarantuje wyodrębnienia czystego czynnika tożsamości.
Nazwy modeli, liczby i ograniczenia prowadzą do prac, repozytoriów lub kart modeli poniżej.