Модель
dots.tts: непрерывные акустические скрытые переменные, согласование потока и речь на большом расстоянии 48 кГц.
Синтез речи/Интенсивное чтение статей
Синтез речи/Интенсивное чтение статей
© 2026 TelkNet. Все права защищены.
СИНТЕЗ РЕЧИ
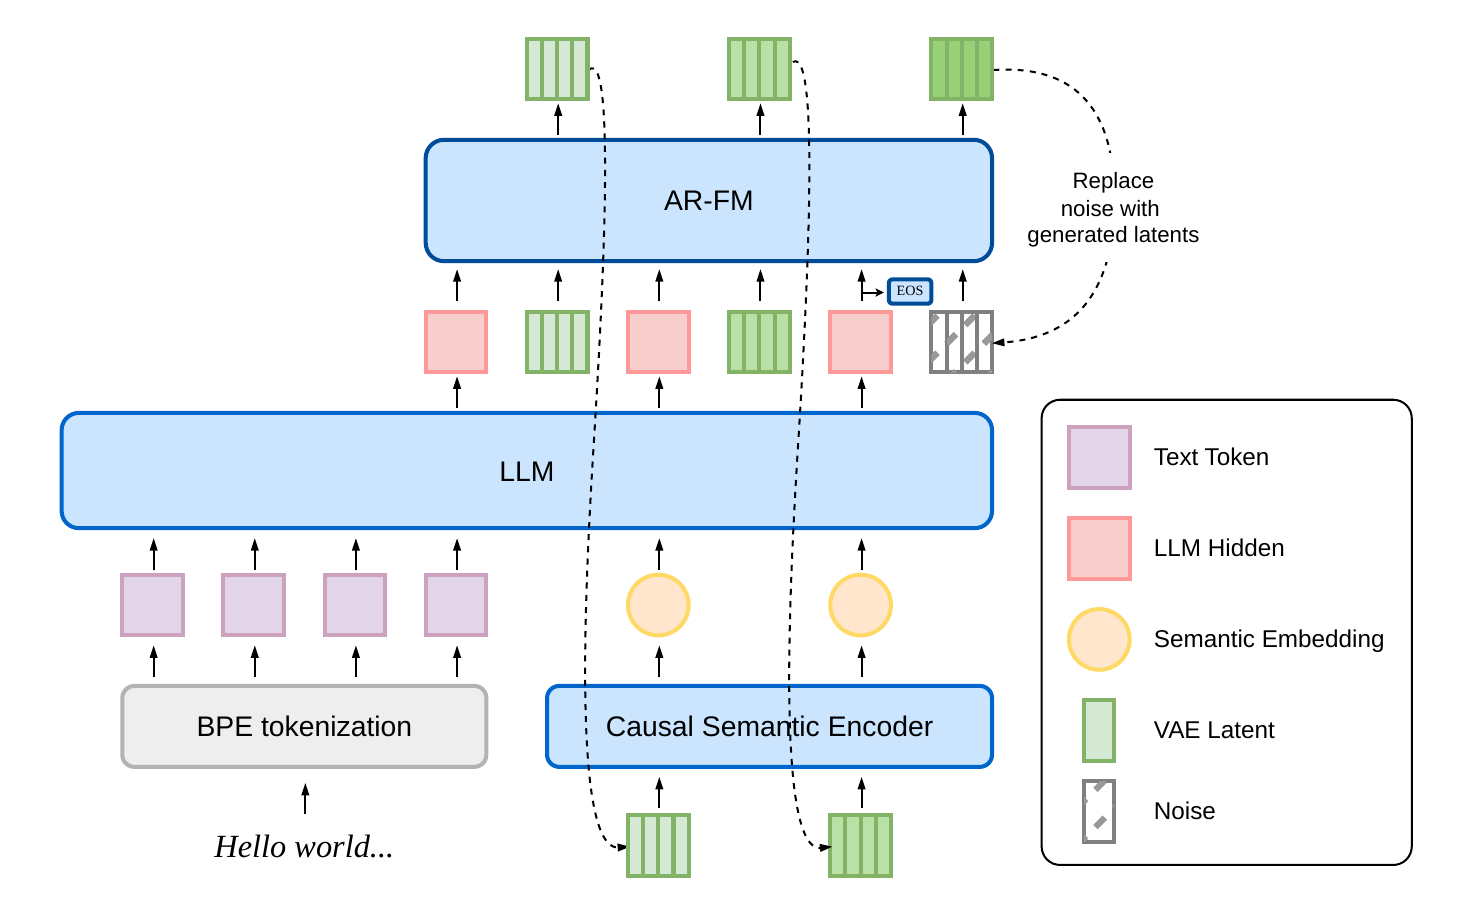
dots.tts не сводит речь к дискретным аудиотокенам. AudioVAE выдаёт непрерывные латенты, семантический кодировщик сжимает сгенерированные патчи для языковой основы, а потоковая голова предсказывает следующую акустическую траекторию.
Модель обучается на L=E||v_θ(x_t,t,h,s)-u_t||² с условием на скрытое состояние языковой модели h и информацию о дикторе s. SOAR добавляет самокорректирующее выравнивание; MF дистиллирует траекторию до четырёх вычислений.
В официальной таблице Seed-TTS-Eval у SOAR средний SIM 79.2 по трём опубликованным разбиениям, а у четырёхшаговой модели MeanFlow — 78.2. SOAR выровнен самокоррекцией; MeanFlow дистиллирует длинную траекторию учителя в четырёхшагового ученика, меняя и скорость, и характер акустических сбоев.
Официальные заметки по применению советуют короткий чистый референс, чья расшифровка совпадает с записью. Обычно хватает примерно десяти секунд; более длинные подсказки сами по себе клонирование не улучшают. Случайная выборка без референса — не постоянная голосовая личность.
dots.tts обусловливает непрерывное сопоставление потоков текстом, референсом диктора и акустическим контекстом. dots.tts-soar корректирует обучение и веса ради устойчивости в открытой области и поведения на выводе. LongCat-AudioDiT тоже работает с непрерывной генерацией, но это другая задача и другой протокол.
Синтез речи прошёл путь от акустических признаков с вокодерами через авторегрессионные токены кодека к диффузии и сопоставлению потоков. Главное здесь — изменение траектории и условий, а не простая метка «старое вместо нового». Короткий референс несёт тембр, акцент, микрофон и комнату одновременно.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tнепрерывный акустический латентz_<tпредыдущий акустический контекстtextнормализованный текст и управляющие сигналыAudioVAE сжимает волновые формы 48 кГц в непрерывные латенты, семантическое перекодирование возвращает содержательные признаки, основа Qwen2.5 моделирует контекст, а потоковая голова восстанавливает акустику. Непрерывный z — не дискретный токен кодека.
SOAR на 32 шагах и MF на четырёх шагах показывают компромисс между качеством и задержкой. Сходство, WER, задержку первого аудио и полный коэффициент реального времени нужно держать раздельно.
Статью, код и веса можно отследить через dots.tts / dots.tts-soar / Technical report.
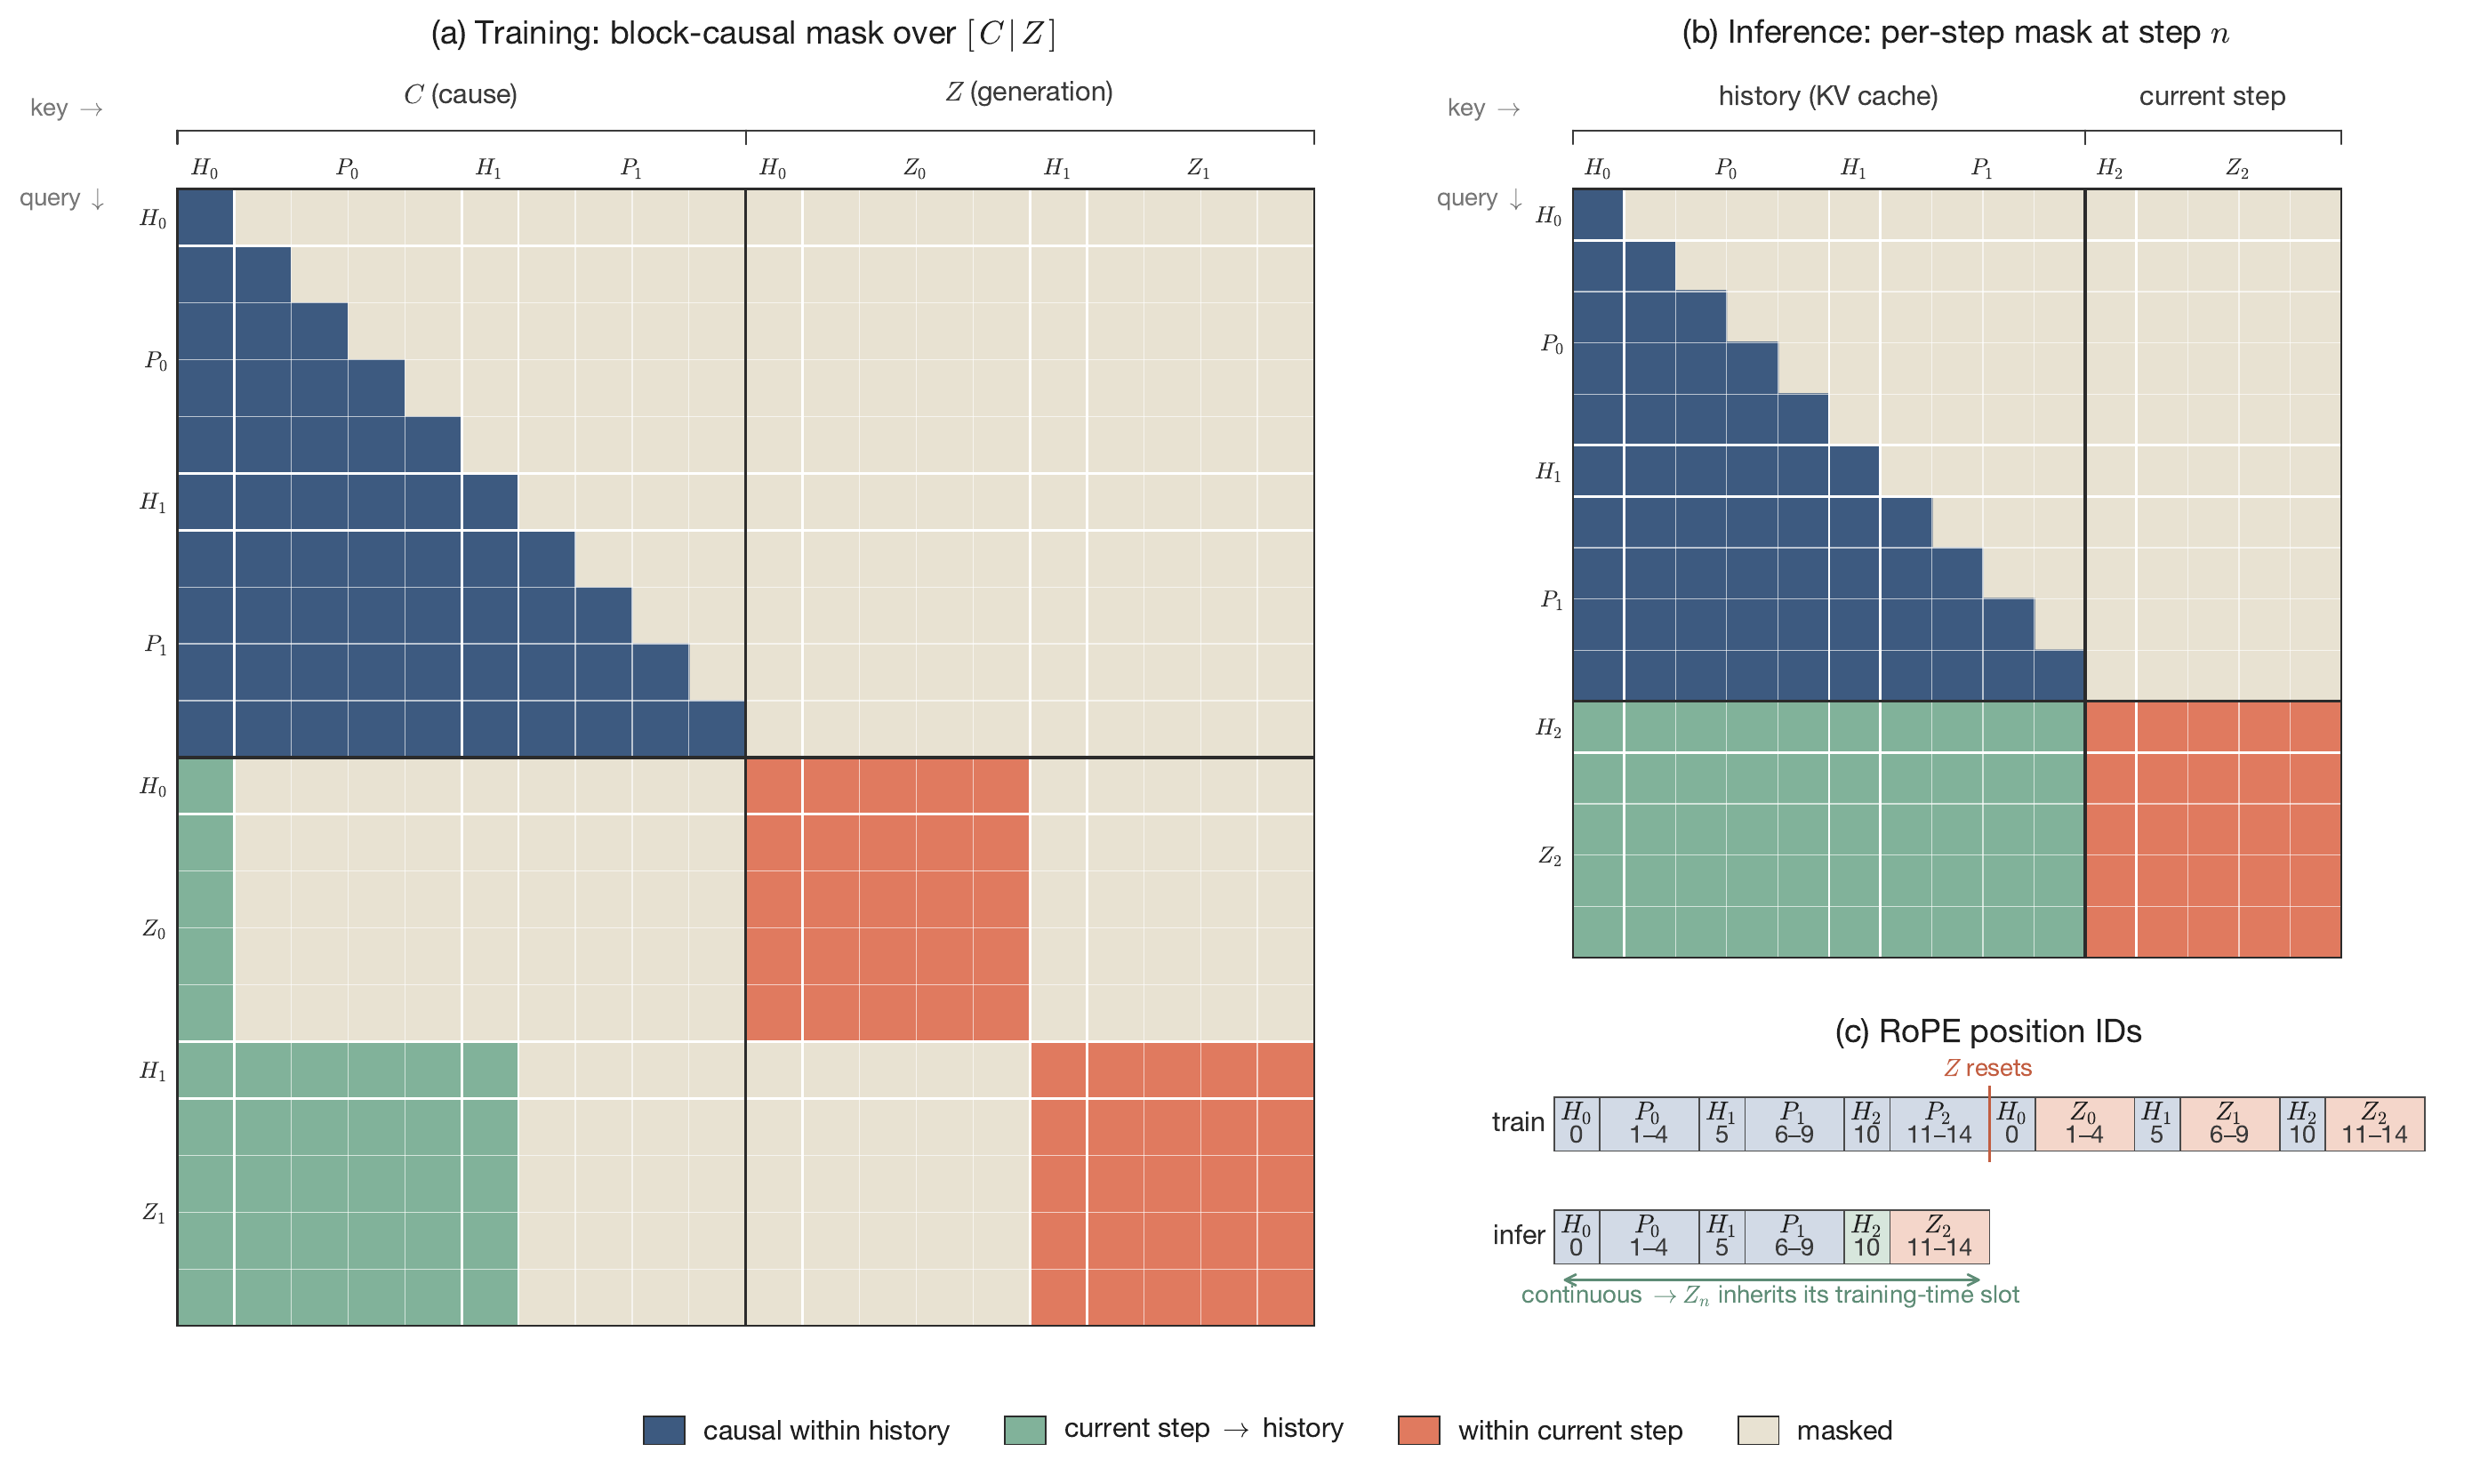
Каждая строка сохраняет исходную архитектуру, метрику или определение задачи; результаты без общего протокола остаются раздельными.
| Модель | Архитектура или свидетельства | Охват |
|---|---|---|
| dots.tts | базовый чекпоинт непрерывного потока | содержание, тембр и связность длинных форм |
| dots.tts-soar | модель для открытой области и вывода | стабильность и задержка при том же референсе |
| авторегрессионный кодек-TTS | базовая линия «токен за токеном» | первое аудио, повторы и накопление ошибок |
Числа, сокращения, омофоны и паузы проверяйте слово за словом ещё до суждения о сходстве. Оценки диктора могут пропустить выпадения и повторы; ASR может не заметить скопированный шум и окраску комнаты.
Сравнивайте SOAR и базовую модель на одинаковом тексте и референсе. Время до первого аудио, коэффициент реального времени, пиковую память и стабильность на длинных формах записывайте раздельно, а не сводите систему к одному беглому предложению.
Zero-shot обусловливание голосом — не согласие диктора. Публичному использованию нужны разрешение, ограничения целей и путь к отзыву.
Эмоцию, акцент и среду можно скопировать вместе с тембром; модель не гарантирует выделение чистого фактора личности.
Названия моделей, числа и ограничения прослеживаются к статьям, репозиториям или карточкам моделей ниже.