نموذج
dots.tts: المتغيرات الصوتية الكامنة المستمرة، ومطابقة التدفق، والكلام بعيد المدى بتردد 48 كيلو هرتز
تركيب الكلام / القراءة المكثفة للأوراق
تركيب الكلام / القراءة المكثفة للأوراق
© 2026 تيلك نت. جميع الحقوق محفوظة.
تركيب الكلام
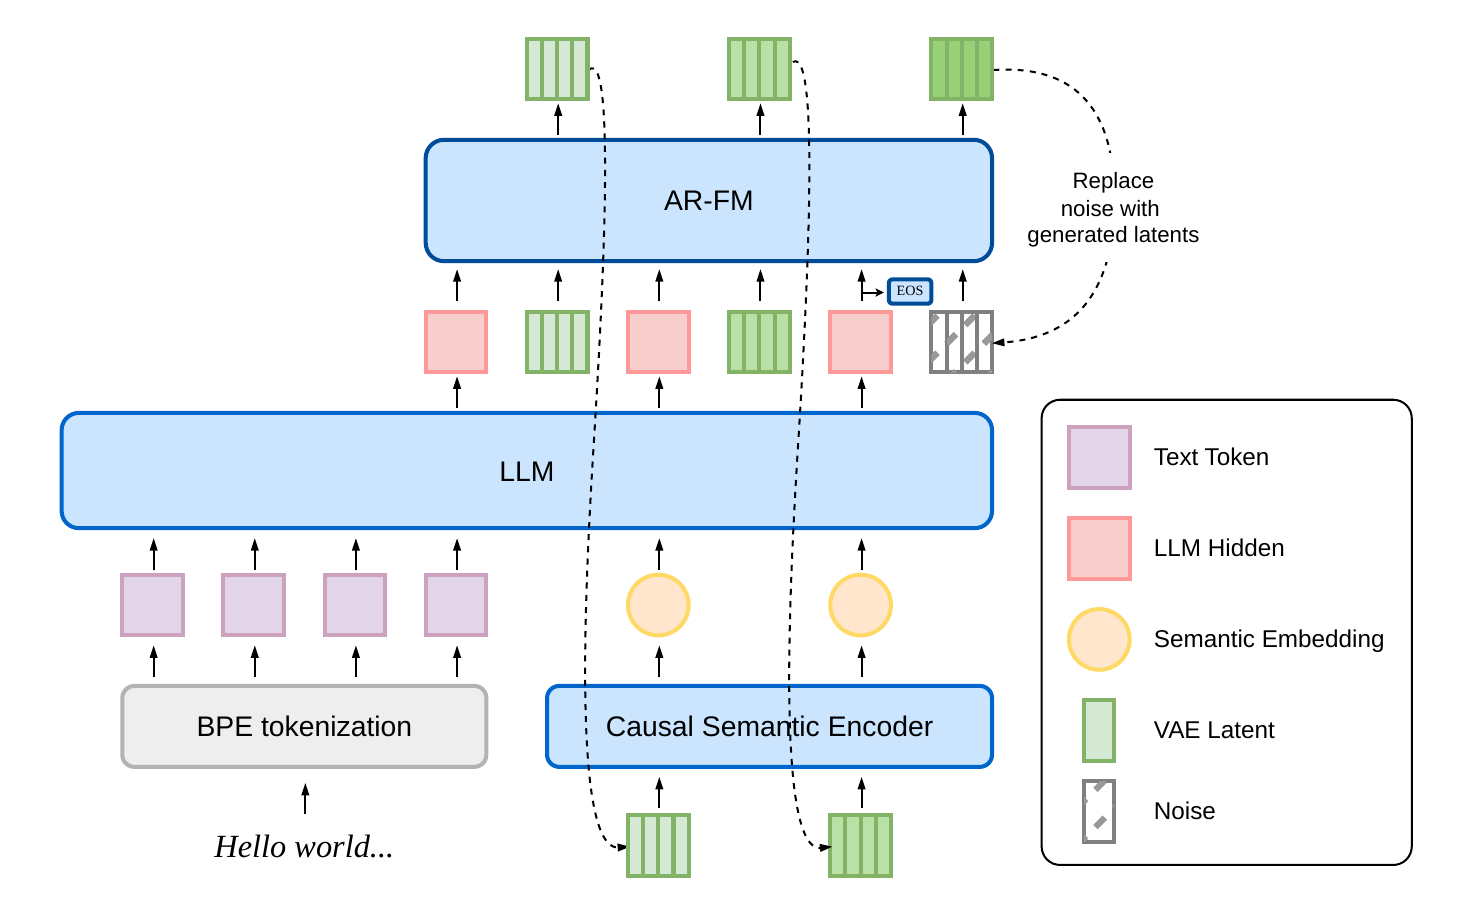
لا يختزل dots.tts الكلام إلى وحدات صوتية منفصلة. يوفّر AudioVAE متغيرات كامنة مستمرة، ويضغط مُرمِّز دلالي الرقع المولَّدة لصالح العمود الفقري اللغوي، بينما يتنبأ رأس التدفق بالمسار الصوتي التالي.
يتعلم النموذج L=E||v_θ(x_t,t,h,s)-u_t||² بشرط الحالة الخفية اللغوية h ومعلومات المتحدث s. ويضيف SOAR محاذاة ذاتية التصحيح، بينما يقطّر MF المسار إلى أربعة تقييمات.
يمنح الجدول الرسمي في Seed-TTS-Eval نموذج SOAR متوسط SIM قدره 79.2 عبر التقسيمات الثلاثة المنشورة، ونموذج MeanFlow رباعي الخطوات 78.2. يعتمد SOAR على محاذاة ذاتية التصحيح؛ أما MeanFlow فيقطّر مسار معلّم أطول إلى طالب من أربع خطوات، فيغيّر معاً السرعة وأنماط الفشل الصوتي.
توصي ملاحظات الاستخدام الرسمية بمرجع قصير ونظيف يطابق نصُّه التسجيل. تكفي عشر ثوانٍ تقريباً في الحالات العادية؛ فالمحفزات الأطول لا تحسّن الاستنساخ تلقائياً. والعينات العشوائية دون مرجع ليست هوية شخصية ثابتة.
يشترط dots.tts مطابقة التدفق المستمرة على النص ومرجع المتحدث والسياق الصوتي. ويعدّل dots.tts-soar التدريب والأوزان من أجل متانة المجال المفتوح وسلوك الاستدلال. يستخدم LongCat-AudioDiT التوليد المستمر أيضاً، لكنه ليس المهمة نفسها ولا البروتوكول ذاته.
انتقل تركيب الكلام من الخصائص الصوتية مع المشفرات الصوتية عبر وحدات الترميز تلقائية الانحدار إلى الانتشار ومطابقة التدفق. التغيير المهم هو المسار والاشتراط، لا مجرد وسم بسيط من قديم إلى جديد. والمرجع القصير يحمل معاً الطابع الصوتي واللهجة والميكروفون والغرفة.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tمتغير كامن صوتي مستمرz_<tالسياق الصوتي السابقtextالنص المُطبَّع وعناصر التحكميضغط AudioVAE الموجات الصوتية بمعدل 48 kHz إلى متغيرات كامنة مستمرة، وتستعيد إعادة الترميز الدلالية إشارات المحتوى، وينمذج العمود الفقري Qwen2.5 السياق، ويستعيد رأس التدفق الصوتيات. المتغير z المستمر ليس وحدة ترميز منفصلة.
يكشف SOAR عند 32 خطوة وMF عند أربع خطوات عن مفاضلة بين الجودة والزمن. يجب أن تبقى مقاييس التشابه وWER وزمن أول صوت وعامل الزمن الحقيقي الكامل منفصلة.
يمكن تتبع الورقة والشيفرة والأوزان عبر dots.tts / dots.tts-soar / التقرير التقني.
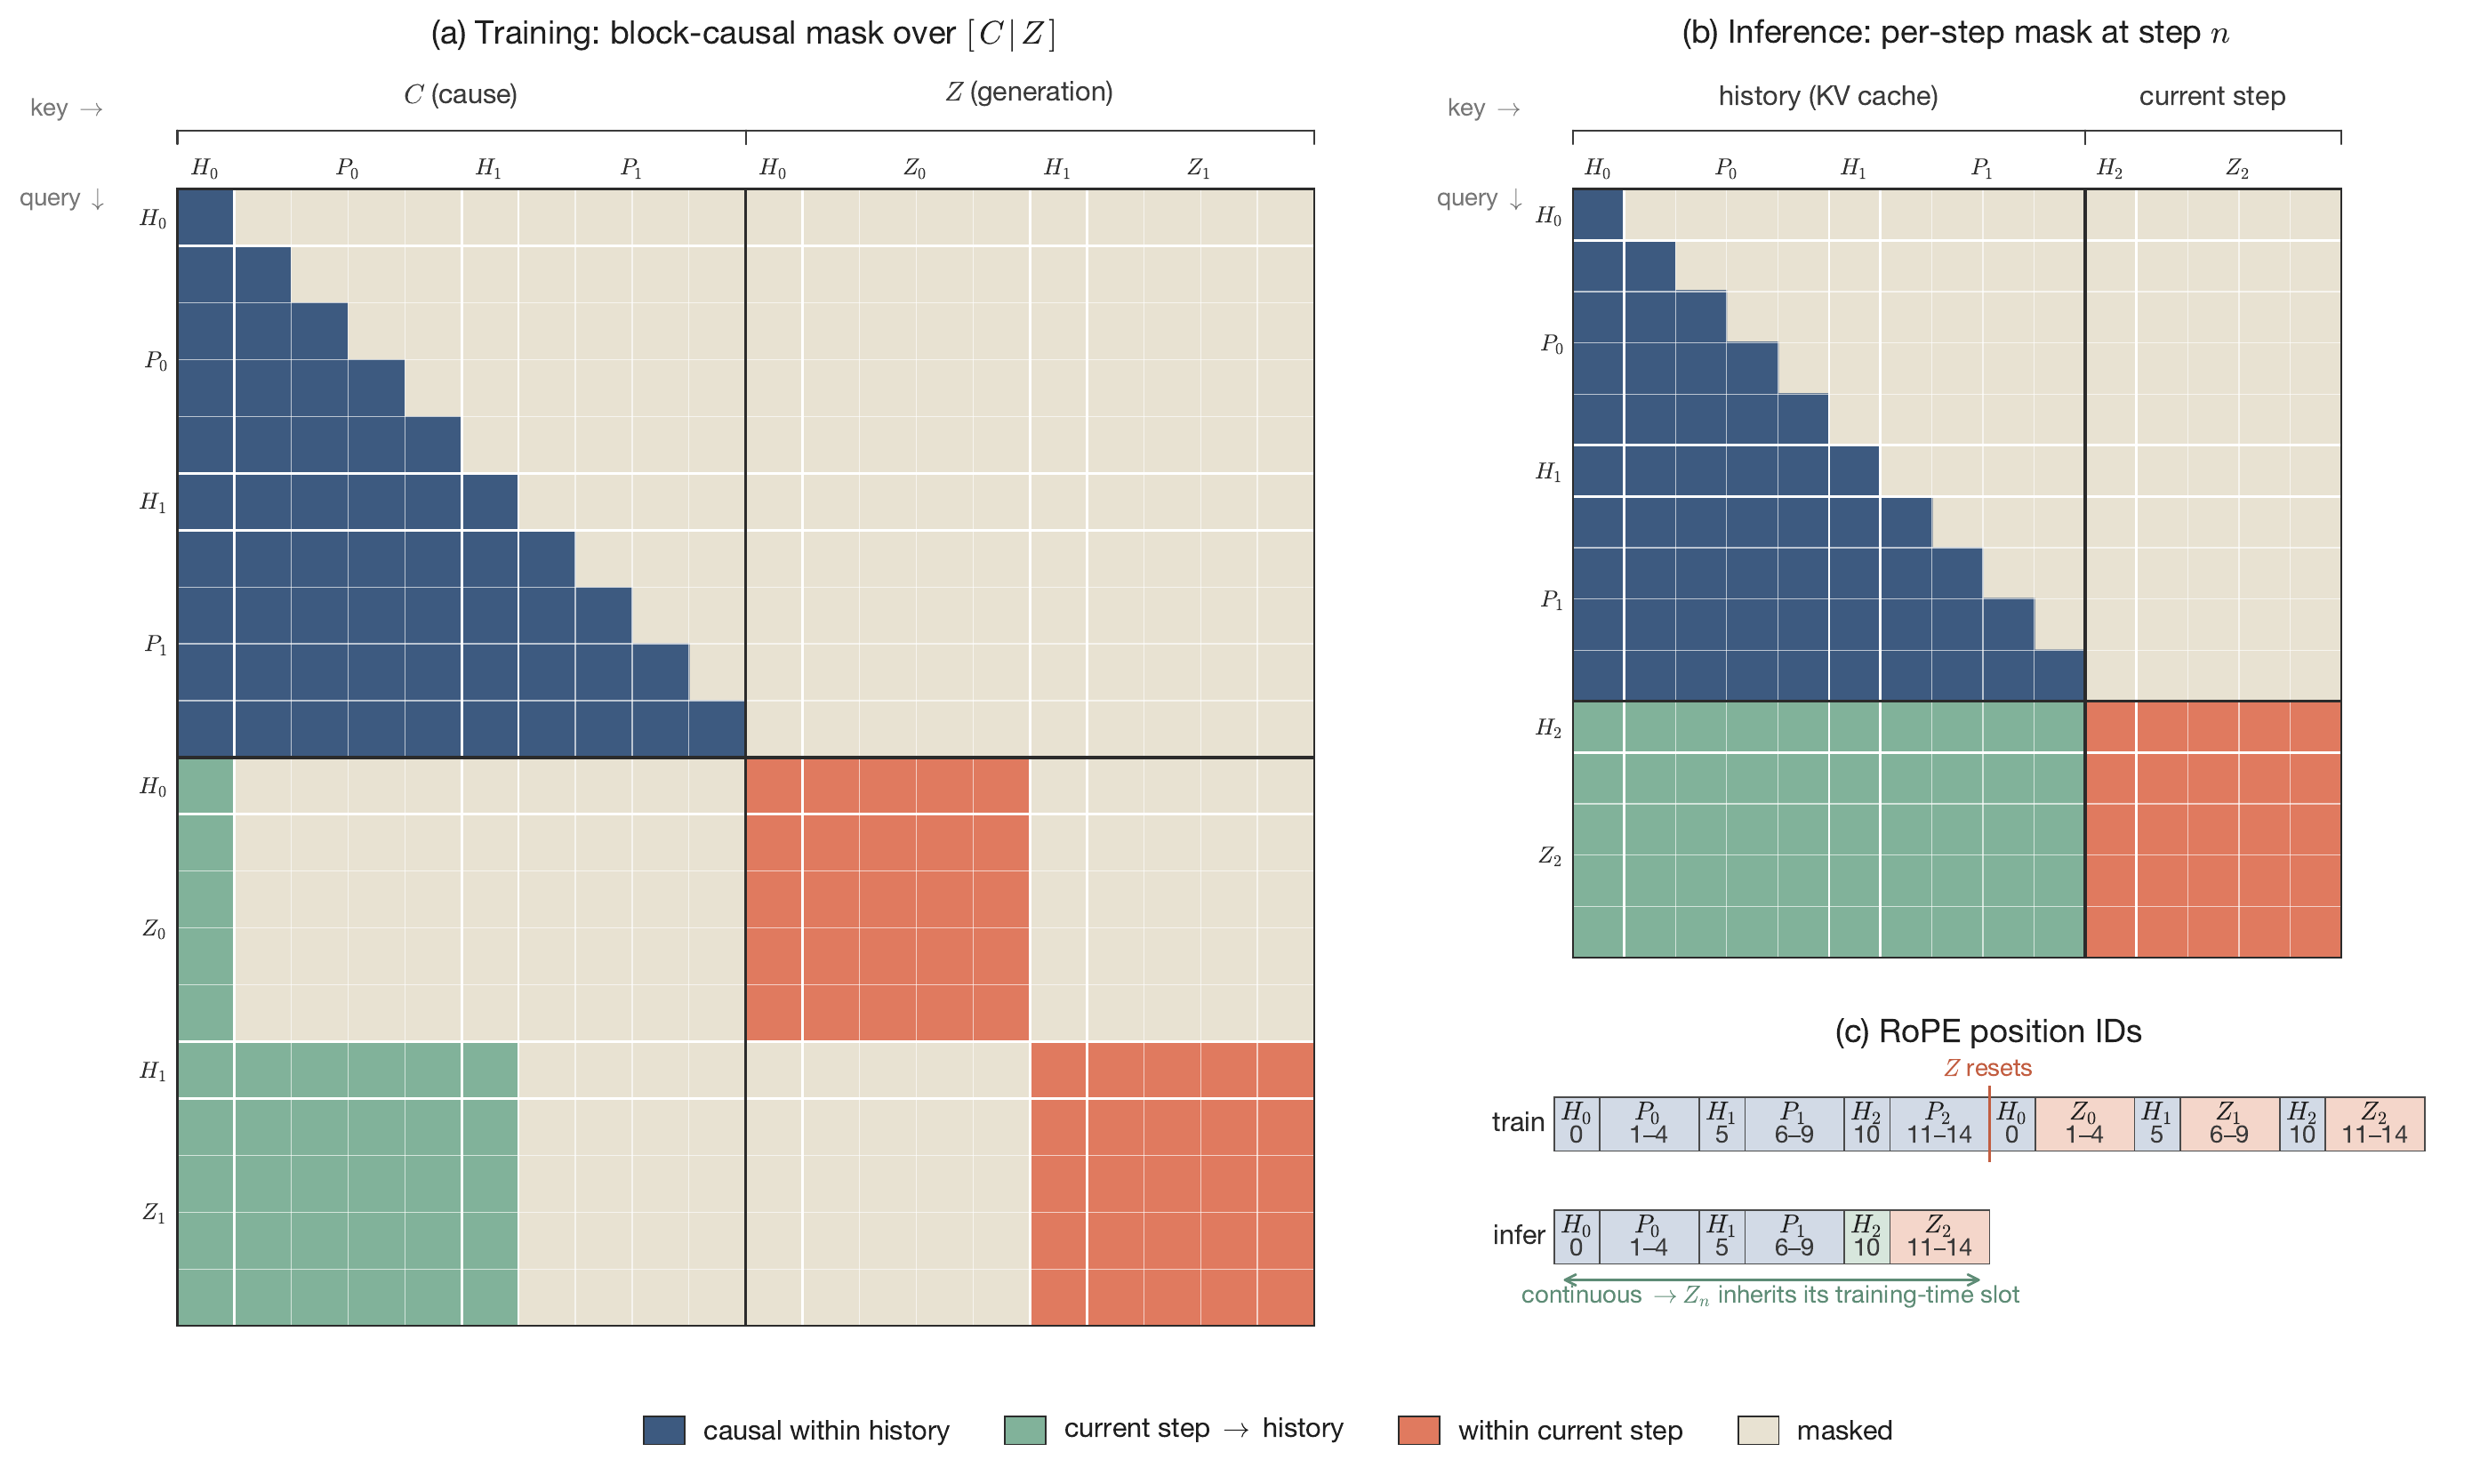
يحتفظ كل صف ببنيته المصدرية أو مقياسه أو تعريف مهمته؛ وتبقى النتائج دون بروتوكول مشترك منفصلة.
| النموذج | البنية أو الدليل | النطاق |
|---|---|---|
| dots.tts | نقطة تحقق أساسية للتدفق المستمر | المحتوى والطابع الصوتي واتساق المقاطع الطويلة |
| dots.tts-soar | نموذج المجال المفتوح/الاستدلال | الاستقرار والزمن تحت المرجع نفسه |
| TTS ترميزي تلقائي الانحدار | خط أساس وحدة بوحدة | أول صوت والتكرار وتراكم الأخطاء |
تحقق من الأرقام والاختصارات والحروف متعددة القراءات والوقفات كلمة كلمة قبل الحكم على التشابه. قد تفوّت درجات المتحدث حالات الحذف والتكرار؛ وقد يفوّت ASR الضوضاء المنسوخة وتلوين الغرفة.
قارن SOAR مع النموذج الأساسي بنص ومرجع متطابقين. سجّل زمن أول صوت وعامل الزمن الحقيقي وذروة الذاكرة واستقرار المقاطع الطويلة بشكل منفصل، بدلاً من تلخيص نظام كامل بجملة واحدة سليمة.
اشتراط الصوت دون أمثلة سابقة ليس موافقة من المتحدث. الاستخدام العام يحتاج إلى إذن وحدود للغرض ومسار للسحب.
يمكن نسخ الانفعال واللهجة والبيئة مع الطابع الصوتي؛ ولا يستطيع النموذج ضمان استخراج عامل هوية نقي.
تعود أسماء النماذج والأرقام والقيود إلى الأوراق أو المستودعات أو بطاقات النماذج أدناه.