Model
dots.tts: Kontinuirane akustične latentne varijable, usklađivanje protoka i govor dugog dometa od 48 kHz
Sinteza govora / Intenzivno čitanje radova
Sinteza govora / Intenzivno čitanje radova
© 2026 TelkNet. Sva prava zadržana.
SINTEZA GOVORA
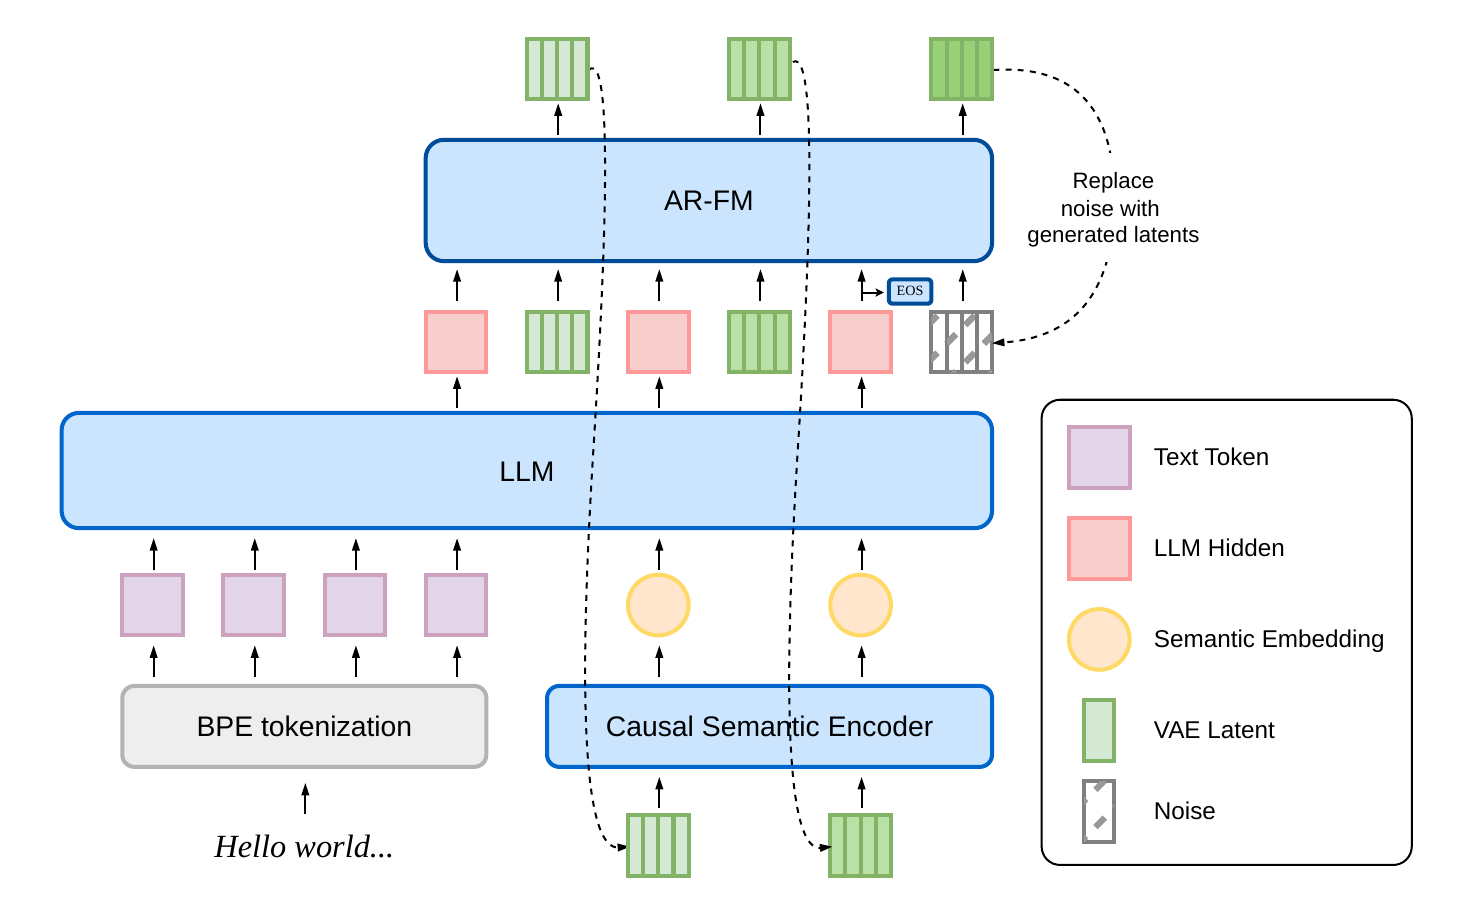
dots.tts ne svodi govor na diskretne audio tokene. AudioVAE isporučuje kontinuirane latente, semantički enkoder sažima generisane segmente za jezičku okosnicu, a flow glava predviđa sljedeću akustičku trajektoriju.
Model uči L=E||v_θ(x_t,t,h,s)-u_t||², uslovljeno skrivenim jezičkim stanjem h i informacijom o govorniku s. SOAR dodaje samoispravljajuće poravnanje; MF destilira trajektoriju na četiri evaluacije.
Službena Seed-TTS-Eval tabela daje SOAR-u prosječnih 79.2 SIM na tri objavljena skupa, a četverostepenom MeanFlow modelu 78.2. SOAR je samoispravljajuće poravnat; MeanFlow destilira dužu učiteljsku trajektoriju u četverostepenog učenika, mijenjajući i brzinu i akustičke obrasce otkaza.
Službene upute za upotrebu preporučuju kratku, čistu referencu čiji transkript odgovara snimku. Otprilike deset sekundi obično je dovoljno; duži upiti ne poboljšavaju automatski kloniranje. Nasumično uzorkovanje bez reference nije trajni identitet lika.
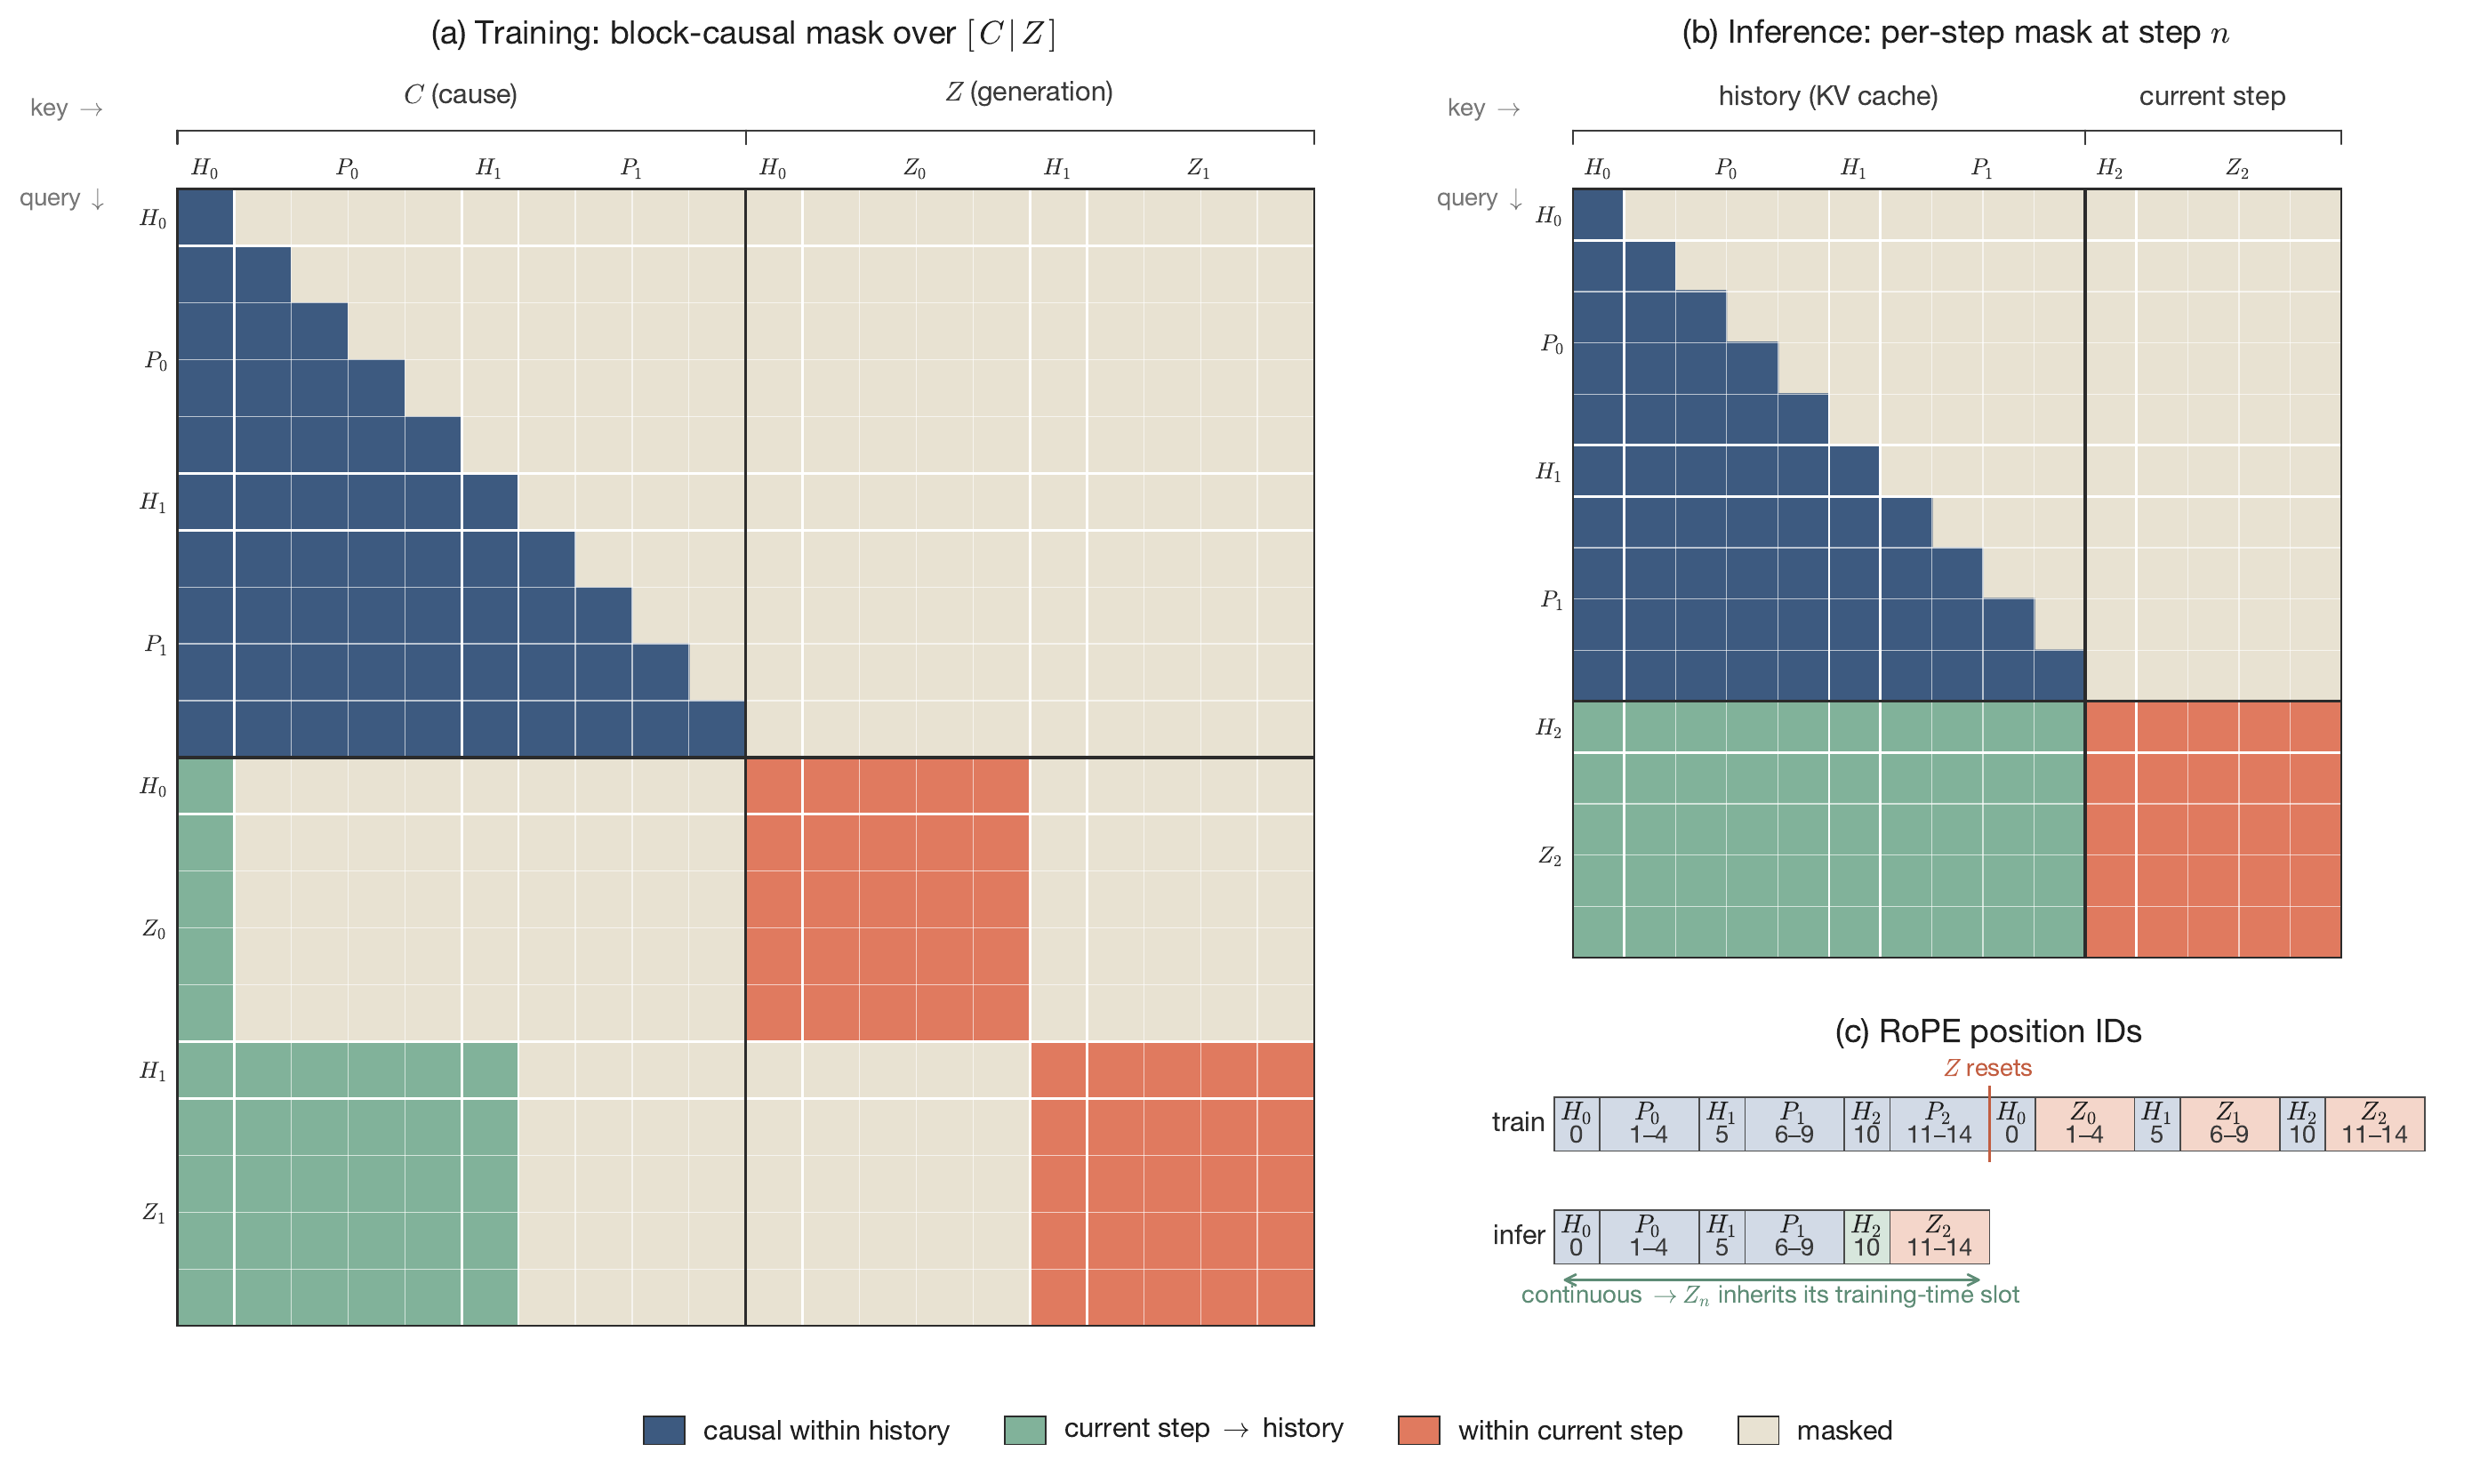
dots.tts uslovljava kontinuirani flow matching tekstom, referencom govornika i akustičkim kontekstom. dots.tts-soar prilagođava trening i težine radi robusnosti u otvorenoj domeni i ponašanja pri inferenciji. LongCat-AudioDiT također koristi kontinuiranu generaciju, ali to nije isti zadatak ni protokol.
Sinteza govora prešla je put od akustičkih obilježja uz vokodere, preko autoregresivnih codec tokena, do difuzije i flow matchinga. Bitna je promjena trajektorije i uslovljavanja, a ne jednostavna oznaka od starog ka novom. Kratka referenca nosi zajedno boju glasa, naglasak, mikrofon i prostoriju.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tkontinuirani akustički latentz_<tprethodni akustički konteksttextnormalizirani tekst i kontroleAudioVAE sažima valne oblike od 48 kHz u kontinuirane latente, semantičko ponovno enkodiranje vraća naznake sadržaja, Qwen2.5 okosnica modelira kontekst, a flow glava obnavlja akustiku. Kontinuirani z nije diskretni codec token.
SOAR sa 32 koraka i MF sa četiri koraka otkrivaju kompromis između kvaliteta i latencije. Sličnost, WER, latencija do prvog zvuka i potpuni real-time faktor moraju ostati odvojeni.
Rad, kod i težine mogu se pratiti kroz dots.tts / dots.tts-soar / tehnički izvještaj.
Svaki red zadržava svoju izvornu arhitekturu, metriku ili definiciju zadatka; rezultati bez zajedničkog protokola ostaju odvojeni.
| Model | Arhitektura ili dokaz | Opseg |
|---|---|---|
| dots.tts | osnovni continuous-flow checkpoint | sadržaj, boja glasa i dugoročna dosljednost |
| dots.tts-soar | model za otvorenu domenu/inferenciju | stabilnost i latencija pod istom referencom |
| autoregresivni codec TTS | osnovna linija token po token | prvi zvuk, ponavljanje i nakupljanje grešaka |
Prije prosudbe sličnosti provjerite riječ po riječ brojeve, skraćenice, homografe i pauze. Ocjene govornika mogu propustiti izostavljanja i ponavljanja; ASR može propustiti kopirani šum i obojenost prostorije.
Uporedite SOAR i osnovni model s identičnim tekstom i referencom. Vrijeme do prvog zvuka, real-time faktor, vršnu memoriju i dugoročnu stabilnost bilježite odvojeno, umjesto da sistem sažimate jednom tečnom rečenicom.
Zero-shot uslovljavanje glasom nije pristanak govornika. Javna upotreba zahtijeva dozvolu, ograničenja namjene i put za povlačenje.
Emocije, naglasak i okruženje mogu se kopirati zajedno s bojom glasa; model ne može garantovati izdvajanje čistog faktora identiteta.
Nazivi modela, brojevi i ograničenja vode se do radova, repozitorija ili kartica modela navedenih ispod.