dots.tts: Συνεχείς ακουστικές λανθάνουσες μεταβλητές, αντιστοίχιση ροής και ομιλία μεγάλης εμβέλειας 48 kHz
Σύνθεση λόγου / Εντατική ανάγνωση εργασιών
ΣΥΝΘΕΣΗ ΟΜΙΛΙΑΣ
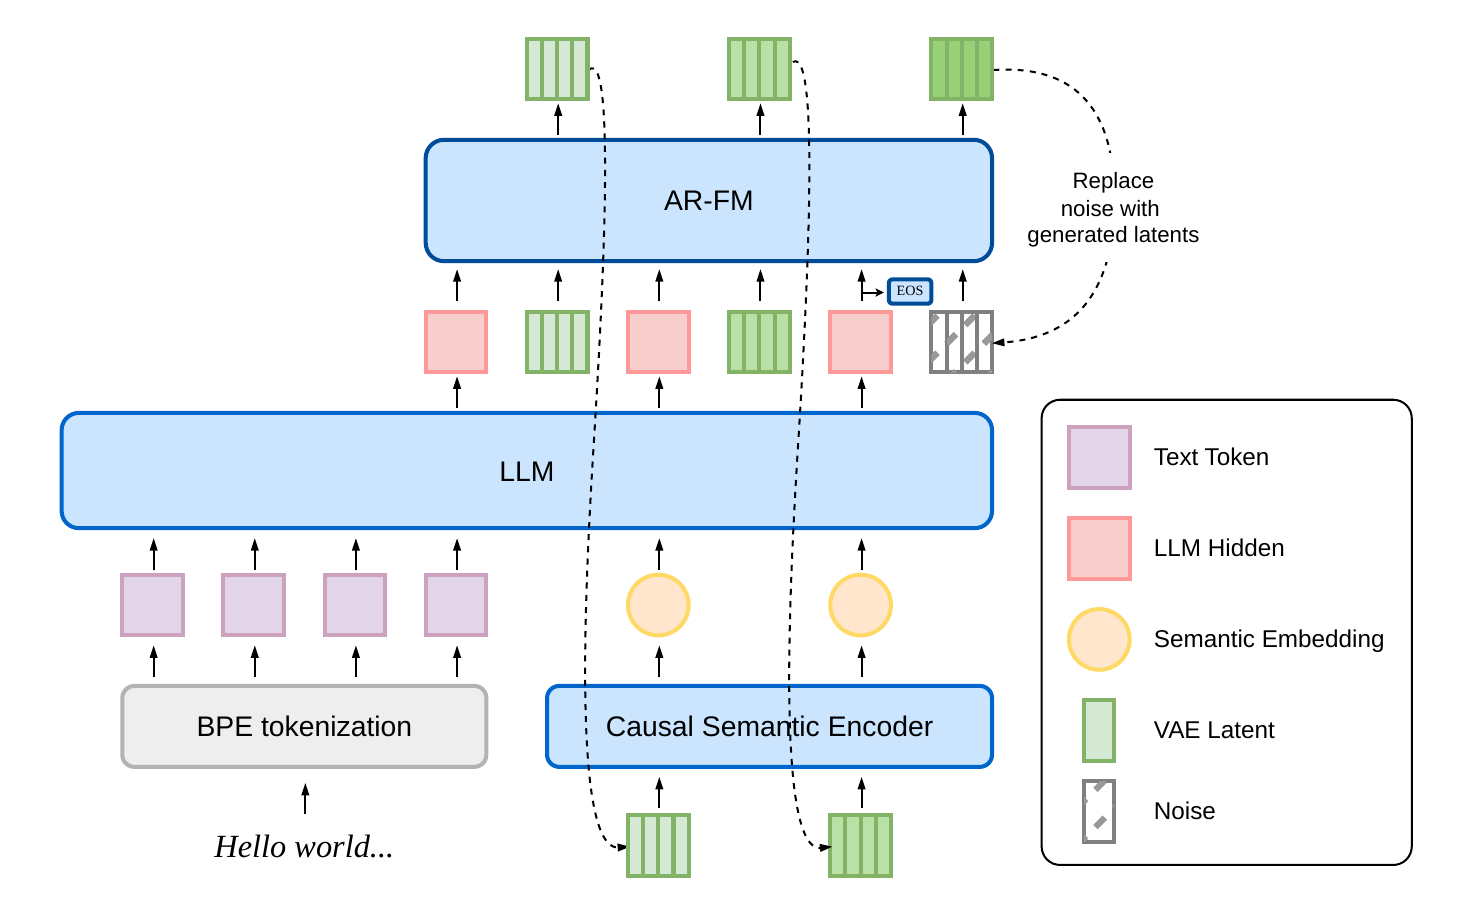
Το dots.tts δεν αναγάγει την ομιλία σε διακριτά token ήχου. Το AudioVAE παρέχει συνεχείς λανθάνουσες αναπαραστάσεις, ένας σημασιολογικός κωδικοποιητής συμπιέζει τα παραγόμενα τμήματα για τη γλωσσική ραχοκοκαλιά και μια κεφαλή flow προβλέπει την επόμενη ακουστική τροχιά.
Υπό συνθήκη flow matching
Το μοντέλο μαθαίνει το L=E||v_θ(x_t,t,h,s)-u_t||², υπό την προϋπόθεση της κρυφής γλωσσικής κατάστασης h και των πληροφοριών ομιλητή s. Το SOAR προσθέτει αυτοδιορθωτική ευθυγράμμιση· το MF αποστάζει την τροχιά σε τέσσερις αποτιμήσεις.
Το SOAR και το MeanFlow ανταλλάσσουν διαφορετικά σφάλματα
Ο επίσημος πίνακας Seed-TTS-Eval δίνει στο SOAR μέσο SIM 79.2 στις τρεις δημοσιευμένες διαιρέσεις και στο τετράβηματο μοντέλο MeanFlow 78.2. Το SOAR είναι αυτοδιορθωτικά ευθυγραμμισμένο· το MeanFlow αποστάζει μια μακρύτερη τροχιά δασκάλου σε έναν τετράβηματο μαθητή, αλλάζοντας ταυτόχρονα την ταχύτητα και τους τρόπους ακουστικής αποτυχίας.
Ήχος αναφοράς και τυχαίες φωνές
Οι επίσημες σημειώσεις χρήσης συνιστούν μια σύντομη, καθαρή αναφορά της οποίας η απομαγνητοφώνηση ταιριάζει με την ηχογράφηση. Περίπου δέκα δευτερόλεπτα αρκούν συνήθως· μακρύτερες προτροπές δεν βελτιώνουν αυτόματα την κλωνοποίηση. Η τυχαία δειγματοληψία χωρίς αναφορά δεν αποτελεί μόνιμη ταυτότητα χαρακτήρα.
Πώς εξελίχθηκαν οι ακουστικές αναπαραστάσεις
Το dots.tts θέτει ως συνθήκη στο συνεχές flow matching το κείμενο, την αναφορά ομιλητή και το ακουστικό πλαίσιο. Το dots.tts-soar προσαρμόζει την εκπαίδευση και τα βάρη για ευρωστία ανοιχτού πεδίου και συμπεριφορά συμπερασμού. Το LongCat-AudioDiT χρησιμοποιεί επίσης συνεχή παραγωγή, αλλά δεν πρόκειται για την ίδια εργασία ή το ίδιο πρωτόκολλο.
Η σύνθεση ομιλίας πέρασε από ακουστικά χαρακτηριστικά μαζί με vocoder, μέσα από αυτοπαλίνδρομα token codec, στη διάχυση και το flow matching. Η ουσιαστική αλλαγή είναι η τροχιά και η συνθήκη, όχι μια απλή ταμπέλα από το παλιό στο νέο. Μια σύντομη αναφορά μεταφέρει μαζί το ηχόχρωμα, την προφορά, το μικρόφωνο και το δωμάτιο.
Αυτοπαλίνδρομο flow matching σε συνεχείς ακουστικές λανθάνουσες αναπαραστάσεις
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tσυνεχής ακουστική λανθάνουσα αναπαράστασηz_<tπροηγούμενο ακουστικό πλαίσιοtextκανονικοποιημένο κείμενο και έλεγχοι
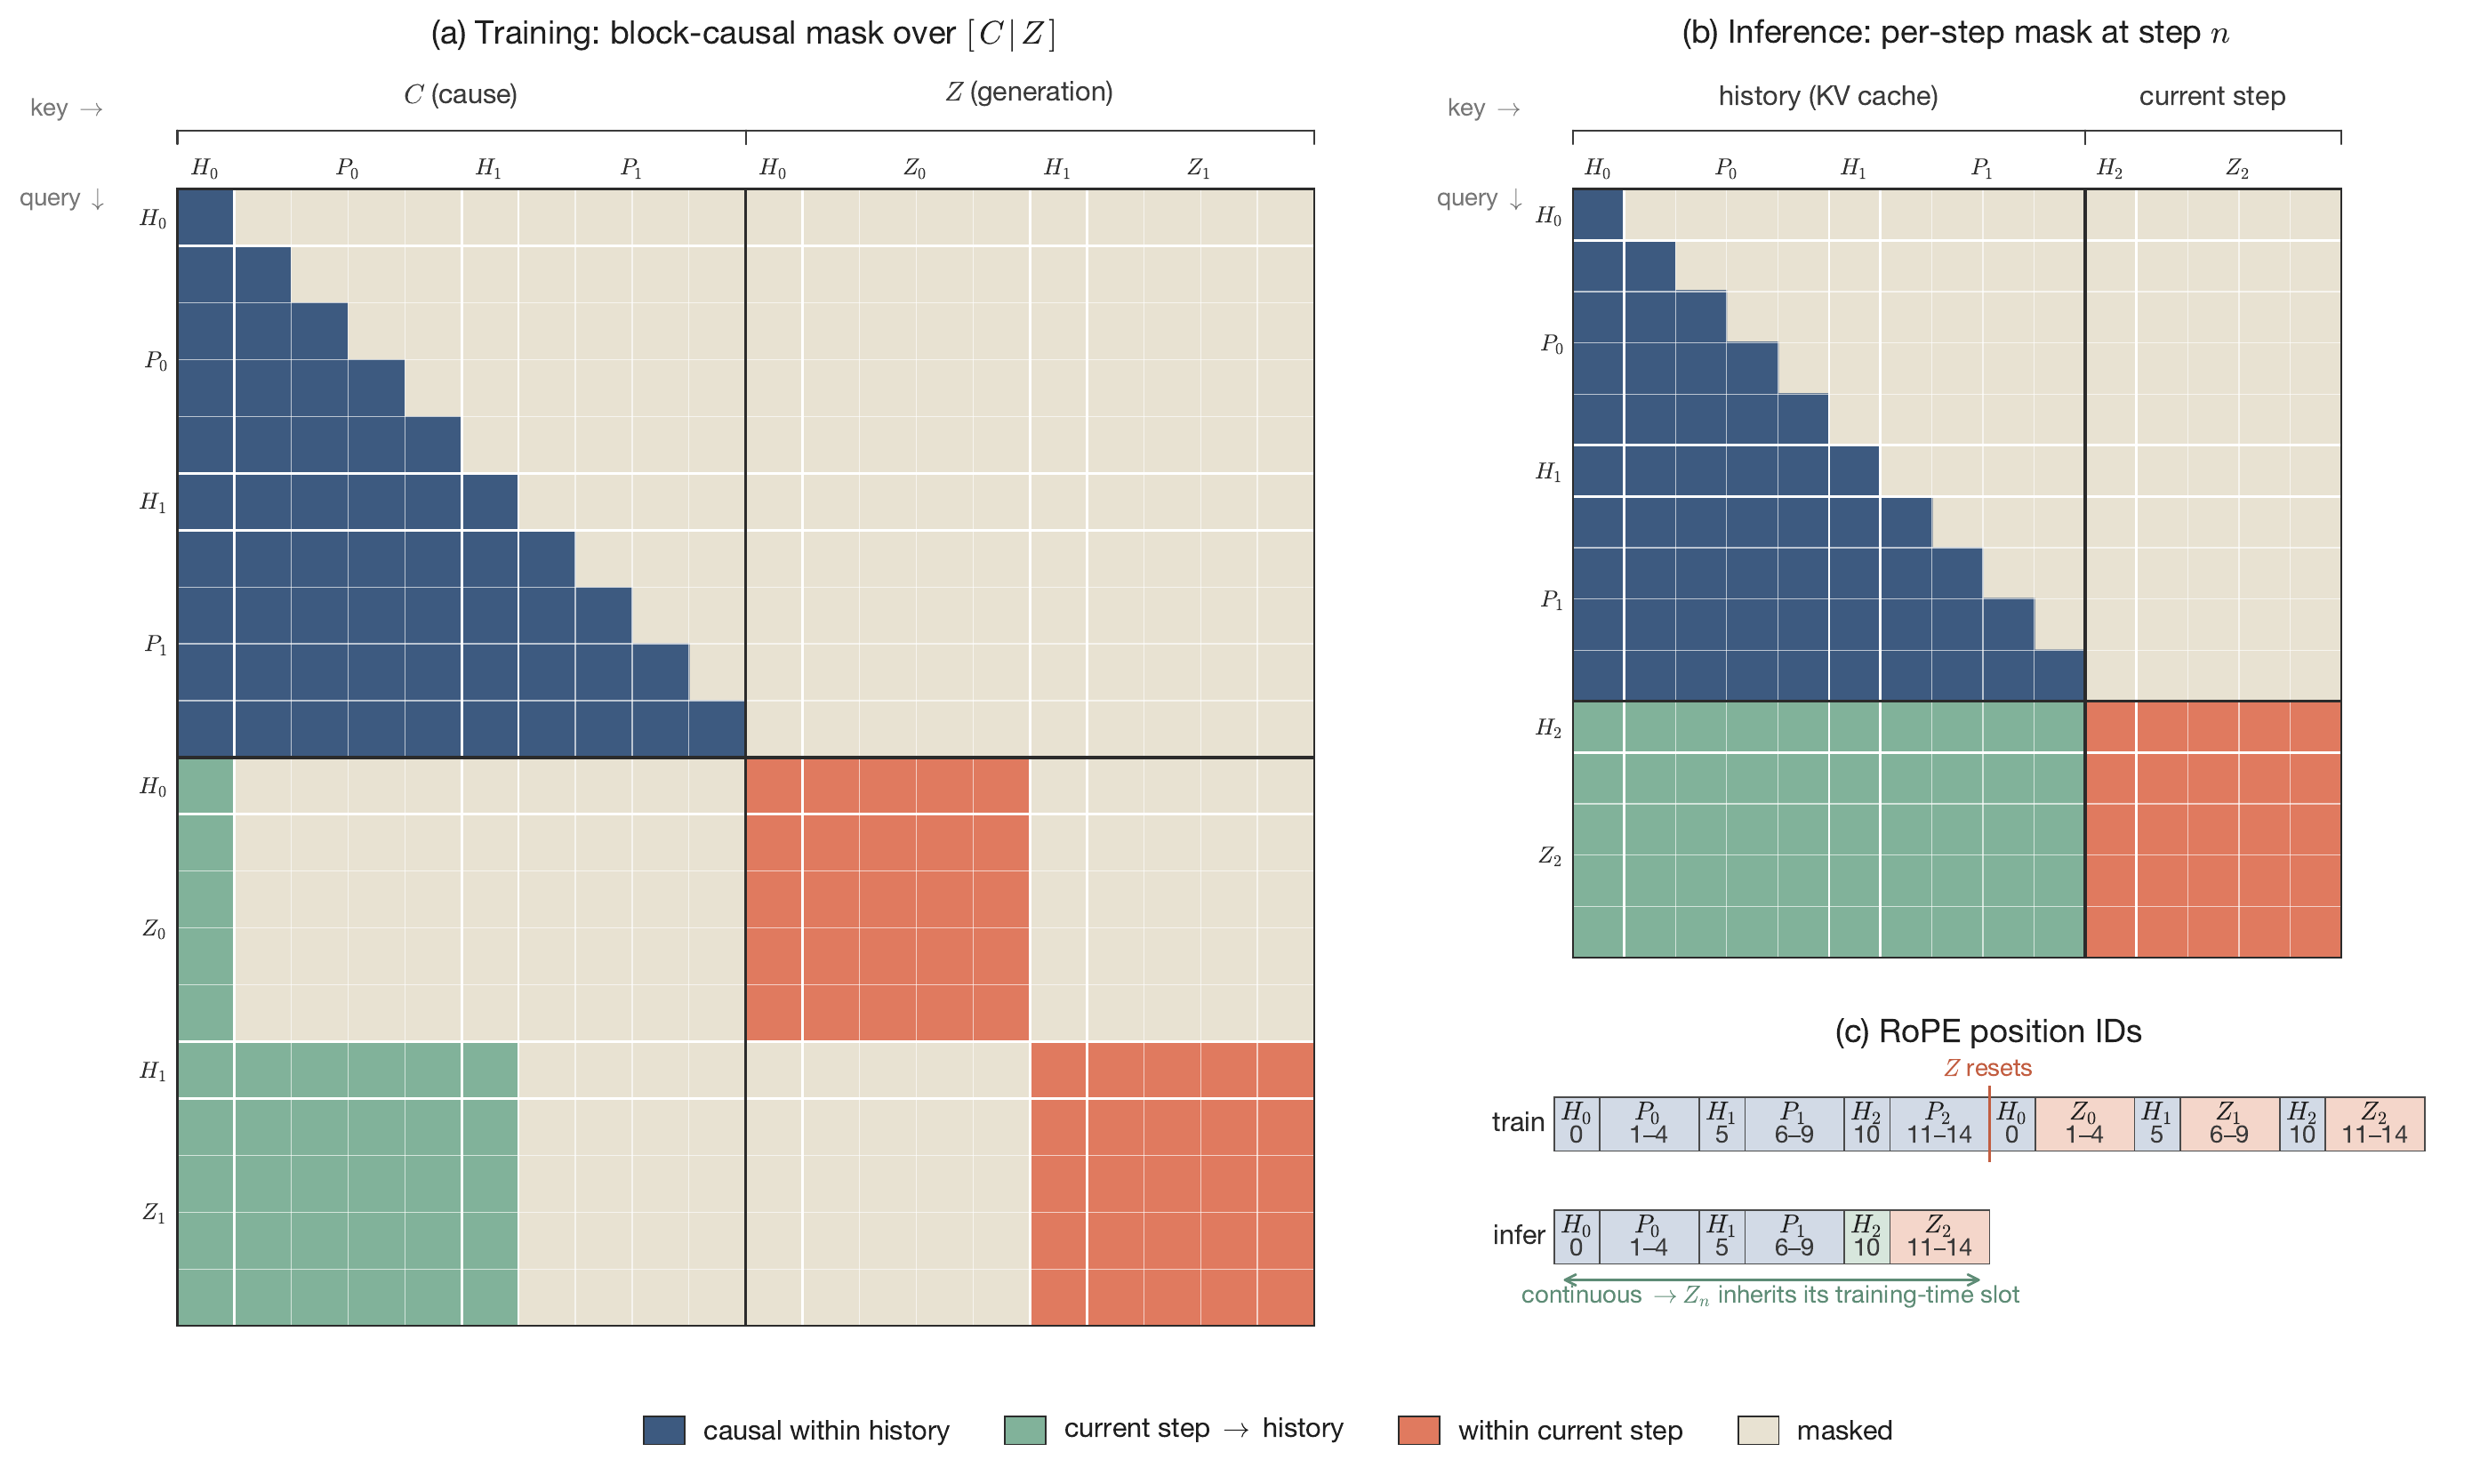
Το AudioVAE συμπιέζει κυματομορφές 48 kHz σε συνεχείς λανθάνουσες αναπαραστάσεις, η σημασιολογική επανακωδικοποίηση αποκαθιστά ενδείξεις περιεχομένου, η ραχοκοκαλιά Qwen2.5 μοντελοποιεί το πλαίσιο και μια κεφαλή flow αποκαθιστά τα ακουστικά. Το συνεχές z δεν είναι διακριτό token codec.
Το SOAR με 32 βήματα και το MF με τέσσερα βήματα αναδεικνύουν μια αντιστάθμιση ποιότητας και καθυστέρησης. Η ομοιότητα, το WER, η καθυστέρηση πρώτου ήχου και ο πλήρης παράγοντας πραγματικού χρόνου πρέπει να παραμένουν ξεχωριστά.
Η εργασία, ο κώδικας και τα βάρη παρακολουθούνται μέσω dots.tts / dots.tts-soar / Technical report.
Τι απαντά κάθε μέτρο ομιλίας
Κάθε γραμμή διατηρεί τον ορισμό της αρχιτεκτονικής, του μέτρου ή της εργασίας της· αποτελέσματα χωρίς κοινό πρωτόκολλο παραμένουν ξεχωριστά.
| Μοντέλο | Αρχιτεκτονική ή τεκμηρίωση | Πεδίο |
|---|---|---|
| dots.tts | βασικό checkpoint συνεχούς flow | περιεχόμενο, ηχόχρωμα και συνέπεια μακράς μορφής |
| dots.tts-soar | μοντέλο ανοιχτού πεδίου/συμπερασμού | σταθερότητα και καθυστέρηση με την ίδια αναφορά |
| autoregressive codec TTS | βάση σύγκρισης token προς token | πρώτος ήχος, επανάληψη και συσσώρευση σφαλμάτων |
Περιεχόμενο, ηχόχρωμα και ακρόαση μακράς μορφής
Επαληθεύστε αριθμούς, συντομογραφίες, πολύφωνα και παύσεις λέξη προς λέξη πριν κρίνετε την ομοιότητα. Οι βαθμολογίες ομιλητή μπορεί να χάσουν παραλείψεις και επαναλήψεις· το ASR μπορεί να χάσει αντιγραμμένο θόρυβο και χρωματισμό δωματίου.
Συγκρίνετε SOAR και βάση με πανομοιότυπο κείμενο και αναφορά. Καταγράψτε ξεχωριστά τον χρόνο έως τον πρώτο ήχο, τον παράγοντα πραγματικού χρόνου, τη μέγιστη μνήμη και τη σταθερότητα μακράς μορφής, αντί να συνοψίζετε ένα σύστημα με μία ευφράδεια πρόταση.
Κίνδυνοι που αφήνει η ομοιότητα φωνής
Η zero-shot φωνητική συνθήκη δεν αποτελεί συγκατάθεση του ομιλητή. Η δημόσια χρήση χρειάζεται άδεια, όρια σκοπού και οδό ανάκλησης.
Συναίσθημα, προφορά και περιβάλλον μπορούν να αντιγραφούν μαζί με το ηχόχρωμα· το μοντέλο δεν μπορεί να εγγυηθεί την εξαγωγή ενός καθαρού παράγοντα ταυτότητας.
Εργασίες και δημόσια αρχεία για το dots.tts
Τα ονόματα μοντέλων, οι αριθμοί και οι περιορισμοί ανιχνεύονται στις εργασίες, τα αποθετήρια ή τις κάρτες μοντέλων παρακάτω.