Modelo
dots.tts: variables latentes acústicas continuas, coincidencia de flujo y voz de largo alcance de 48 kHz
Síntesis de voz / Lectura intensiva de artículos
Síntesis de voz / Lectura intensiva de artículos
SÍNTESIS DE VOZ
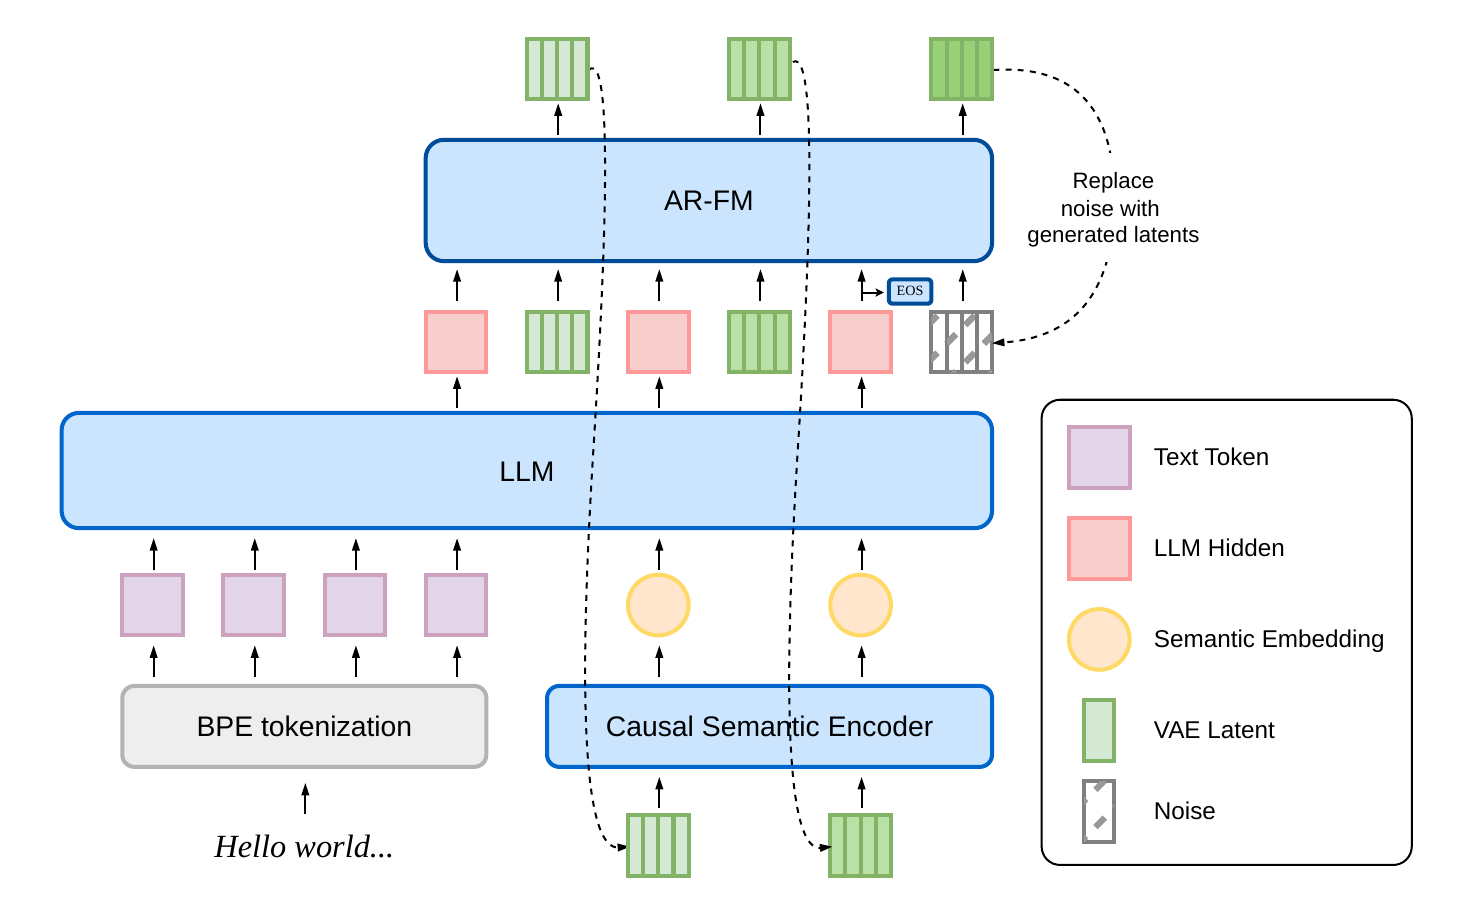
dots.tts no reduce la voz a tokens de audio discretos. AudioVAE aporta latentes continuos, un codificador semántico comprime los fragmentos generados para la columna vertebral lingüística y un cabezal de flujo predice la siguiente trayectoria acústica.
El modelo aprende L=E||v_θ(x_t,t,h,s)-u_t||², condicionado por el estado oculto lingüístico h y la información del hablante s. SOAR añade alineación autocorrectiva; MF destila la trayectoria hasta cuatro evaluaciones.
La tabla oficial de Seed-TTS-Eval otorga a SOAR un SIM medio de 79.2 en los tres cortes publicados y al modelo MeanFlow de cuatro pasos un 78.2. SOAR está alineado de forma autocorrectiva; MeanFlow destila una trayectoria docente más larga en un estudiante de cuatro pasos, lo que cambia tanto la velocidad como los modos de fallo acústico.
Las notas oficiales de uso recomiendan una referencia corta y limpia cuya transcripción coincida con la grabación. Unos diez segundos suelen bastar; las indicaciones más largas no mejoran automáticamente la clonación. El muestreo aleatorio sin referencia no constituye una identidad de personaje persistente.
dots.tts condiciona el flow matching continuo con texto, referencia de hablante y contexto acústico. dots.tts-soar ajusta el entrenamiento y los pesos para la robustez en dominio abierto y el comportamiento en inferencia. LongCat-AudioDiT también usa generación continua, pero no es la misma tarea ni el mismo protocolo.
La síntesis de voz pasó de las características acústicas más vocoders a los tokens de códec autoregresivos, y de ahí a la difusión y el flow matching. El cambio importante está en la trayectoria y el condicionamiento, no en una simple etiqueta de viejo a nuevo. Una referencia corta arrastra a la vez timbre, acento, micrófono y sala.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tlatente acústico continuoz_<tcontexto acústico previotexttexto normalizado y controlesAudioVAE comprime formas de onda de 48 kHz en latentes continuos, la recodificación semántica recupera las pistas de contenido, la columna vertebral Qwen2.5 modela el contexto y un cabezal de flujo restituye la acústica. La z continua no es un token de códec discreto.
SOAR con 32 pasos y MF con cuatro pasos exponen un compromiso entre calidad y latencia. La similitud, el WER, la latencia del primer audio y el factor de tiempo real completo deben mantenerse por separado.
El paper, el código y los pesos pueden seguirse a través de dots.tts / dots.tts-soar / informe técnico.
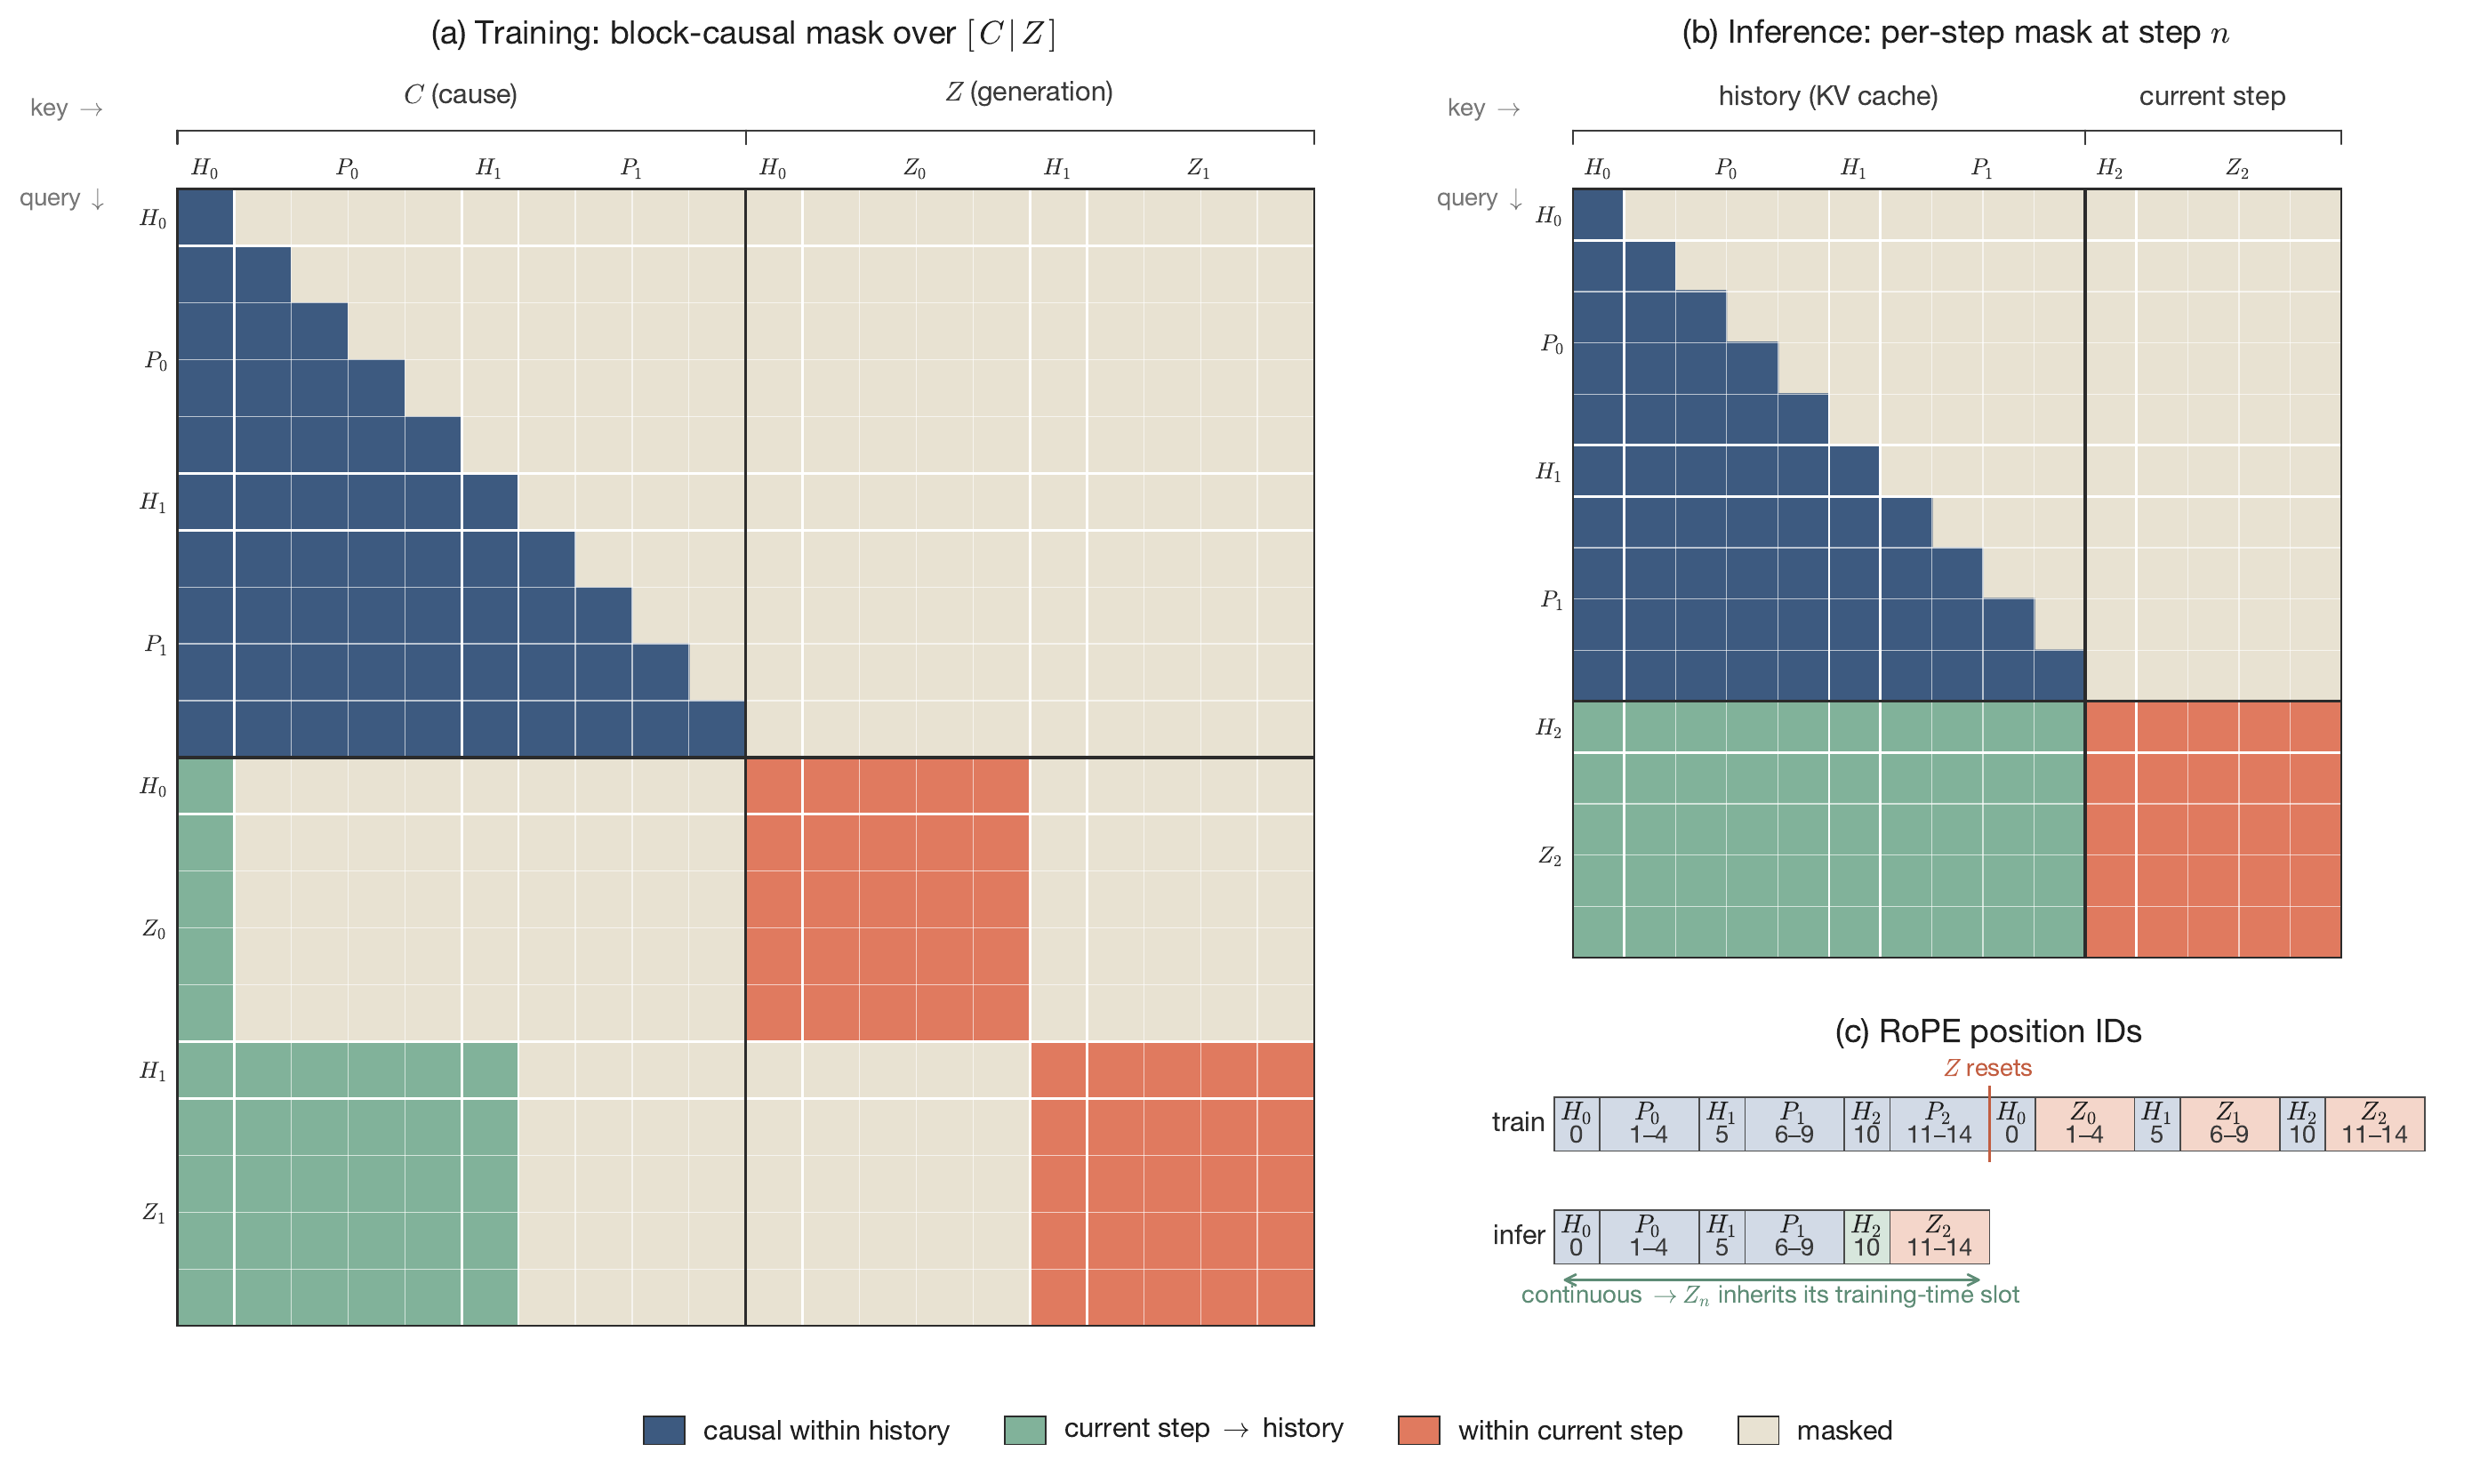
Cada fila conserva su arquitectura de origen, su métrica o su definición de tarea; los resultados sin un protocolo compartido permanecen separados.
| Modelo | Arquitectura o evidencia | Alcance |
|---|---|---|
| dots.tts | checkpoint base de flujo continuo | contenido, timbre y consistencia en formato largo |
| dots.tts-soar | modelo de dominio abierto e inferencia | estabilidad y latencia con la misma referencia |
| TTS de códec autoregresivo | línea base token a token | primer audio, repetición y acumulación de errores |
Conviene verificar números, abreviaturas, polífonos y pausas palabra por palabra antes de juzgar la similitud. Las puntuaciones de hablante pueden pasar por alto omisiones y repeticiones; el ASR puede no detectar ruido copiado ni la coloración de la sala.
Hay que comparar SOAR y el modelo base con texto y referencia idénticos. Conviene registrar por separado el tiempo hasta el primer audio, el factor de tiempo real, la memoria máxima y la estabilidad en formato largo, en lugar de resumir un sistema con una sola frase fluida.
El condicionamiento de voz zero-shot no equivale al consentimiento del hablante. El uso público necesita permiso, límites de propósito y una vía de retirada.
La emoción, el acento y el entorno pueden copiarse junto con el timbre; el modelo no puede garantizar la extracción de un factor de identidad puro.
Los nombres de modelos, las cifras y las limitaciones se remiten a los papers, repositorios o fichas de modelo que figuran a continuación.