dots.tts:連續聲學潛變量、流匹配和 48 kHz 長程語音
語音合成 / 論文精讀
語音合成
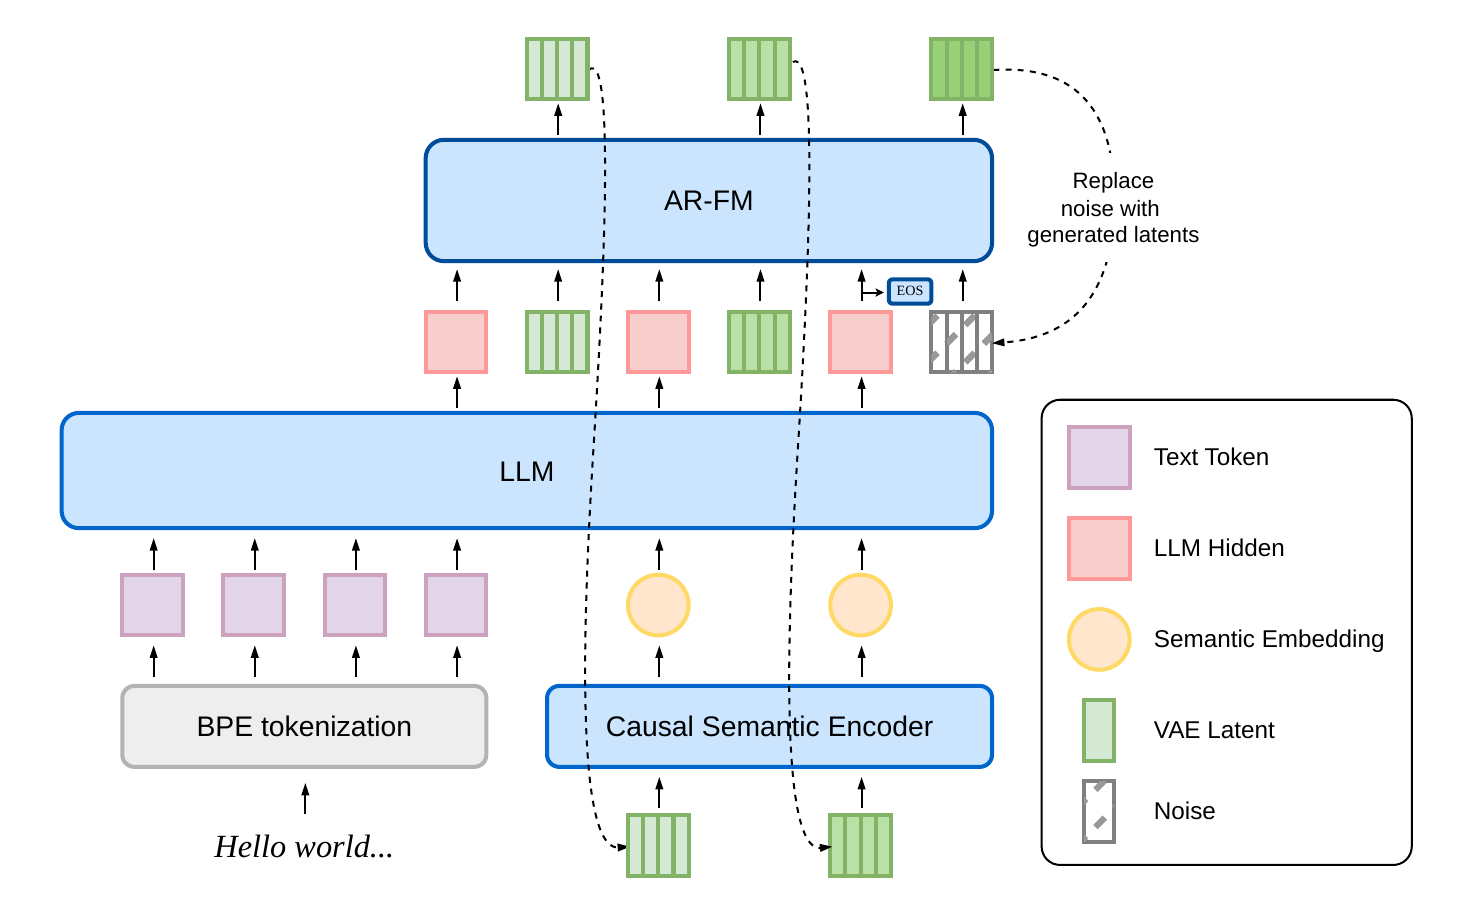
dots.tts 並未把語音壓縮成離散的音訊符元。AudioVAE 提供連續潛變數,語義編碼器把生成的片段壓縮後交給語言骨幹,再由流匹配頭預測下一段聲學軌跡。
條件流匹配
模型學習的目標是 L=E||v_θ(x_t,t,h,s)-u_t||²,條件來自語言隱藏狀態 h 與說話者資訊 s。SOAR 加入自我修正對齊;MF 則把軌跡蒸餾成四次求值。
SOAR 與 MeanFlow 各自交換不同的誤差
官方的 Seed-TTS-Eval 表格中,SOAR 在三個公開切分上的平均 SIM 為 79.2,四步 MeanFlow 模型則是 78.2。SOAR 採用自我修正對齊;MeanFlow 把較長的教師軌跡蒸餾成四步學生模型,速度與聲學失效模式都因此改變。
參考音訊與隨機聲音
官方使用說明建議選一段乾淨的短參考音訊,且逐字稿要與錄音一致。大約十秒通常就夠了;更長的提示音訊並不保證複製效果更好。不給參考的隨機取樣並非可延續的角色聲線。
聲學表徵如何演進
dots.tts 以文字、說話者參考與聲學上下文作為連續流匹配的條件。dots.tts-soar 調整訓練方式與權重,針對開放域的穩健性與推論行為最佳化。LongCat-AudioDiT 同樣採用連續生成,但兩者的任務與評測協議並不相同。
語音合成一路從聲學特徵搭配聲碼器,走到自回歸編解碼符元,再到擴散與流匹配。關鍵的轉變在於軌跡與條件設計,而非貼上一個從舊到新的標籤。一段短參考音訊會同時帶著音色、口音、麥克風與房間的特性。
連續聲學潛變數上的自回歸流匹配
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_t連續聲學潛變數z_<t先前的聲學上下文text正規化文字與控制條件
AudioVAE 把 48 kHz 波形壓縮成連續潛變數,語義再編碼補回內容線索,Qwen2.5 骨幹負責上下文建模,最後由流匹配頭還原聲學細節。連續的 z 與離散編解碼符元是兩回事。
SOAR 的 32 步與 MF 的 4 步呈現品質與延遲的取捨。相似度、WER、首次發聲延遲與完整即時因子必須分開檢視。
論文、程式碼與權重可依序沿著 dots.tts / dots.tts-soar / Technical report 追查。
各項語音指標回答的問題
每一列保留各自的來源架構、指標或任務定義;沒有共同協議的結果不會混為一談。
| 模型 | 架構或證據 | 範圍 |
|---|---|---|
| dots.tts | 基礎連續流匹配檢查點 | 內容、音色與長篇一致性 |
| dots.tts-soar | 開放域/推論模型 | 相同參考下的穩定性與延遲 |
| autoregressive codec TTS | 逐符元基線 | 首次發聲、重複與誤差累積 |
內容、音色與長篇聆聽
判斷相似度之前,先逐字核對數字、縮寫、多音字與停頓。說話者分數可能漏看遺漏與重複;ASR 也可能漏掉被複製的雜訊與房間染色。
用完全相同的文字與參考音訊比較 SOAR 與基礎模型。首次發聲時間、即時因子、峰值記憶體與長篇穩定性各自記錄,不要只用一句流暢的句子概括整套系統。
聲音相似度留下的風險
零樣本聲音條件化不等於取得說話者同意。公開使用需要授權、用途限制與撤回管道。
情緒、口音與環境可能隨音色一起被複製;模型無法保證抽取出純粹的身分因子。
dots.tts 的論文與公開檔案
模型名稱、數字與限制均可追溯到下列論文、儲存庫或模型卡。