Modell
dots.tts: Kontinuierliche akustische latente Variablen, Flussanpassung und 48-kHz-Fernsprache
Sprachsynthese / Intensives Lesen von Aufsätzen
Sprachsynthese / Intensives Lesen von Aufsätzen
© 2026 TelkNet. Alle Rechte vorbehalten.
SPRACHSYNTHESE
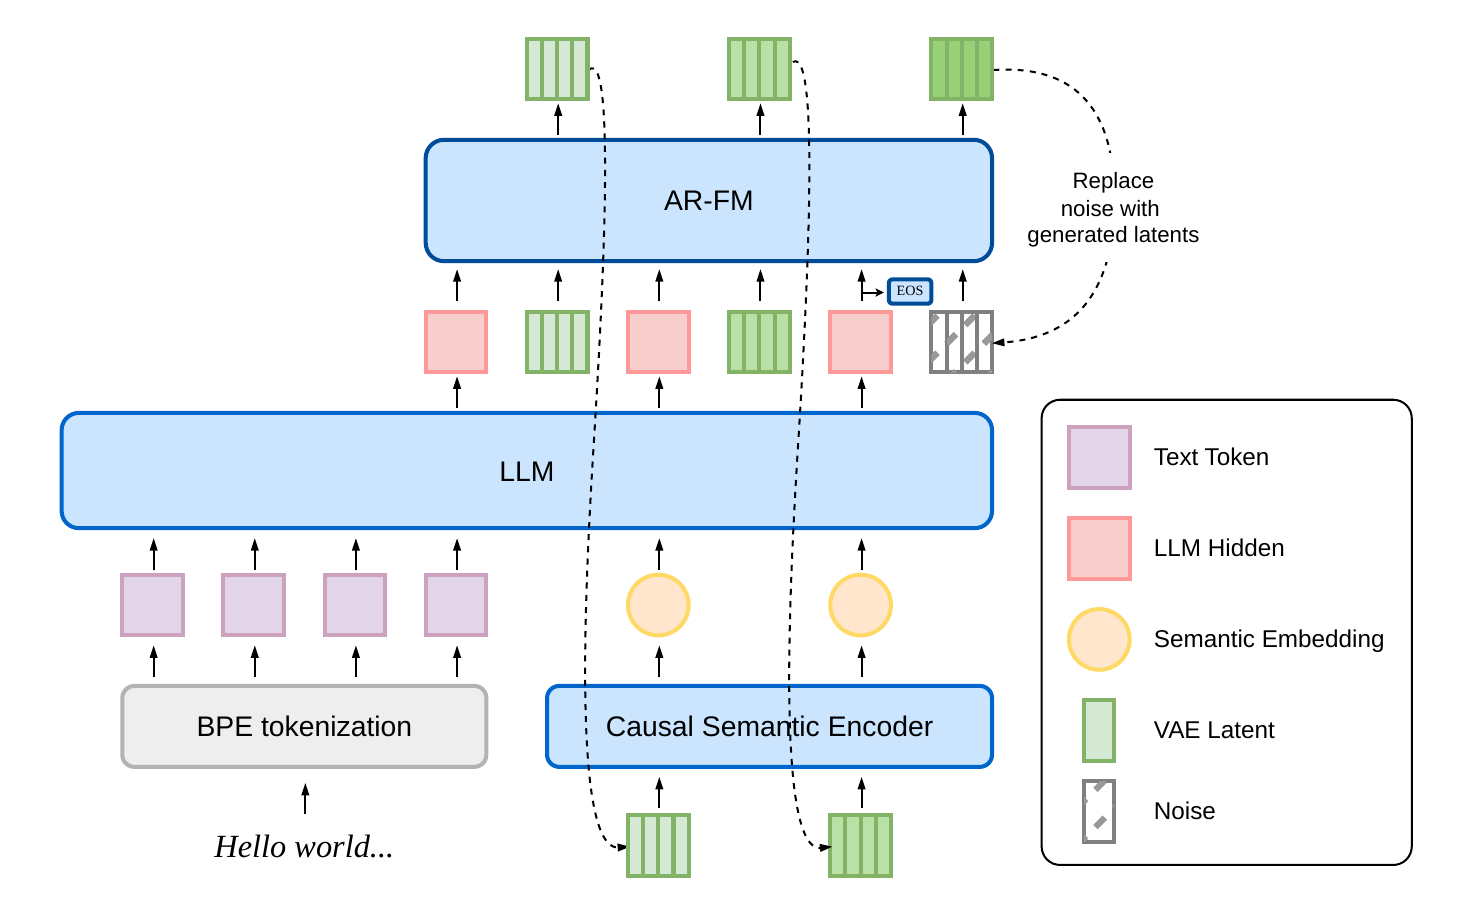
dots.tts reduziert Sprache nicht auf diskrete Audio-Tokens. AudioVAE liefert kontinuierliche Latents, ein semantischer Encoder komprimiert generierte Patches für das Sprach-Backbone, und ein Flow-Kopf sagt die nächste akustische Trajektorie voraus.
Das Modell lernt L=E||v_θ(x_t,t,h,s)-u_t||², konditioniert auf den Hidden State h der Sprache und die Sprecherinformation s. SOAR ergänzt ein selbstkorrigierendes Alignment; MF destilliert die Trajektorie auf vier Auswertungen.
Die offizielle Seed-TTS-Eval-Tabelle weist SOAR über die drei veröffentlichten Splits hinweg einen durchschnittlichen SIM von 79.2 zu und dem MeanFlow-Modell mit vier Schritten 78.2. SOAR ist selbstkorrigierend aligniert; MeanFlow destilliert eine längere Lehrer-Trajektorie in einen Vier-Schritte-Schüler und verändert damit sowohl Geschwindigkeit als auch akustische Fehlermodi.
Die offiziellen Nutzungshinweise empfehlen eine kurze, saubere Referenz, deren Transkript zur Aufnahme passt. Etwa zehn Sekunden reichen normalerweise aus; längere Prompts verbessern das Klonen nicht automatisch. Zufälliges Sampling ohne Referenz ist keine dauerhafte Charakteridentität.
dots.tts konditioniert kontinuierliches Flow Matching auf Text, Sprecherreferenz und akustischen Kontext. dots.tts-soar justiert Training und Gewichte für Open-Domain-Robustheit und Inferenzverhalten nach. LongCat-AudioDiT nutzt ebenfalls kontinuierliche Generierung, ist aber weder dieselbe Aufgabe noch dasselbe Protokoll.
Die Sprachsynthese bewegte sich von akustischen Merkmalen plus Vocodern über autoregressive Codec-Tokens hin zu Diffusion und Flow Matching. Der entscheidende Wandel liegt in Trajektorie und Konditionierung, nicht in einem simplen Alt-zu-Neu-Etikett. Eine kurze Referenz trägt Klangfarbe, Akzent, Mikrofon und Raum zugleich.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tkontinuierlicher akustischer Latentz_<tbisheriger akustischer Kontexttextnormalisierter Text und SteuerungenAudioVAE komprimiert 48-kHz-Wellenformen in kontinuierliche Latents, semantisches Re-Encoding stellt Inhaltshinweise wieder her, das Qwen2.5-Backbone modelliert den Kontext, und ein Flow-Kopf rekonstruiert die Akustik. Ein kontinuierliches z ist kein diskretes Codec-Token.
SOAR mit 32 Schritten und MF mit vier Schritten legen einen Qualitäts-Latenz-Tradeoff offen. Ähnlichkeit, WER, Latenz bis zum ersten Audio und der volle Real-Time-Faktor müssen getrennt betrachtet bleiben.
Paper, Code und Gewichte lassen sich über dots.tts / dots.tts-soar / Technischer Bericht nachverfolgen.
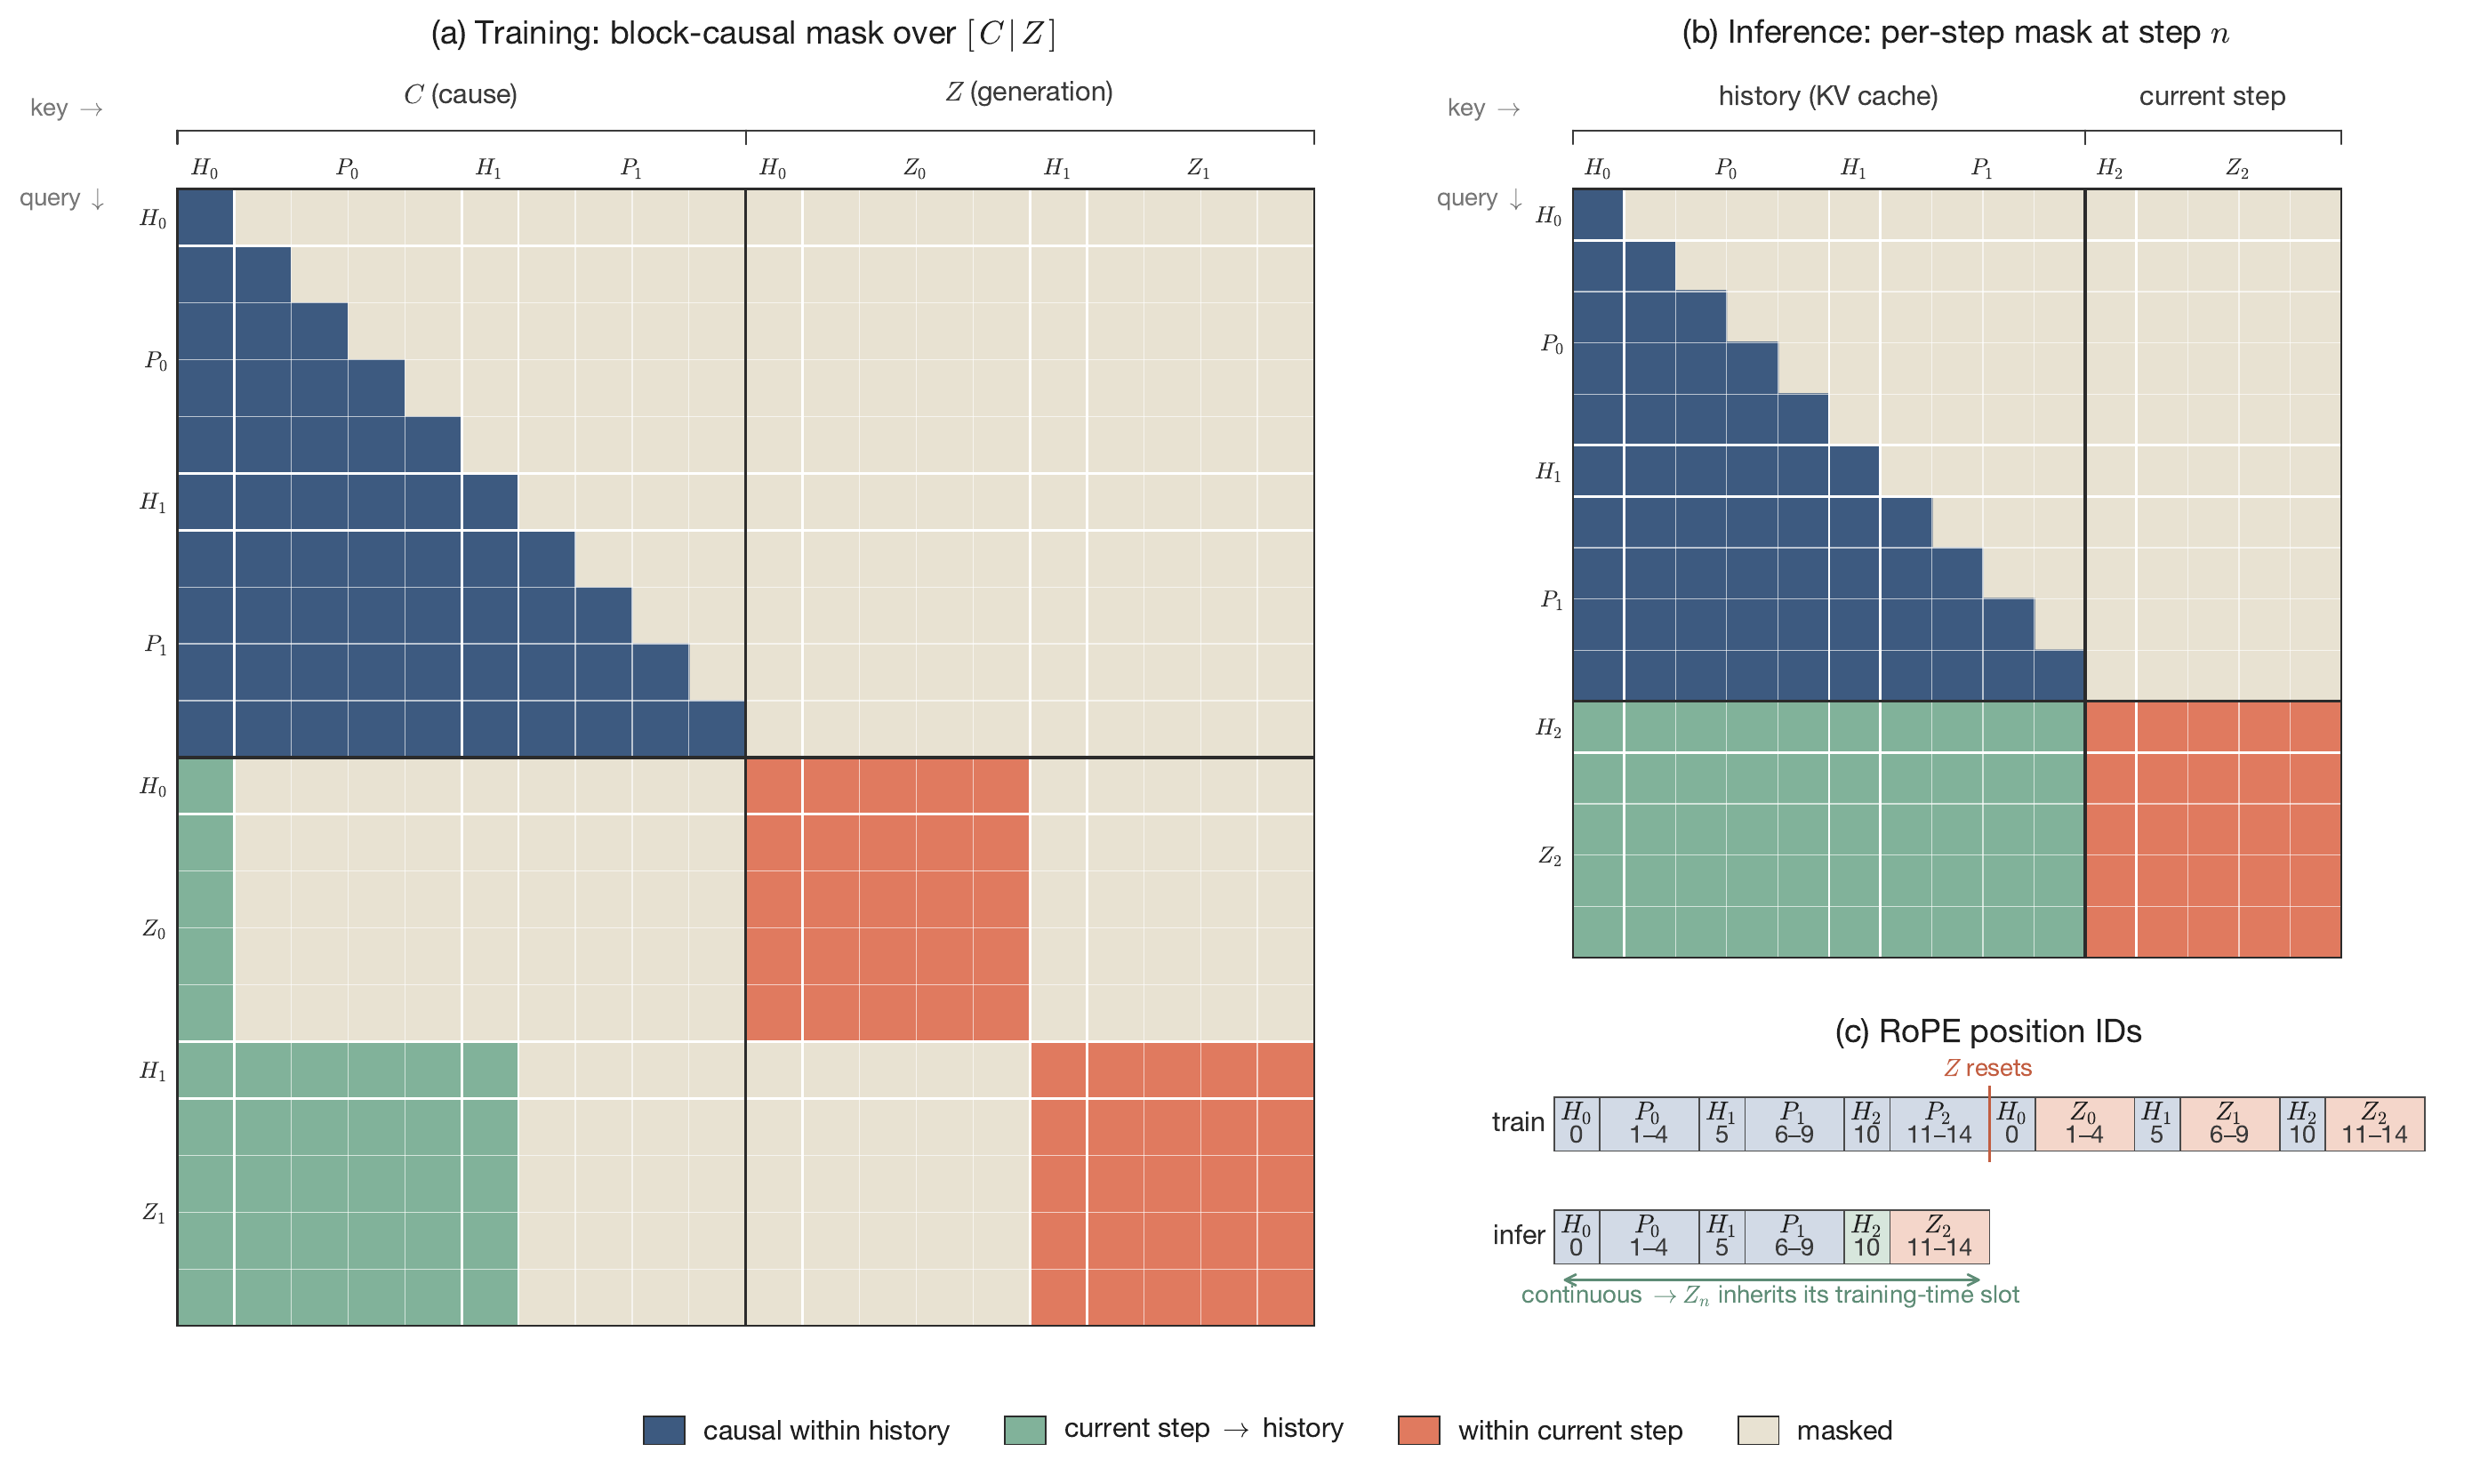
Jede Zeile behält ihre Quellarchitektur, Metrik oder Aufgabendefinition; Ergebnisse ohne gemeinsames Protokoll bleiben getrennt.
| Modell | Architektur oder Evidenz | Abdeckung |
|---|---|---|
| dots.tts | Basis-Checkpoint mit kontinuierlichem Flow | Inhalt, Klangfarbe und Langform-Konsistenz |
| dots.tts-soar | Open-Domain-/Inferenzmodell | Stabilität und Latenz unter derselben Referenz |
| autoregressive Codec-TTS | Token-für-Token-Baseline | erstes Audio, Wiederholungen und Fehlerakkumulation |
Zahlen, Abkürzungen, Polyphone und Pausen Wort für Wort prüfen, bevor die Ähnlichkeit beurteilt wird. Sprecher-Scores können Auslassungen und Wiederholungen übersehen; ASR kann kopierte Störgeräusche und Raumfärbung übersehen.
SOAR und Basis mit identischem Text und identischer Referenz vergleichen. Zeit bis zum ersten Audio, Real-Time-Faktor, Speicherspitze und Langform-Stabilität getrennt erfassen, statt ein System mit einem einzigen flüssigen Satz zusammenzufassen.
Zero-Shot-Stimmkonditionierung ist keine Einwilligung des Sprechers. Öffentliche Nutzung braucht Erlaubnis, Zweckbegrenzung und einen Widerrufsweg.
Emotion, Akzent und Umgebung können zusammen mit der Klangfarbe kopiert werden; das Modell kann die Extraktion eines reinen Identitätsfaktors nicht garantieren.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die folgenden Paper, Repositories oder Modellkarten zurückführen.