Mô hình
dots.tts: Các biến tiềm ẩn âm thanh liên tục, khớp luồng và giọng nói tầm xa 48 kHz
Tổng hợp bài phát biểu / Đọc chuyên sâu bài viết
Tổng hợp bài phát biểu / Đọc chuyên sâu bài viết
© 2026 TelkNet. Đã đăng ký Bản quyền.
TỔNG HỢP GIỌNG NÓI
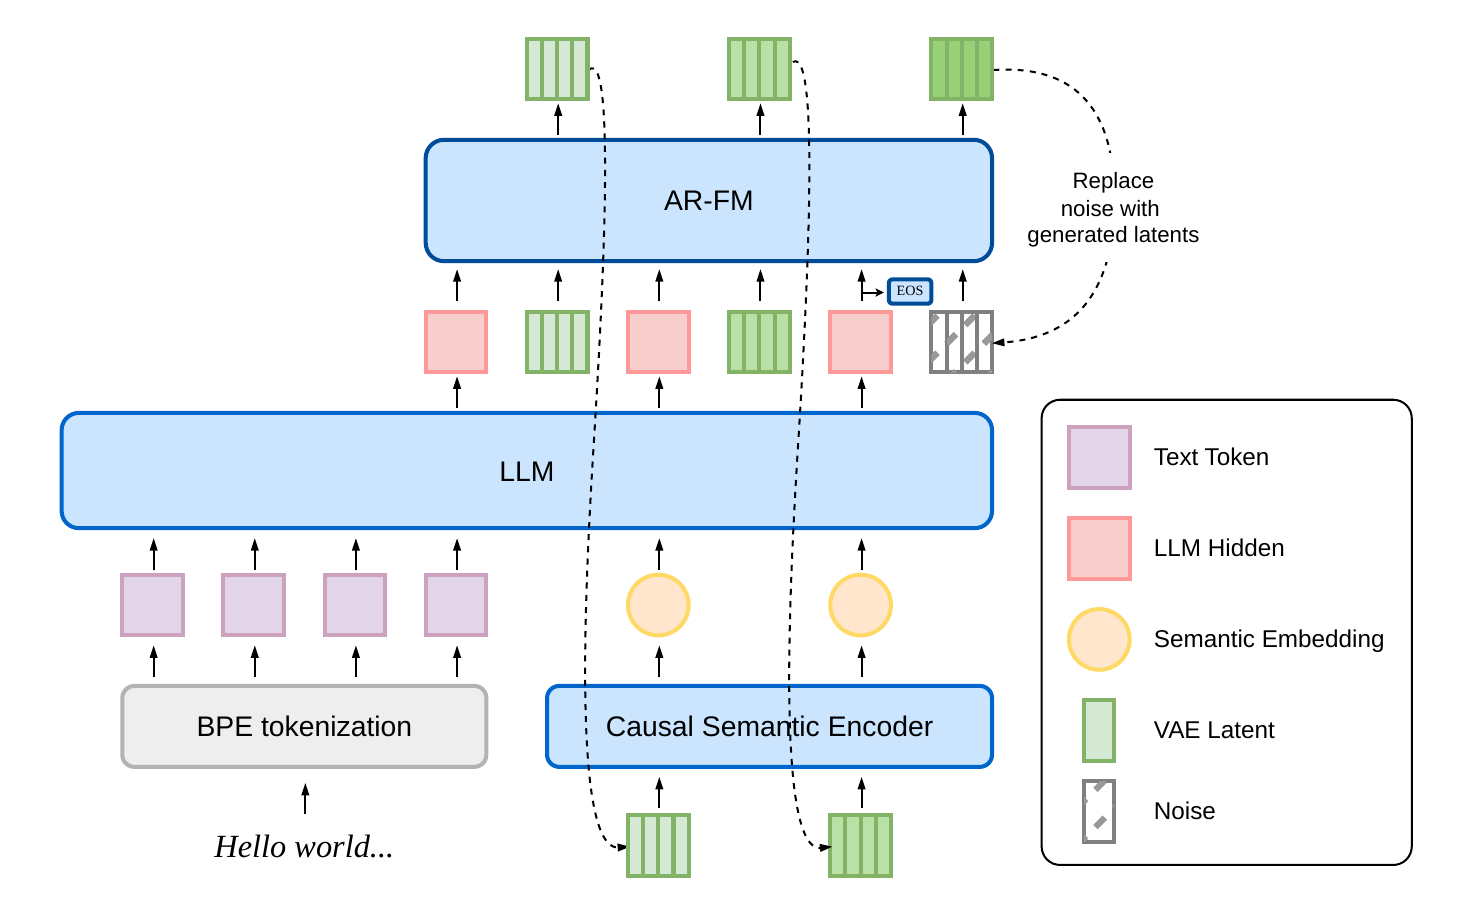
dots.tts không quy giọng nói về các token âm thanh rời rạc. AudioVAE cung cấp các đặc trưng tiềm ẩn liên tục, một bộ mã hóa ngữ nghĩa nén các patch đã sinh cho backbone ngôn ngữ, và một đầu flow dự đoán quỹ đạo âm học tiếp theo.
Mô hình học L=E||v_θ(x_t,t,h,s)-u_t||², với điều kiện là trạng thái ẩn ngôn ngữ h và thông tin người nói s. SOAR bổ sung cơ chế căn chỉnh tự hiệu chỉnh; MF chưng cất quỹ đạo xuống còn bốn lần đánh giá.
Bảng Seed-TTS-Eval chính thức ghi nhận SOAR đạt SIM trung bình 79.2 trên ba tập split đã công bố, còn mô hình MeanFlow bốn bước đạt 78.2. SOAR được căn chỉnh tự hiệu chỉnh; MeanFlow chưng cất một quỹ đạo teacher dài hơn thành student bốn bước, qua đó thay đổi cả tốc độ lẫn các dạng lỗi âm học.
Tài liệu hướng dẫn sử dụng chính thức khuyến nghị một đoạn tham chiếu ngắn, sạch, có bản chép lời khớp với phần ghi âm. Khoảng mười giây thường là đủ; prompt dài hơn không tự động cải thiện việc nhân bản giọng. Lấy mẫu ngẫu nhiên khi không có tham chiếu không tạo ra một danh tính nhân vật ổn định.
dots.tts đặt điều kiện cho flow matching liên tục dựa trên văn bản, tham chiếu người nói và ngữ cảnh âm học. dots.tts-soar điều chỉnh quá trình huấn luyện và trọng số để tăng độ bền trong miền mở và thay đổi hành vi suy luận. LongCat-AudioDiT cũng dùng sinh liên tục, nhưng đó không phải cùng một tác vụ hay giao thức.
Tổng hợp giọng nói đã đi từ đặc trưng âm học cộng vocoder, qua token codec tự hồi quy, rồi đến diffusion và flow matching. Thay đổi đáng kể nằm ở quỹ đạo và cách đặt điều kiện, chứ không phải một nhãn cũ-sang-mới đơn giản. Một đoạn tham chiếu ngắn mang theo cả âm sắc, giọng vùng miền, micro và không gian phòng.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tđặc trưng tiềm ẩn âm học liên tụcz_<tngữ cảnh âm học trước đótextvăn bản đã chuẩn hóa và các điều khiểnAudioVAE nén dạng sóng 48 kHz thành các đặc trưng tiềm ẩn liên tục, tái mã hóa ngữ nghĩa khôi phục tín hiệu nội dung, backbone Qwen2.5 mô hình hóa ngữ cảnh, và một đầu flow khôi phục phần âm học. z liên tục không phải token codec rời rạc.
SOAR ở 32 bước và MF ở bốn bước cho thấy sự đánh đổi giữa chất lượng và độ trễ. Độ tương đồng, WER, độ trễ âm thanh đầu tiên và hệ số thời gian thực toàn trình phải được xem xét riêng biệt.
Bài báo, mã nguồn và trọng số có thể tra cứu qua dots.tts / dots.tts-soar / Báo cáo kỹ thuật.
Mỗi hàng giữ nguyên kiến trúc nguồn, chỉ số hoặc định nghĩa tác vụ của nó; các kết quả không chung giao thức vẫn được tách riêng.
| Mô hình | Kiến trúc hoặc bằng chứng | Phạm vi |
|---|---|---|
| dots.tts | checkpoint continuous-flow gốc | nội dung, âm sắc và độ nhất quán khi dài |
| dots.tts-soar | mô hình miền mở/suy luận | độ ổn định và độ trễ với cùng một tham chiếu |
| autoregressive codec TTS | baseline từng token | âm thanh đầu tiên, lặp lại và tích lũy lỗi |
Hãy kiểm tra từng từ các con số, chữ viết tắt, âm đa đọc và khoảng ngừng trước khi đánh giá độ tương đồng. Điểm người nói có thể bỏ sót các phần thiếu hoặc lặp; ASR có thể bỏ qua nhiễu được sao chép và màu sắc phòng.
So sánh SOAR và bản base với cùng văn bản và tham chiếu. Ghi lại riêng thời gian đến âm thanh đầu tiên, hệ số thời gian thực, bộ nhớ đỉnh và độ ổn định khi nghe dài, thay vì tóm gọn một hệ thống bằng một câu nghe trôi chảy.
Điều kiện hóa giọng nói zero-shot không đồng nghĩa với sự đồng ý của người nói. Sử dụng công khai cần có sự cho phép, giới hạn mục đích và một lối để rút lại.
Cảm xúc, giọng vùng miền và môi trường có thể bị sao chép cùng âm sắc; mô hình không thể đảm bảo tách ra một yếu tố danh tính thuần túy.
Tên mô hình, các con số và giới hạn được truy vền đến các bài báo, kho mã nguồn hoặc model card bên dưới.