Modell
dots.tts: Kontinuerlige akustiske latente variabler, flyttilpasning og 48 kHz langdistansetale
Talesyntese / Intensiv lesing av artikler
Talesyntese / Intensiv lesing av artikler
© 2026 TelkNet. Alle rettigheter forbeholdt.
TALESYNTESE
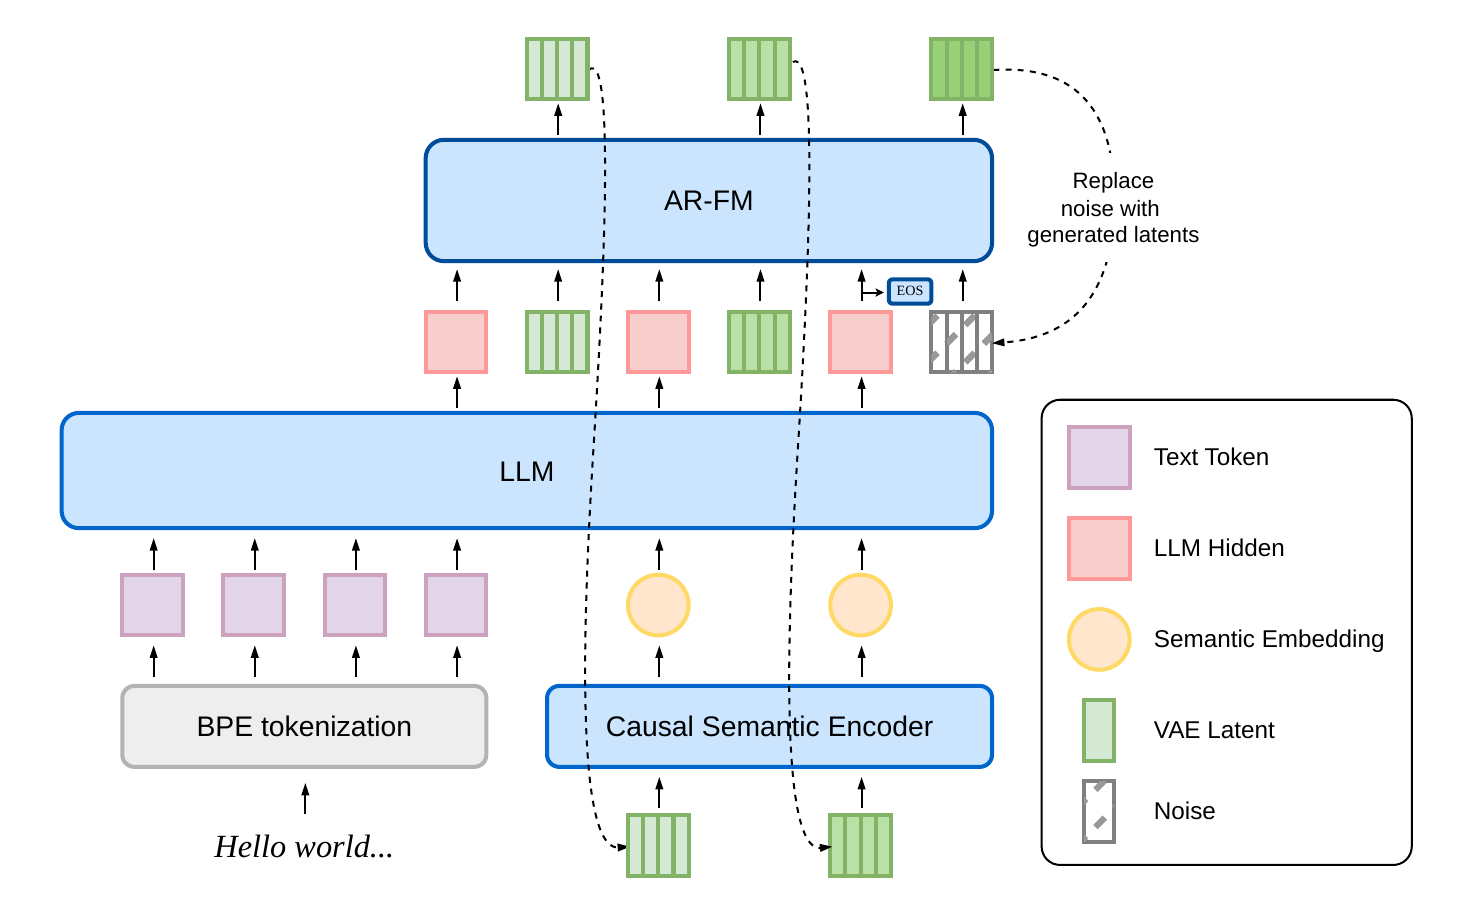
dots.tts reduserer ikke tale til diskrete lydtokens. AudioVAE leverer kontinuerlige latentvariable, en semantisk koder komprimerer de genererte patchene for språkryggraden, og et flow-hode forutsier neste akustiske bane.
Modellen lærer L=E||v_θ(x_t,t,h,s)-u_t||², betinget på språkets skjulte tilstand h og talerinformasjon s. SOAR legger til selvkorrigerende tilpasning; MF destillerer banen til fire evalueringer.
Den offisielle Seed-TTS-Eval-tabellen gir SOAR 79.2 i gjennomsnittlig SIM over de tre publiserte splittene og MeanFlow-modellen med fire steg 78.2. SOAR er selvkorrigerende tilpasset; MeanFlow destillerer en lengre lærerbane til en firestegs student, noe som endrer både hastighet og akustiske feilmønstre.
De offisielle bruksnotatene anbefaler en kort, ren referanse der transkripsjonen stemmer med opptaket. Omtrent ti sekunder er normalt nok; lengre prompter forbedrer ikke kloningen automatisk. Tilfeldig sampling uten referanse gir ingen varig karakteridentitet.
dots.tts betinger kontinuerlig flow matching på tekst, talerreferanse og akustisk kontekst. dots.tts-soar justerer trening og vekter for robusthet i åpent domene og for inferensatferd. LongCat-AudioDiT bruker også kontinuerlig generering, men det er ikke samme oppgave eller protokoll.
Talesyntese har beveget seg fra akustiske trekk pluss vokodere via autoregressive codec-tokens til diffusjon og flow matching. Den viktige endringen ligger i bane og betinging, ikke i en enkel etikett fra gammelt til nytt. En kort referanse bærer klangfarge, aksent, mikrofon og rom samlet.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tkontinuerlig akustisk latentvariabelz_<ttidligere akustisk konteksttextnormalisert tekst og kontrollerAudioVAE komprimerer 48 kHz-bølgeformer til kontinuerlige latentvariable, semantisk omkoding gjenoppretter innholdssignaler, Qwen2.5-ryggraden modellerer konteksten, og et flow-hode gjenoppretter akustikken. Kontinuerlig z er ikke et diskret codec-token.
SOAR med 32 steg og MF med fire steg synliggjør en avveining mellom kvalitet og latens. Likhet, WER, latens til første lyd og full sanntidsfaktor må holdes adskilt.
Artikkel, kode og vekter kan følges via dots.tts / dots.tts-soar / Teknisk rapport.
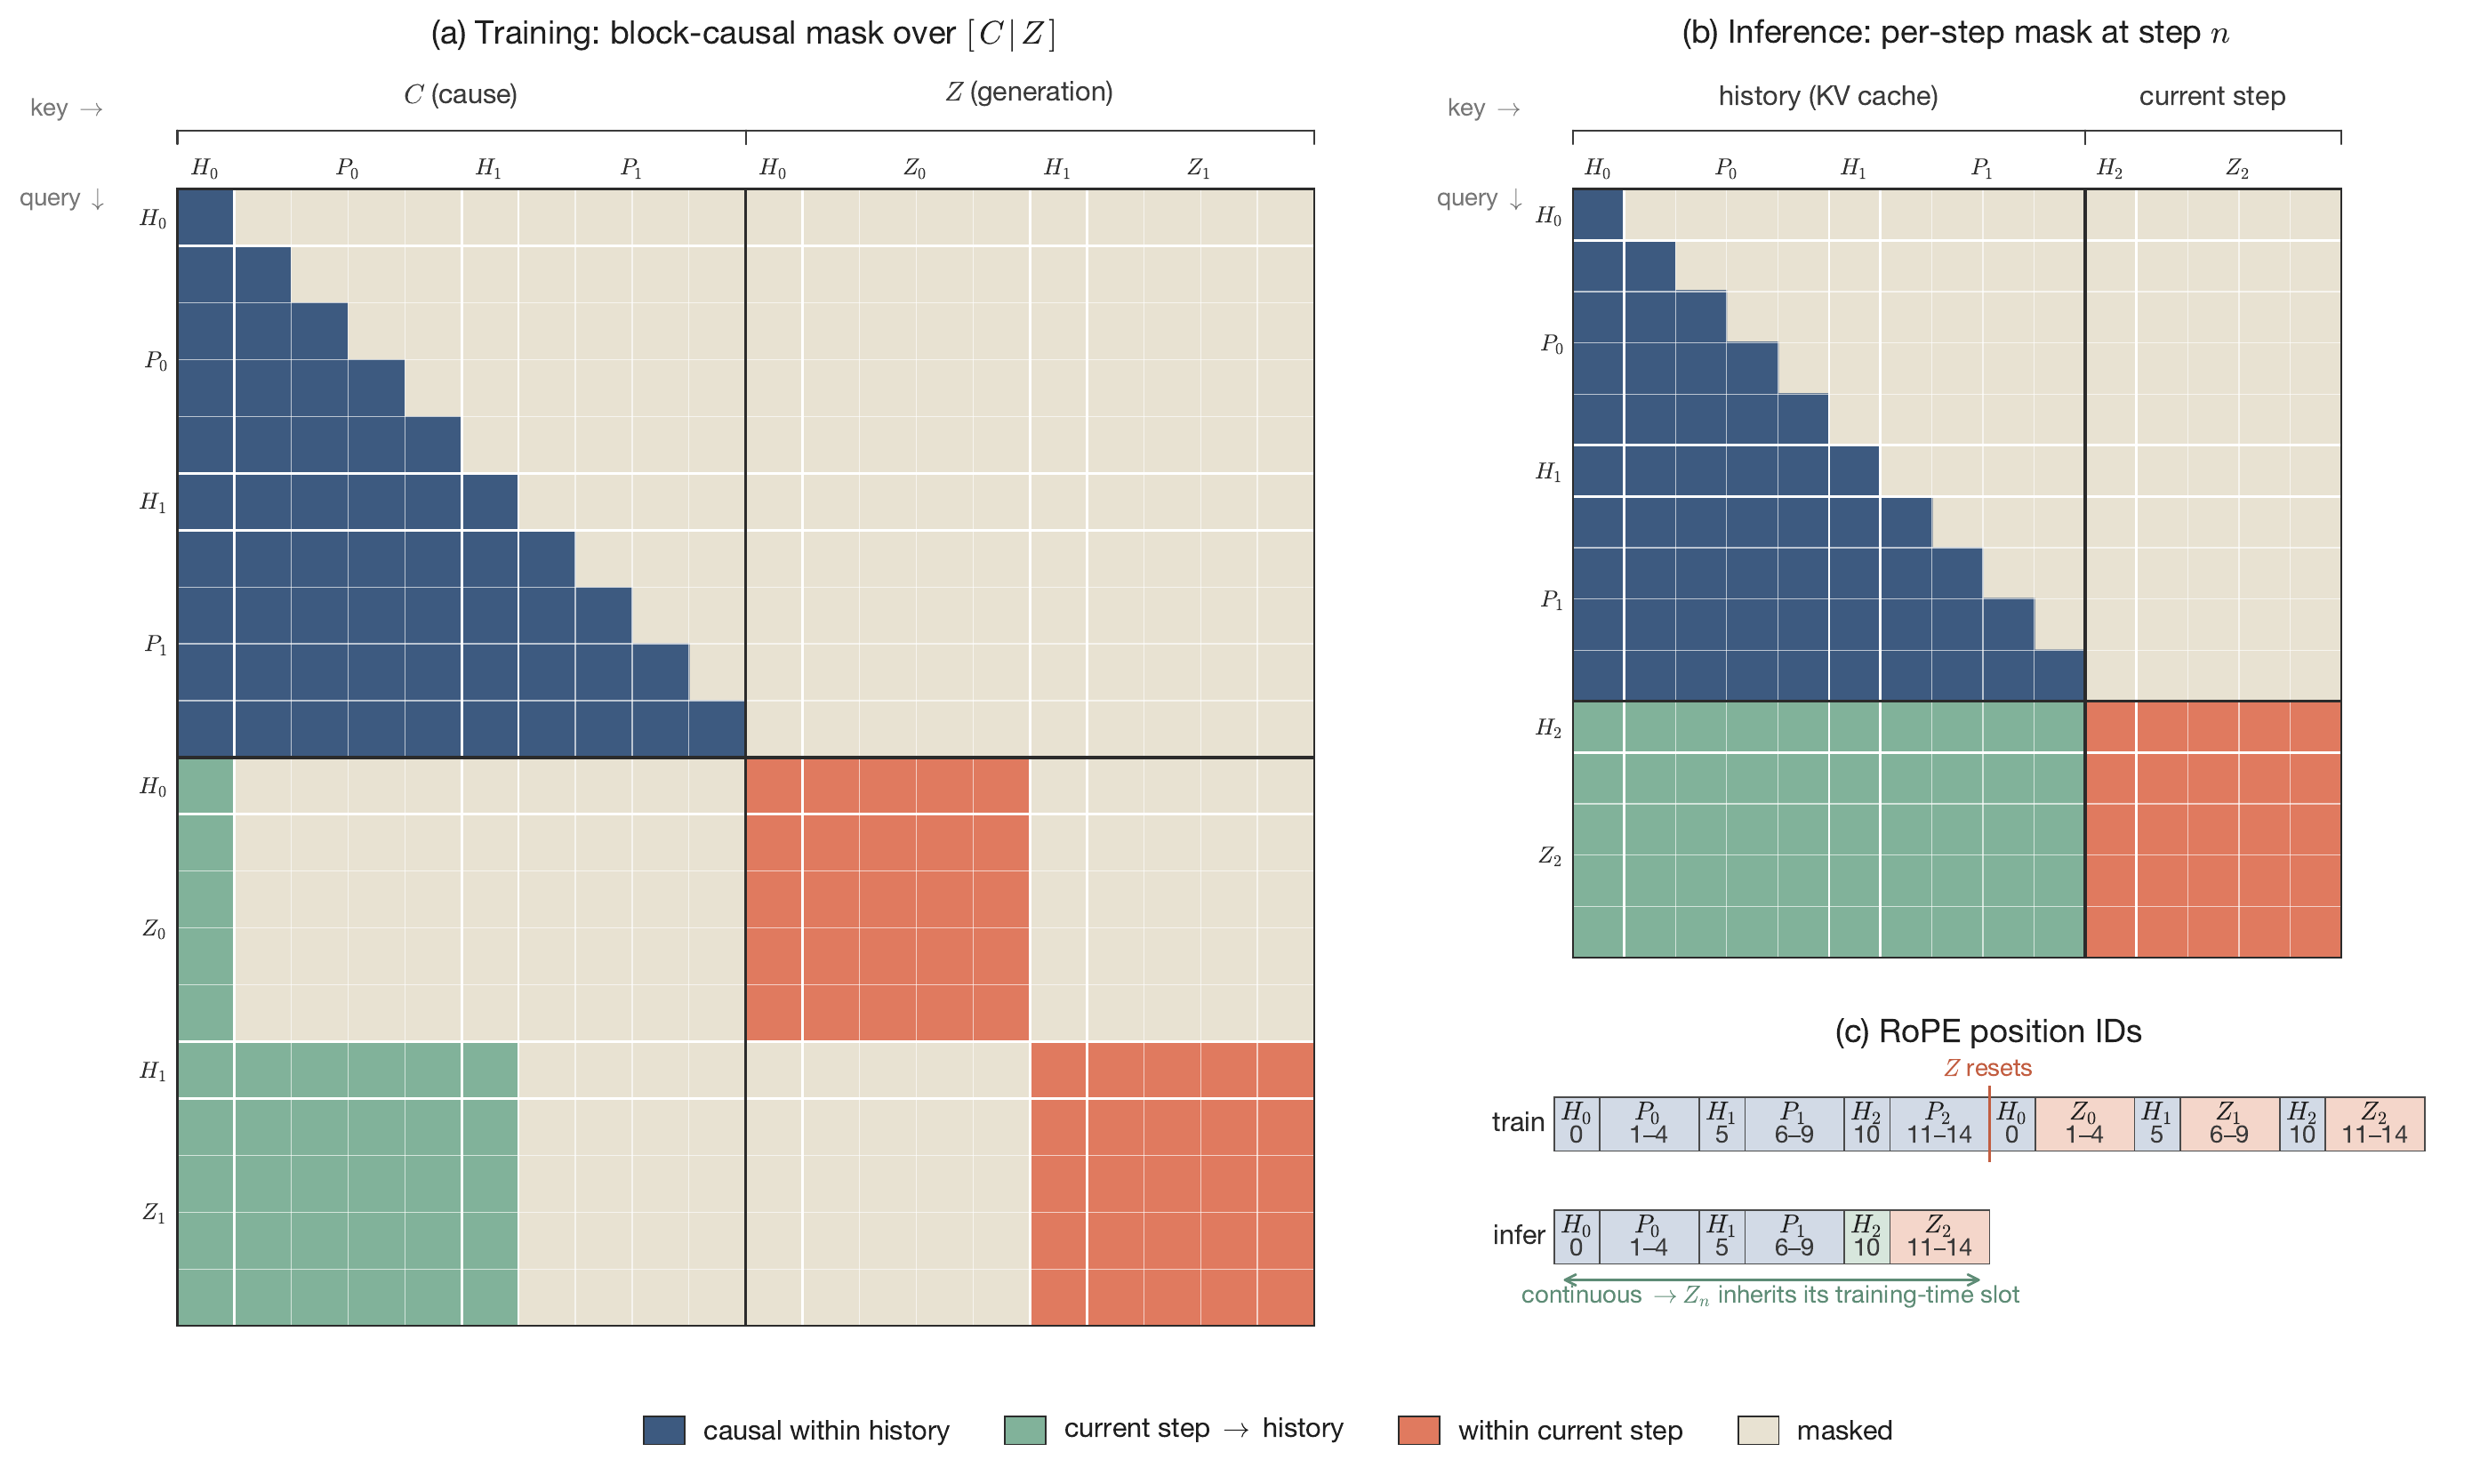
Hver rad beholder sin kildearkitektur, metrikk eller oppgavedefinisjon; resultater uten felles protokoll holdes adskilt.
| Modell | Arkitektur eller evidens | Omfang |
|---|---|---|
| dots.tts | basis-sjekkpunkt med kontinuerlig flow | innhold, klangfarge og langformatskonsistens |
| dots.tts-soar | modell for åpent domene/inferens | stabilitet og latens under samme referanse |
| autoregressiv codec-TTS | token-for-token-baseline | første lyd, repetisjon og feilakkumulering |
Kontroller tall, forkortelser, ord med flere uttaler og pauser ord for ord før likheten vurderes. Scorer for talerlikhet kan overse utelatelser og repetisjoner; ASR kan overse kopiert støy og romfarging.
Sammenlign SOAR og basismodellen med identisk tekst og referanse. Mål tid til første lyd, sanntidsfaktor, toppminne og langformatstabilitet hver for seg i stedet for å oppsummere et system med én flytende setning.
Zero-shot-stemmebetinging er ikke samtykke fra taleren. Offentlig bruk krever tillatelse, formålsbegrensninger og en vei til tilbaketrekking.
Følelser, aksent og omgivelser kan kopieres sammen med klangfargen; modellen kan ikke garantere at en ren identitetsfaktor trekkes ut.
Modellnavn, tall og begrensninger kan spores til artiklene, repositoriene eller modellkortene nedenfor.