Modelvalg
dots.tts: Kontinuerlige akustiske latente variabler, flowmatching og 48 kHz langdistancetale
Talesyntese / Intensiv læsning af papirer
Talesyntese / Intensiv læsning af papirer
© 2026 TelkNet. Alle rettigheder forbeholdes.
TALESYNTESE
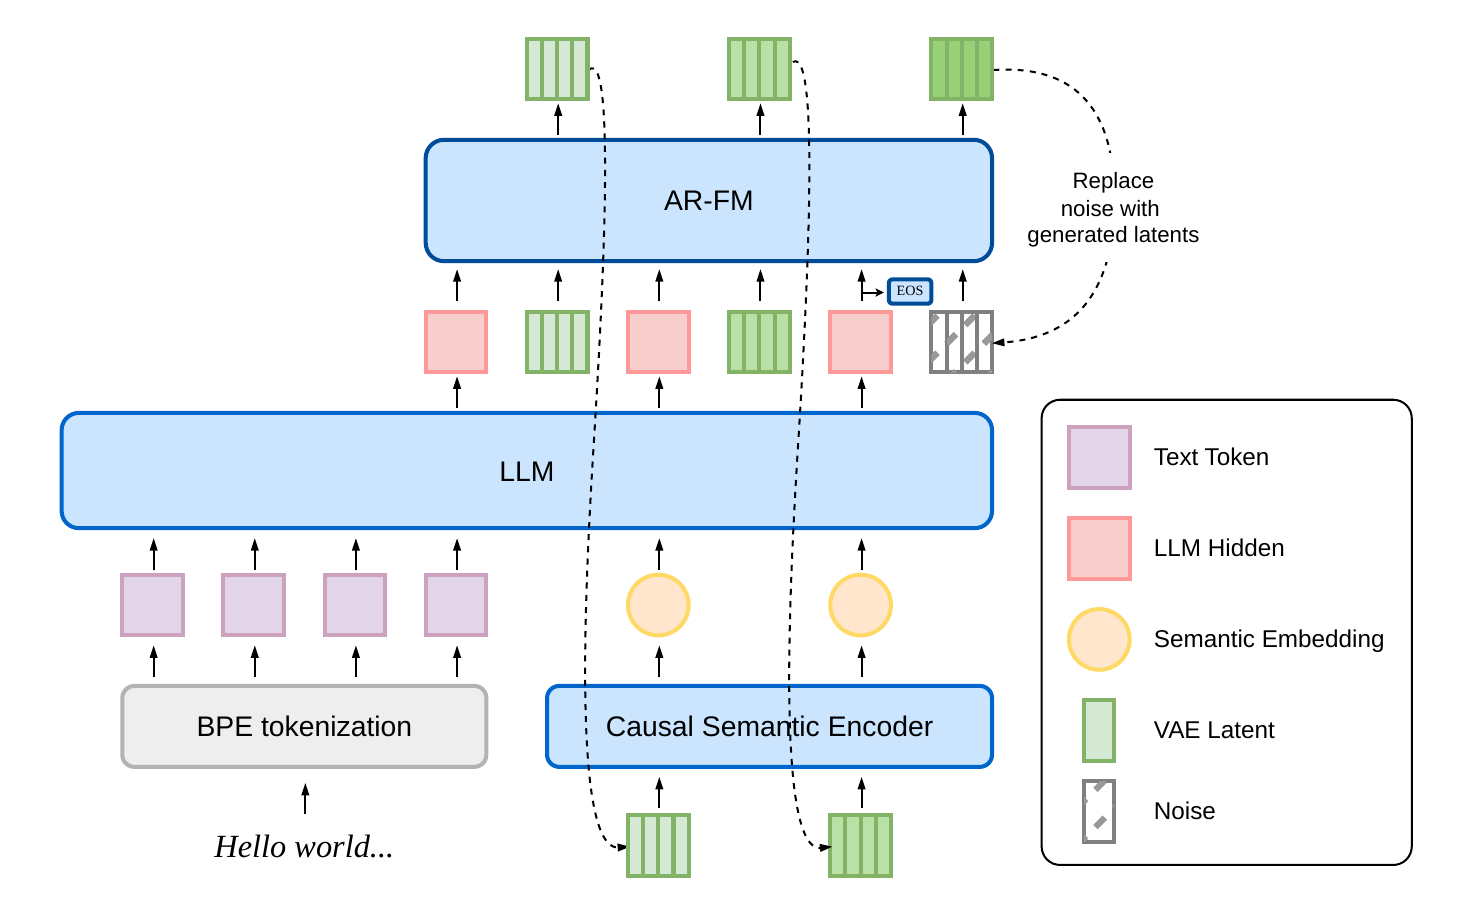
dots.tts reducerer ikke tale til diskrete lydtokens. AudioVAE leverer kontinuerte latenter, en semantisk encoder komprimerer de genererede patches til sprogrygraden, og et flow-hoved forudsiger den næste akustiske trajektorie.
Modellen lærer L=E||v_θ(x_t,t,h,s)-u_t||², betinget af sprogets skjulte tilstand h og talerinformation s. SOAR tilføjer selvkorrigerende alignment; MF destillerer trajektorien ned til fire evalueringer.
Den officielle Seed-TTS-Eval-tabel giver SOAR 79.2 i gennemsnitlig SIM på tværs af de tre offentliggjorte splits og fire-trins MeanFlow-modellen 78.2. SOAR er selvkorrigerende alignet; MeanFlow destillerer en længere teacher-trajektorie ned i en fire-trins student, hvilket ændrer både hastighed og akustiske fejlformer.
De officielle brugsnoter anbefaler en kort, ren reference, hvis transskription matcher optagelsen. Cirka ti sekunder er normalt nok; længere prompts forbedrer ikke automatisk kloningen. Tilfældig sampling uden reference er ikke en vedvarende karakteridentitet.
dots.tts betinger kontinuert flow matching på tekst, talerreference og akustisk kontekst. dots.tts-soar justerer træning og vægte for robusthed og inferensadfærd i åbne domæner. LongCat-AudioDiT bruger også kontinuert generering, men det er ikke samme opgave eller protokol.
Talesyntese bevægede sig fra akustiske træk plus vocodere gennem autoregressive codec-tokens til diffusion og flow matching. Den vigtige ændring er trajektorien og betingelsen, ikke en simpel etiket fra gammel til ny. En kort reference bærer klangfarve, accent, mikrofon og rum samlet.
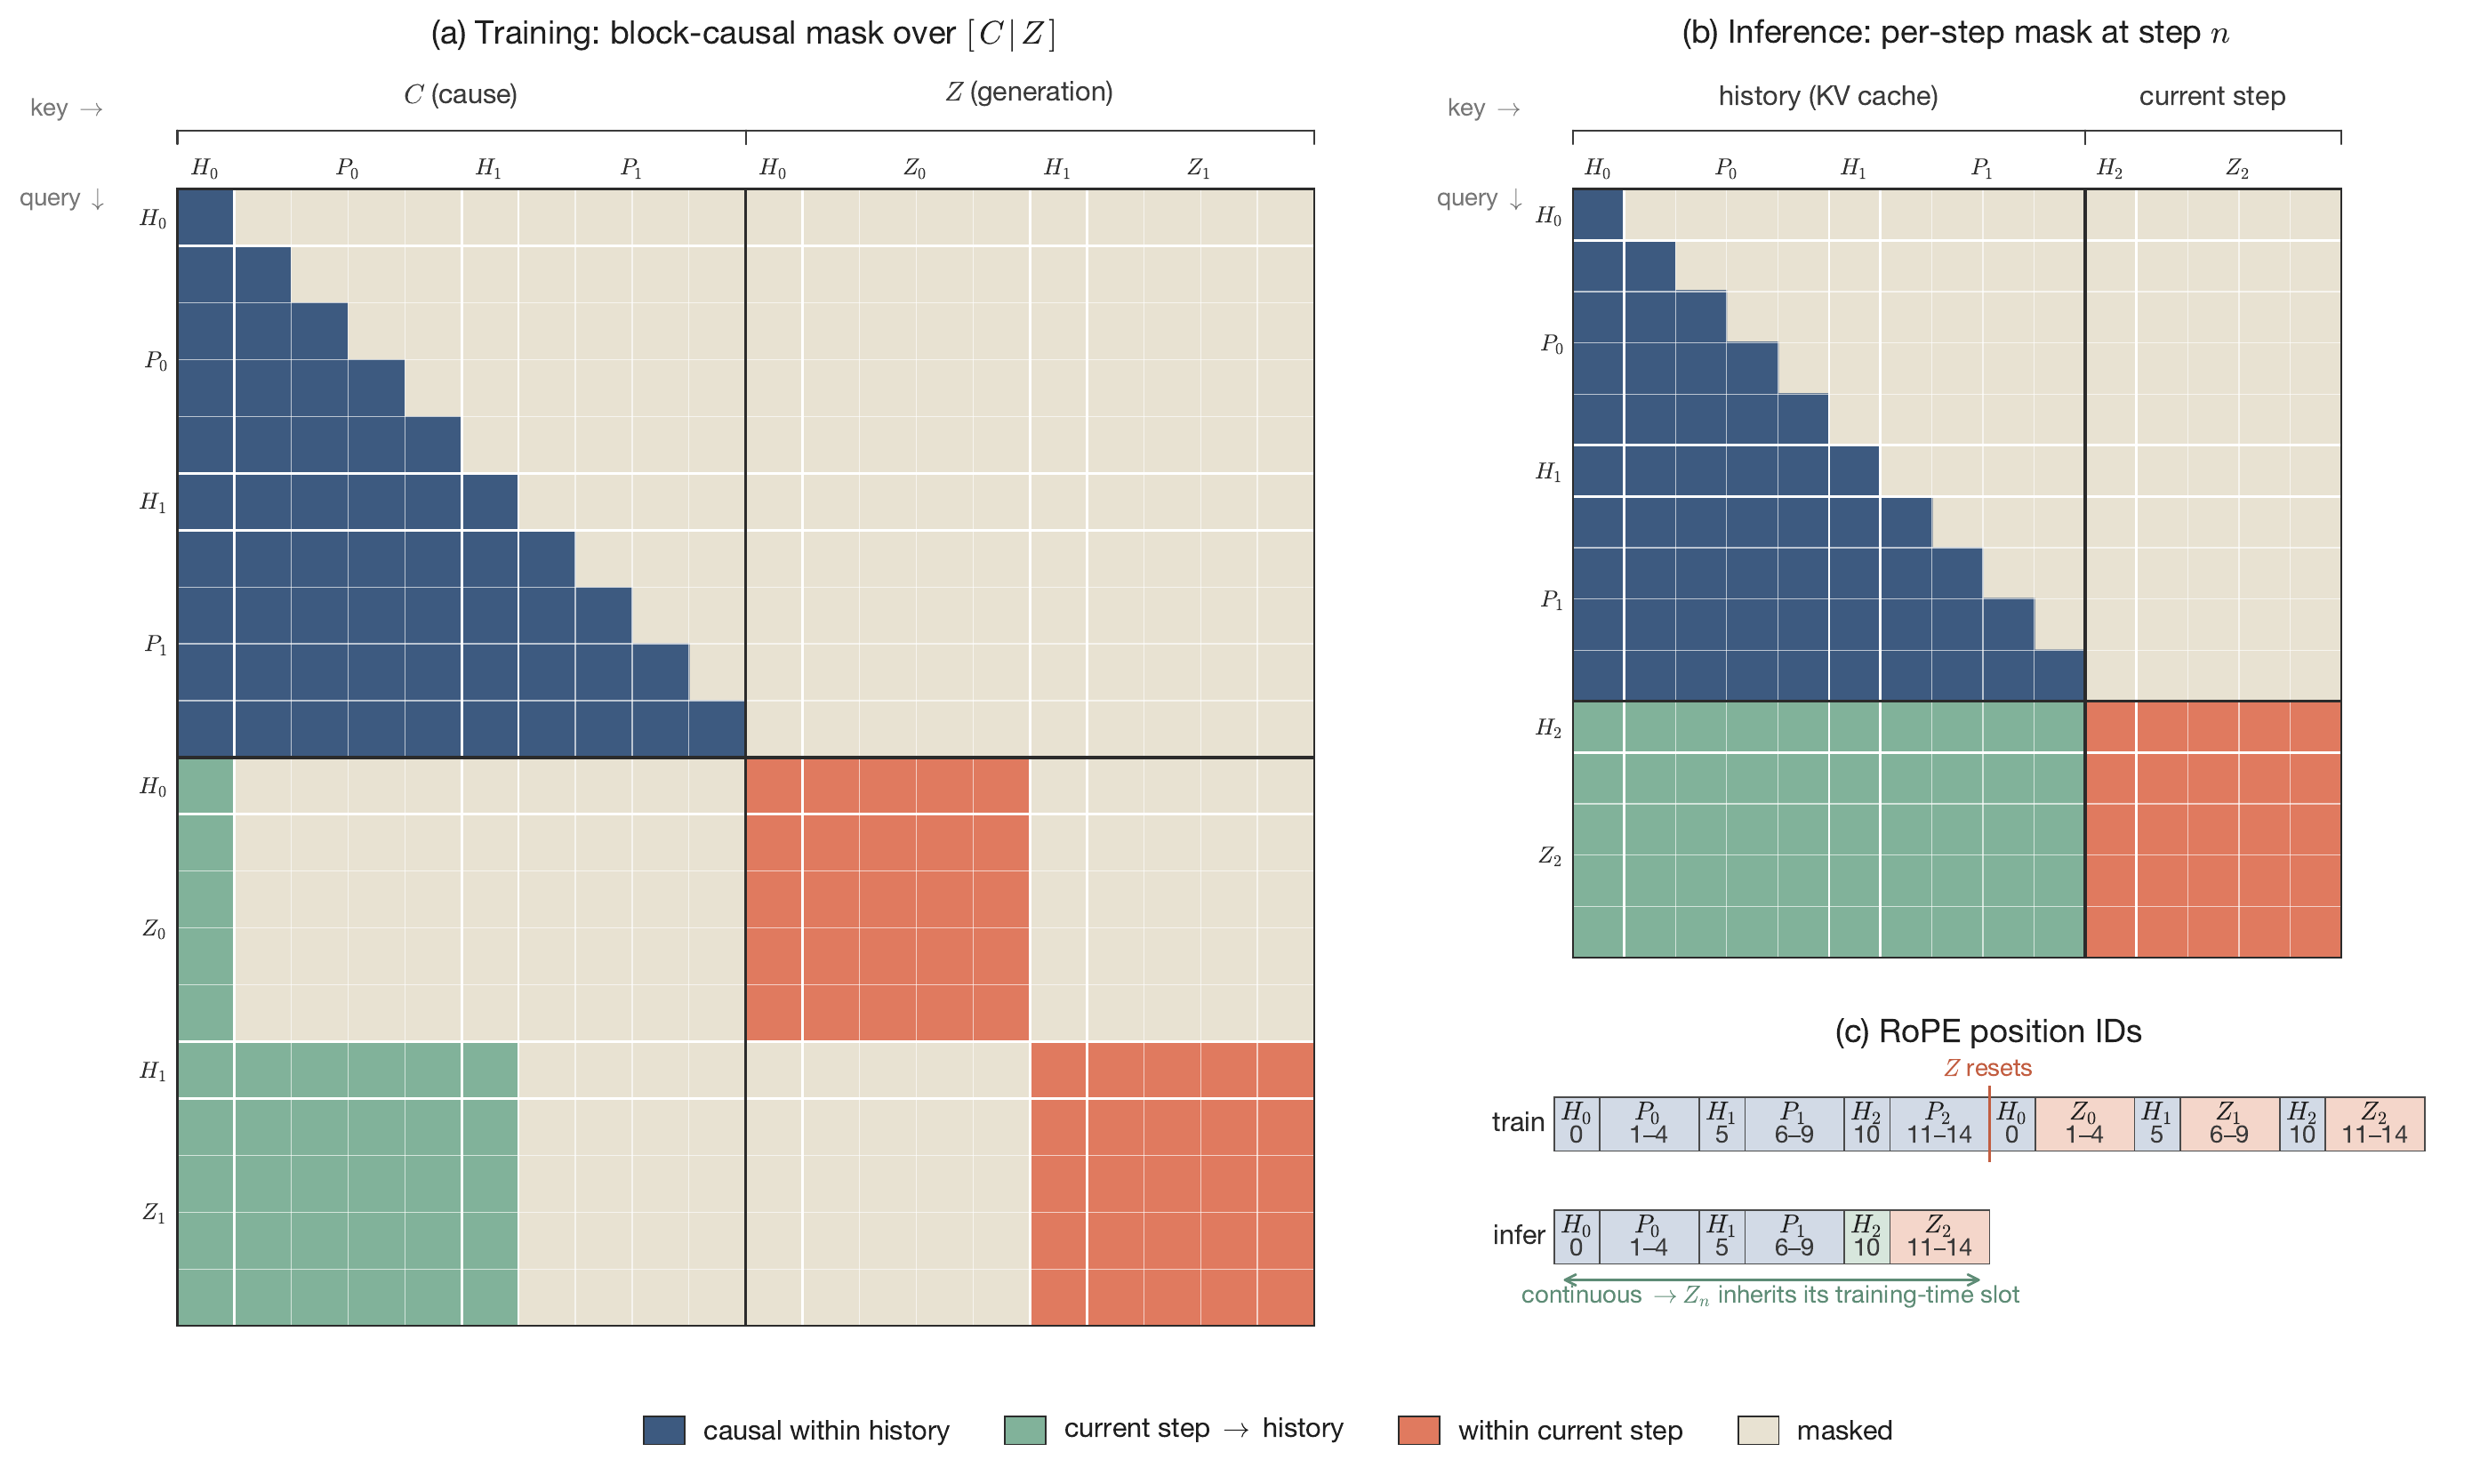
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tkontinuert akustisk latentz_<ttidligere akustisk konteksttextnormaliseret tekst og kontrollerAudioVAE komprimerer 48 kHz-bølgeformer til kontinuerte latenter, semantisk genkodning genskaber indholdssignaler, Qwen2.5-rygraden modellerer konteksten, og et flow-hoved genskaber akustikken. Kontinuert z er ikke en diskret codec-token.
SOAR med 32 trin og MF med fire trin afslører en afvejning mellem kvalitet og latenstid. Similarity, WER, latenstid til første lyd og fuld realtidsfaktor skal holdes adskilt.
Artikel, kode og vægte kan følges via dots.tts / dots.tts-soar / teknisk rapport.
Hver række bevarer sin kildes arkitektur, metrik eller opgavedefinition; resultater uden en fælles protokol holdes adskilt.
| Model | Arkitektur eller evidens | Dækning |
|---|---|---|
| dots.tts | kontinuert flow-basischeckpoint | indhold, klangfarve og langformatskonsistens |
| dots.tts-soar | model til åbent domæne/inferens | stabilitet og latenstid under samme reference |
| autoregressiv codec-TTS | token-for-token-baseline | første lyd, gentagelse og fejlakkumulering |
Tjek tal, forkortelser, polyfoner og pauser ord for ord, før ligheden bedømmes. Taler-scores kan overse udeladelser og gentagelser; ASR kan overse kopieret støj og rumklang.
Sammenlign SOAR og base med identisk tekst og reference. Mål tid til første lyd, realtidsfaktor, spids-hukommelse og langformatstabilitet hver for sig i stedet for at opsummere et system med én flydende sætning.
Zero-shot-stemmebetingelse er ikke talerens samtykke. Offentlig brug kræver tilladelse, formålsbegrænsninger og en vej til at trække stemmen tilbage.
Følelser, accent og omgivelser kan kopieres sammen med klangfarven; modellen kan ikke garantere, at en ren identitetsfaktor kan udskilles.
Modelnavne, tal og begrænsninger kan spores tilbage til artiklerne, repositorierne eller modelkortene nedenfor.