Modelo
dots.tts: Variáveis latentes acústicas contínuas, correspondência de fluxo e fala de longo alcance de 48 kHz
Síntese de fala / Leitura intensiva de artigos
Síntese de fala / Leitura intensiva de artigos
© 2026 TelkNet. Todos os direitos reservados.
SÍNTESE DE FALA
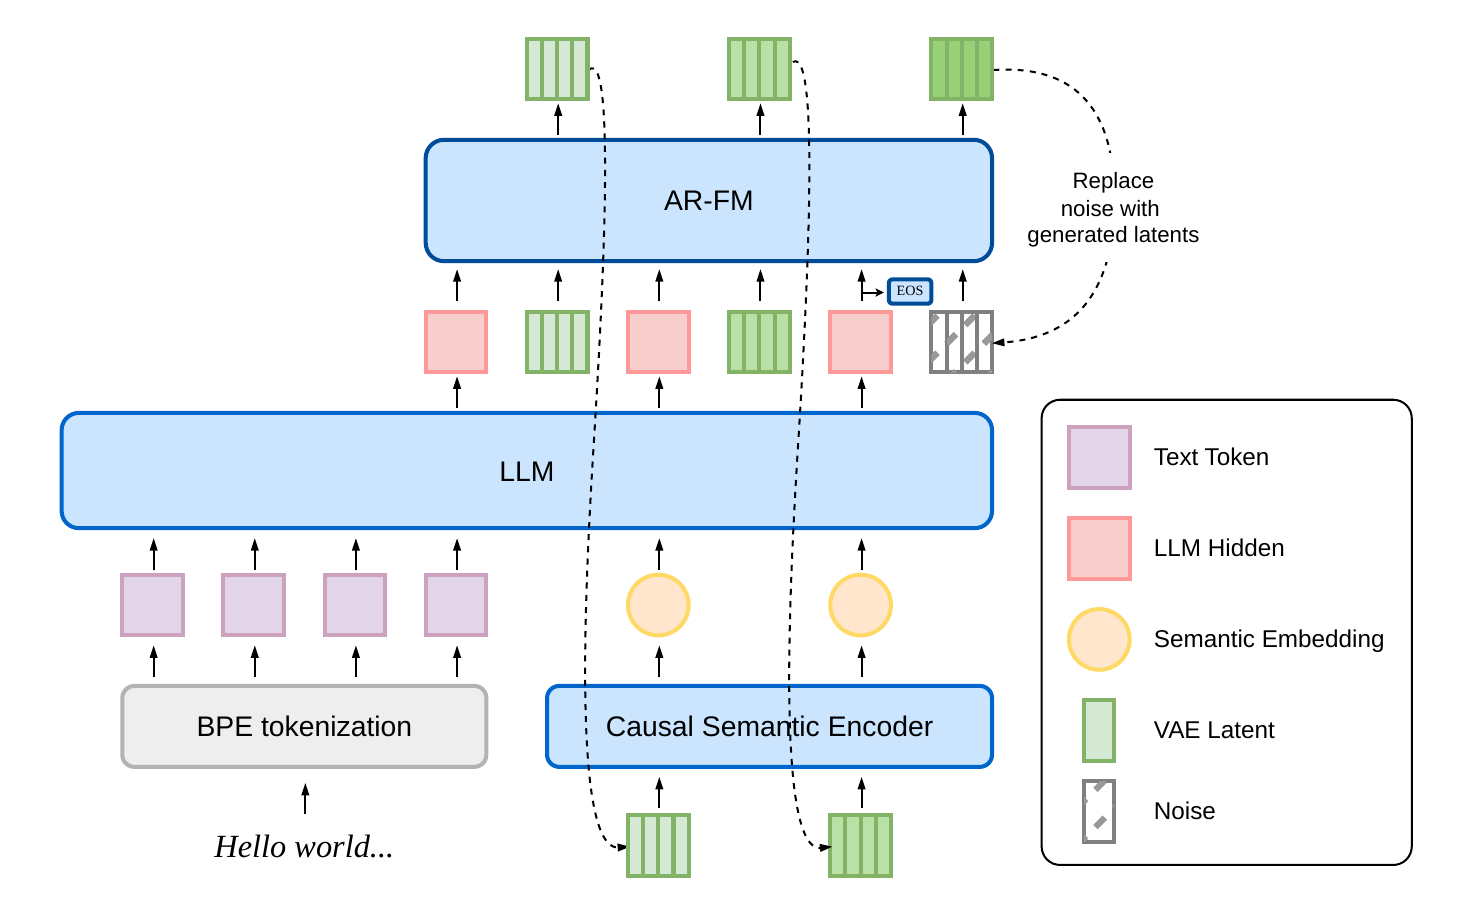
O dots.tts não reduz a fala a tokens de áudio discretos. O AudioVAE fornece latentes contínuos, um codificador semântico comprime os trechos gerados para a espinha dorsal de linguagem, e uma cabeça de fluxo prevê a próxima trajetória acústica.
O modelo aprende L=E||v_θ(x_t,t,h,s)-u_t||², condicionado ao estado oculto de linguagem h e à informação de locutor s. O SOAR adiciona alinhamento autocorretivo; o MF destila a trajetória para quatro avaliações.
A tabela oficial do Seed-TTS-Eval dá ao SOAR SIM médio de 79.2 nos três recortes publicados e ao modelo MeanFlow de quatro passos 78.2. O SOAR conta com alinhamento autocorretivo; o MeanFlow destila uma trajetória mais longa do professor em um estudante de quatro passos, mudando tanto a velocidade quanto os modos de falha acústica.
As notas oficiais de uso recomendam uma referência curta e limpa, cuja transcrição corresponda à gravação. Cerca de dez segundos costumam bastar; prompts mais longos não melhoram a clonagem por si sós. Amostragem aleatória sem referência não é uma identidade de personagem persistente.
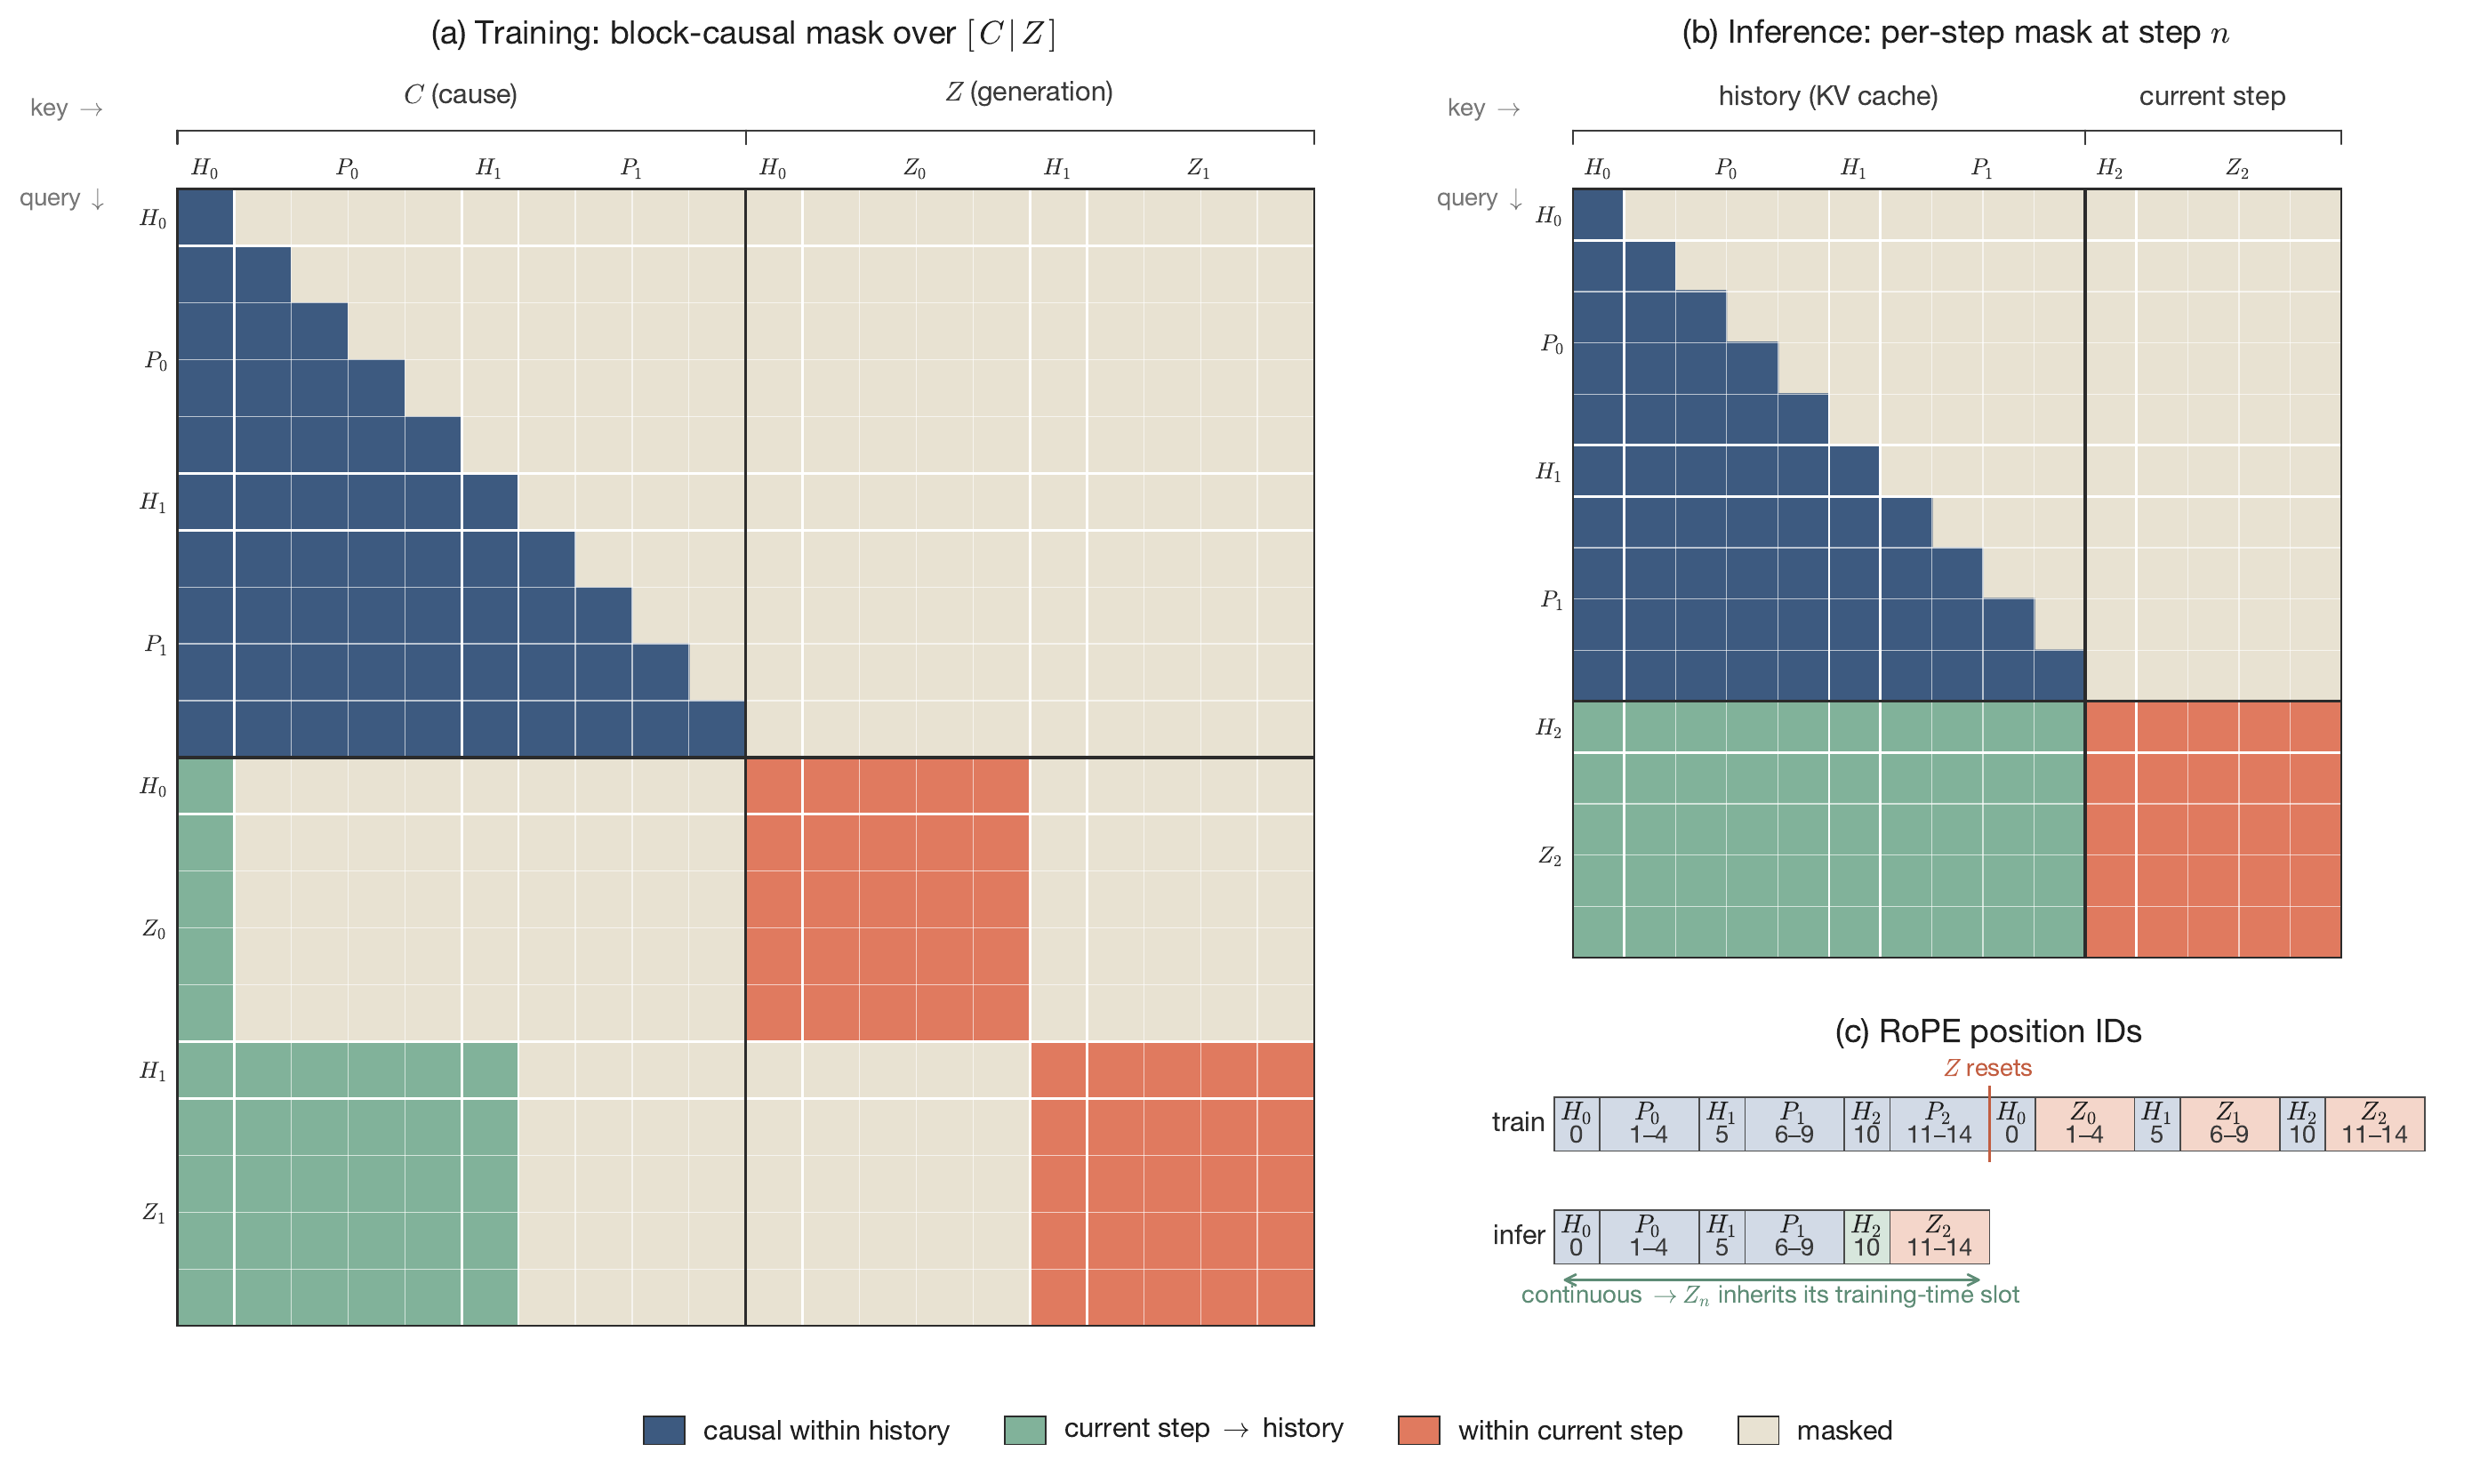
O dots.tts condiciona o flow matching contínuo ao texto, à referência de locutor e ao contexto acústico. O dots.tts-soar ajusta treinamento e pesos para robustez em domínio aberto e comportamento de inferência. O LongCat-AudioDiT também usa geração contínua, mas não é a mesma tarefa nem o mesmo protocolo.
A síntese de fala saiu das características acústicas com vocoders, passou pelos tokens de codec autoregressivos e chegou à difusão e ao flow matching. A mudança importante está na trajetória e no condicionamento, não em um rótulo simples de velho para novo. Uma referência curta carrega timbre, sotaque, microfone e ambiente ao mesmo tempo.
p(z₁:T|text)=∏_t pθ(z_t|z_<t,text), z_t∈R^dz_tlatente acústico contínuoz_<tcontexto acústico anteriortexttexto normalizado e controlesO AudioVAE comprime formas de onda de 48 kHz em latentes contínuos, a recodificação semântica restaura pistas de conteúdo, o backbone Qwen2.5 modela o contexto e uma cabeça de fluxo devolve a acústica. Um z contínuo não é um token de codec discreto.
O SOAR com 32 passos e o MF com quatro passos expõem um compromisso entre qualidade e latência. Similaridade, WER, latência até o primeiro áudio e fator de tempo real completo precisam permanecer separados.
O artigo, o código e os pesos podem ser consultados em dots.tts / dots.tts-soar / relatório técnico.
Cada linha mantém sua arquitetura de origem, métrica ou definição de tarefa; resultados sem um protocolo comum permanecem separados.
| Modelo | Arquitetura ou evidência | Escopo |
|---|---|---|
| dots.tts | checkpoint base de fluxo contínuo | conteúdo, timbre e consistência em formato longo |
| dots.tts-soar | modelo de domínio aberto/inferência | estabilidade e latência sob a mesma referência |
| TTS de codec autoregressivo | linha de base token a token | primeiro áudio, repetição e acúmulo de erros |
Verifique números, abreviações, palavras de pronúncia múltipla e pausas termo a termo antes de julgar a similaridade. Pontuações de locutor podem deixar passar omissões e repetições; o ASR pode não perceber ruído copiado e a coloração do ambiente.
Compare SOAR e base com texto e referência idênticos. Registre separadamente o tempo até o primeiro áudio, o fator de tempo real, o pico de memória e a estabilidade em formato longo, em vez de resumir um sistema com uma única frase fluente.
Condicionamento de voz zero-shot não é consentimento do locutor. O uso público exige permissão, limites de finalidade e um caminho de retirada.
Emoção, sotaque e ambiente podem ser copiados junto com o timbre; o modelo não garante a extração de um fator puro de identidade.
Nomes de modelos, números e limitações remetem aos artigos, repositórios ou cartões de modelo abaixo.