 模型
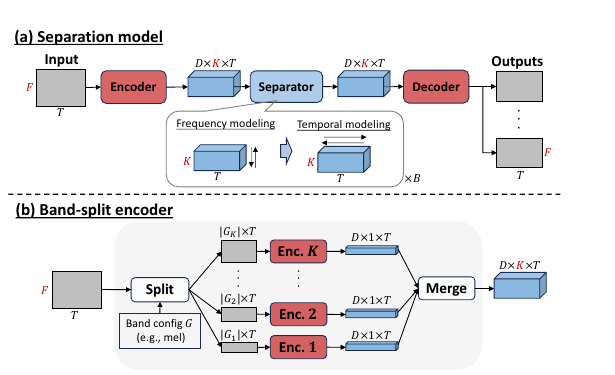
SFC-Locoformer:11.8 dB DnR 的自適應頻譜壓縮與對白邊界
論文精讀 / 影視聲音分離
閱讀全文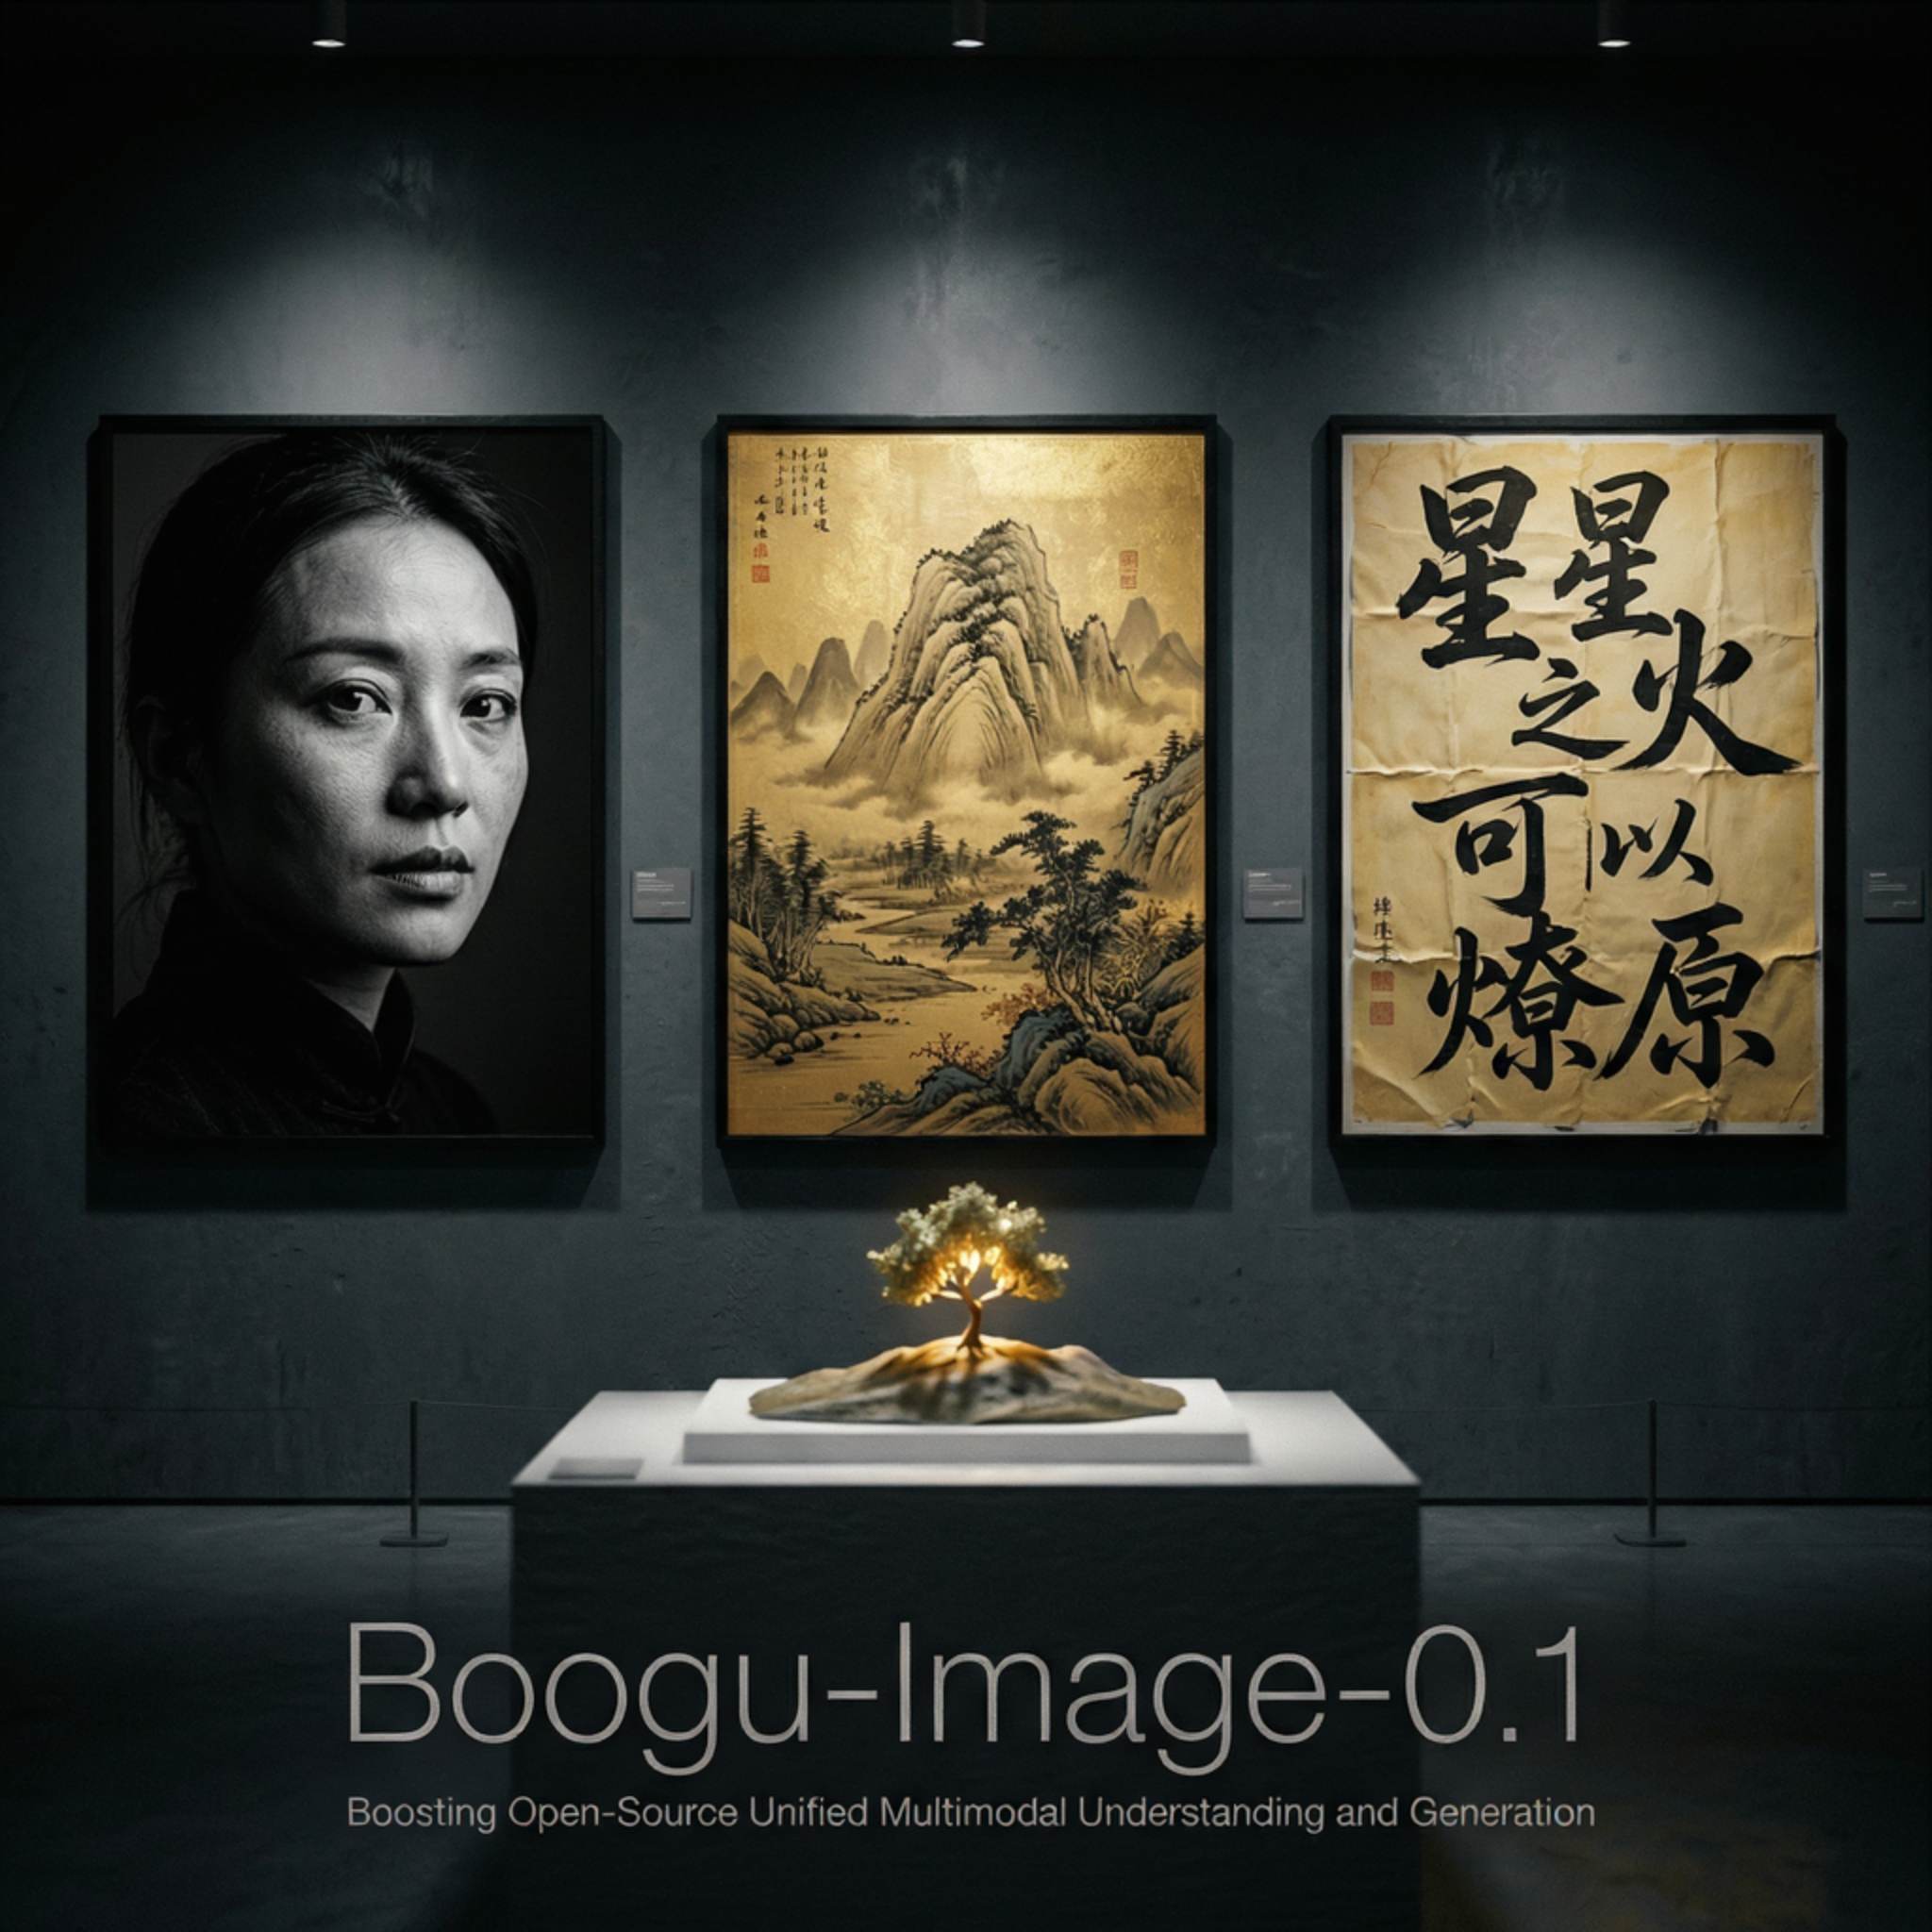 模型
Boogu-Image 0.1:Base、Turbo、Edit 三份權重的分工與失真風險
模型解剖 / 影像產生與編輯
閱讀全文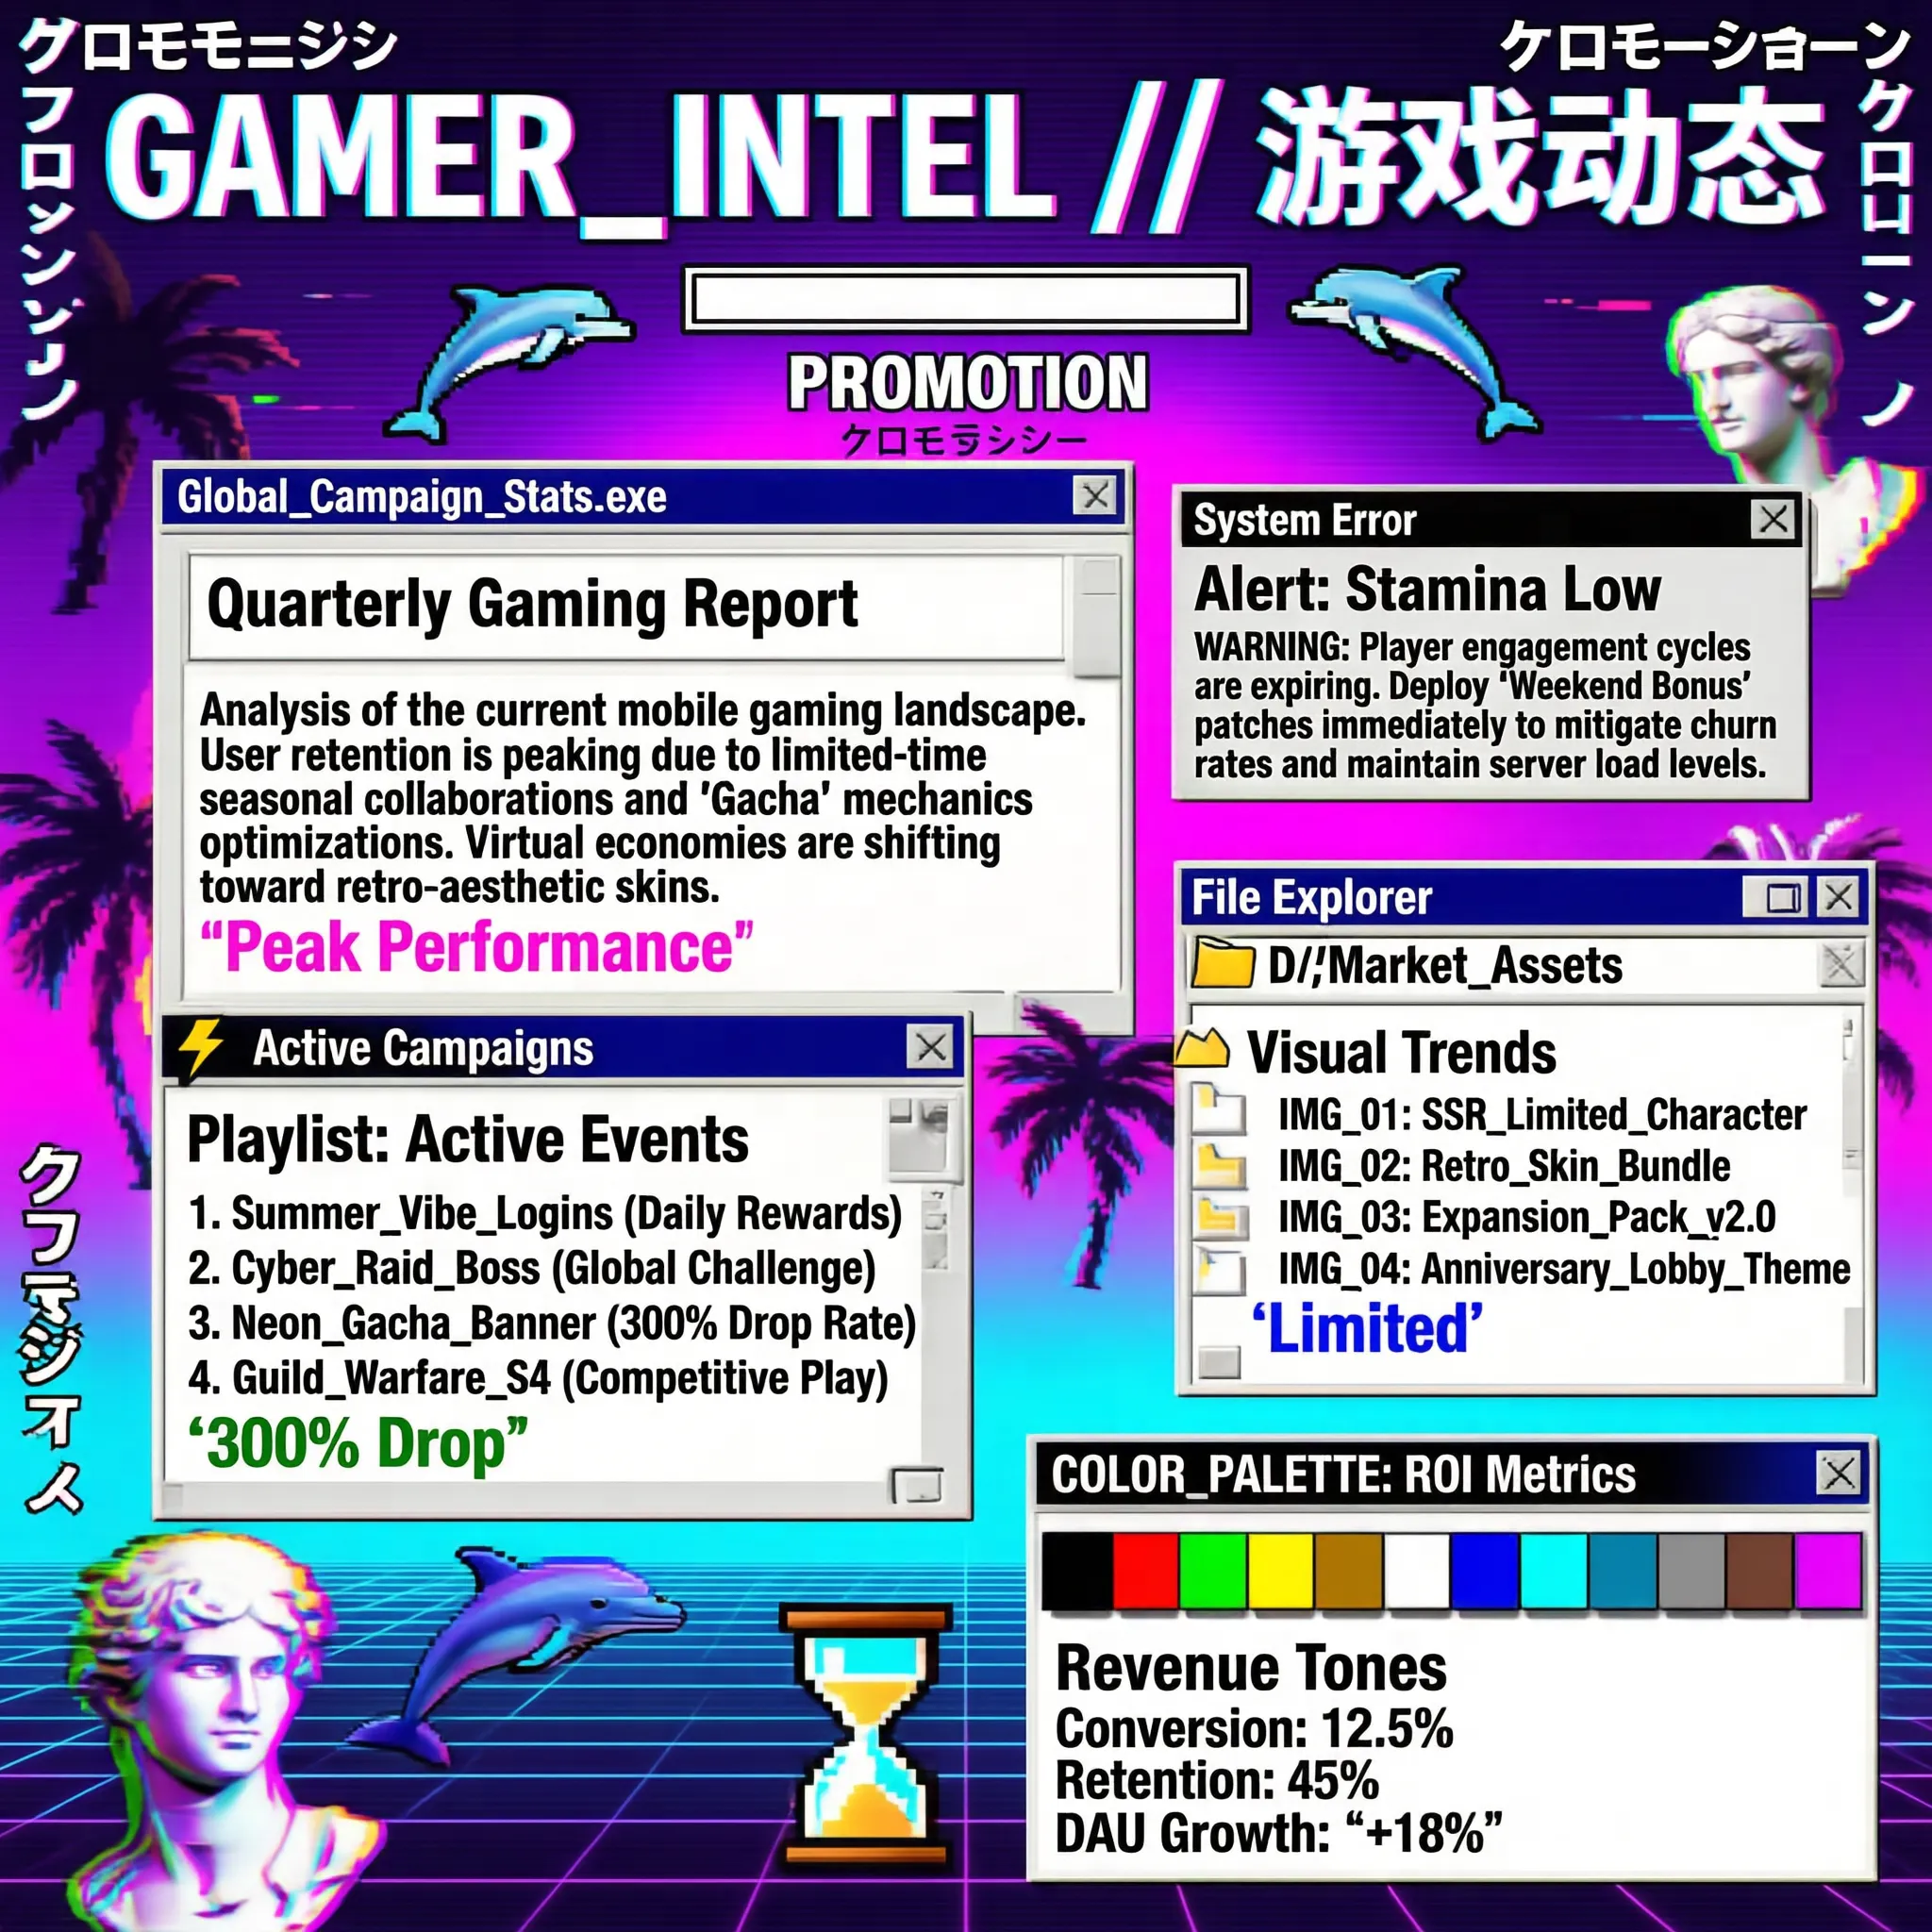 模型
SenseNova-U1 Infographic V2:50.3 分的評測範圍與資訊圖表邊界
專案模型 / 資訊圖表生成
閱讀全文 模型
LongCat-AudioDiT 3.5B:把說話人條件寫進音訊擴散 Transformer
論文精讀 / 零樣本語音克隆
閱讀全文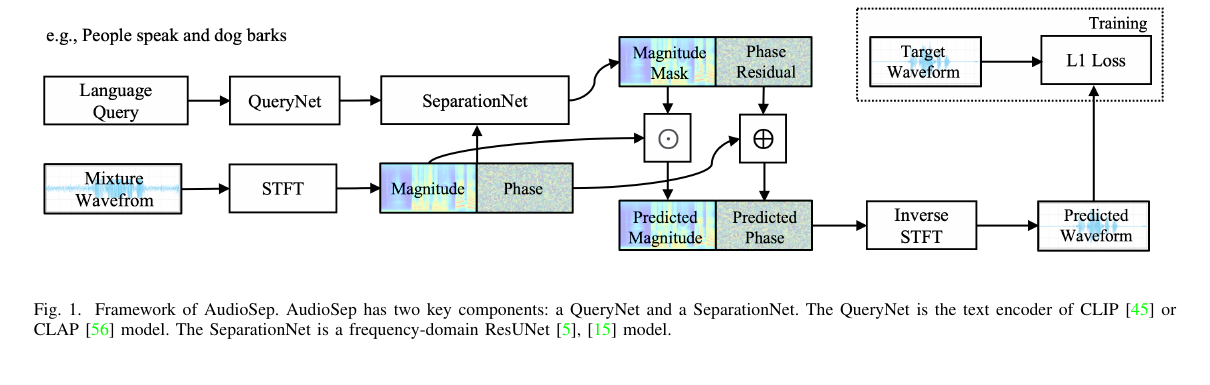 模型
AudioSep-Hive:用一句文字查詢分離任意聲音
聲音分離 / 技術筆記
閱讀全文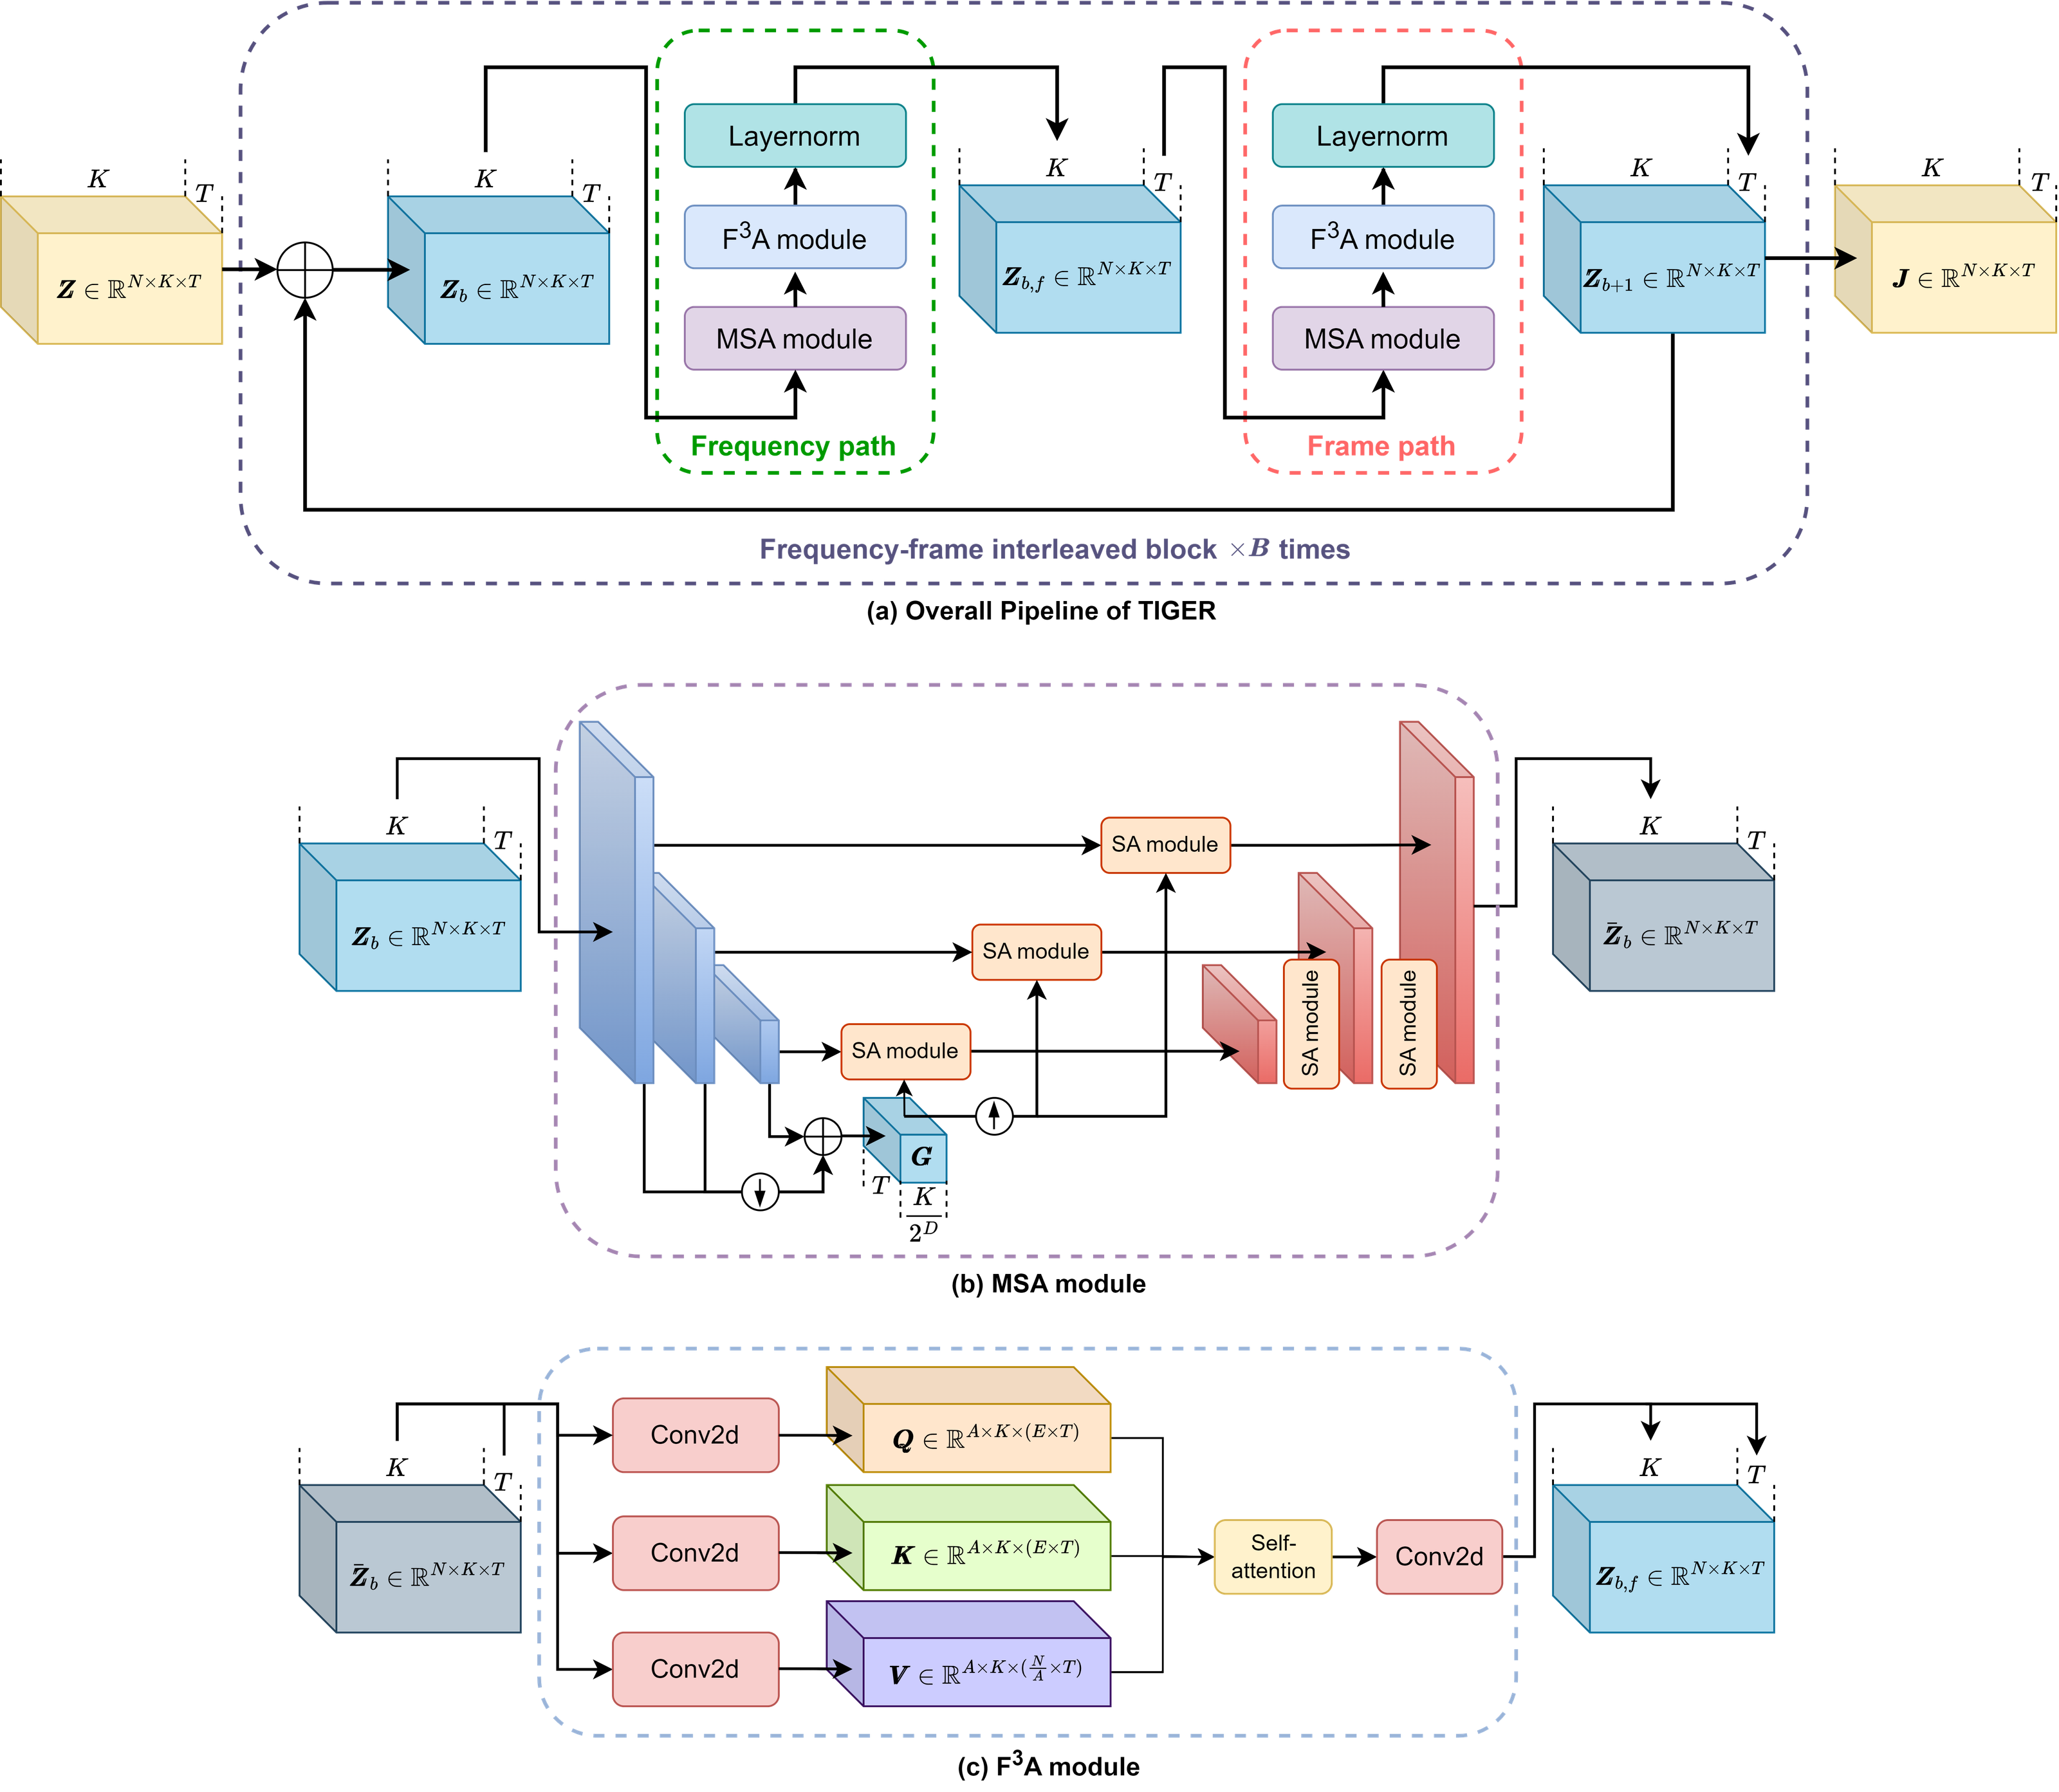 模型
BandIt 與 TIGER-DnR:影視三軌分離的計算分配之爭
影視音 / DnR
閱讀全文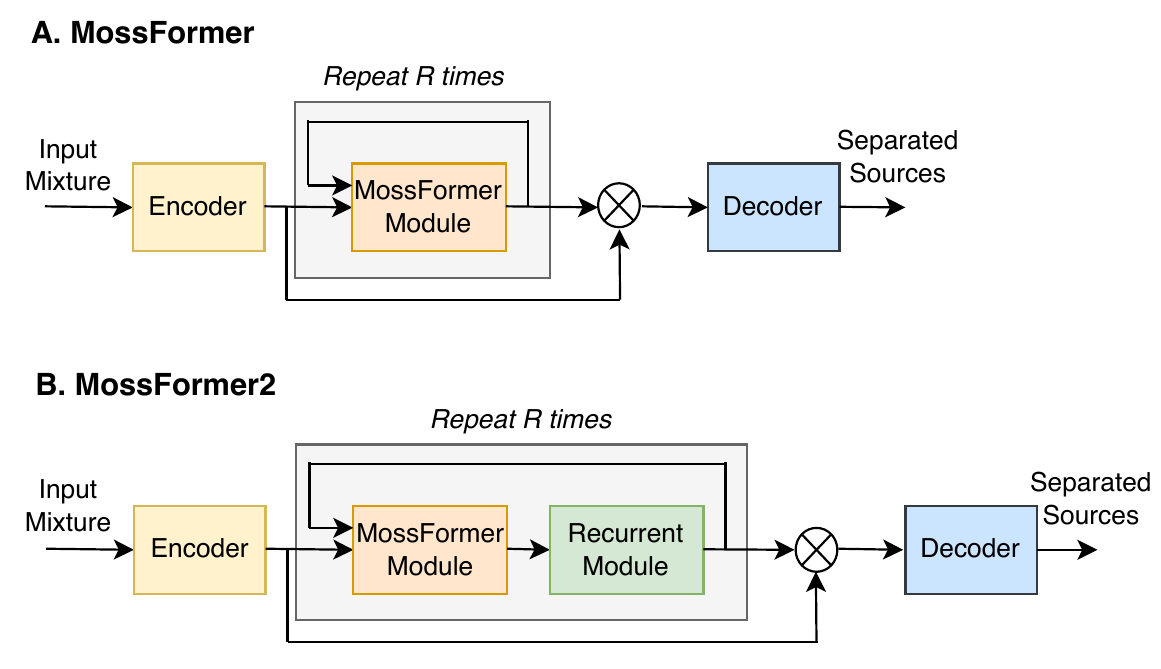 模型
MossFormer2 與 TIGER-speech:語音前端的三種任務分工
語音前端 / 技術比較
閱讀全文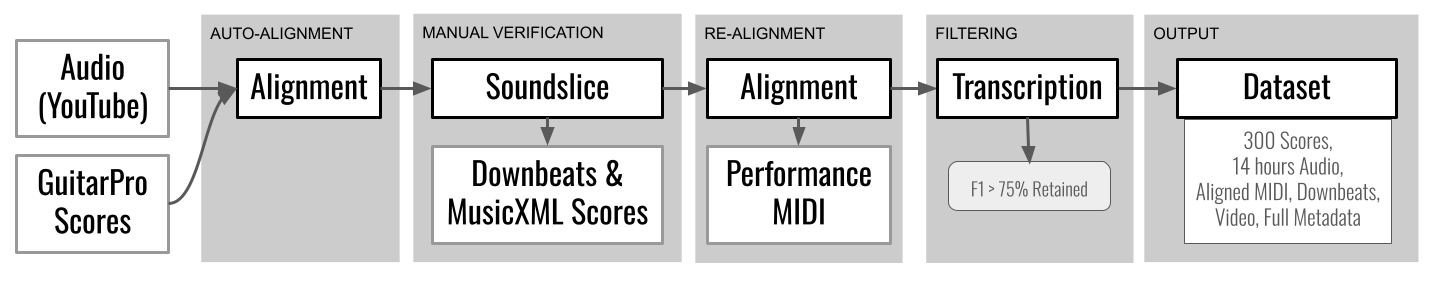 模型
專精音訊轉 MIDI:五個模型,五張不同的 F1 試卷
以下模型均有公開可下載權重,TelkNet 已補齊工具或 profile 接線、明確版本選擇與不可變執行環境定義。公開顯示與任務准入仍以 Admin 狀態為準;啟用前必須具備綁定身分的 E2–E4 證據,預設路由還需要 E5。
閱讀全文 模型
MuScriptor-large:13.66 億參數完整混音轉多軌 MIDI 的實測與邊界
自動音樂轉錄
閱讀全文 模型
Qwen-Image、Z-Image 與 FLUX.2 [klein]:三條開放影像路線的分隔
開放式影像模型 / 技術縱覽
閱讀全文 模型
BiRefNet、Moebius、VOSR 與 DDColor:四個逆問題,四種失敗方式
影像修復 / 專案模型比較
閱讀全文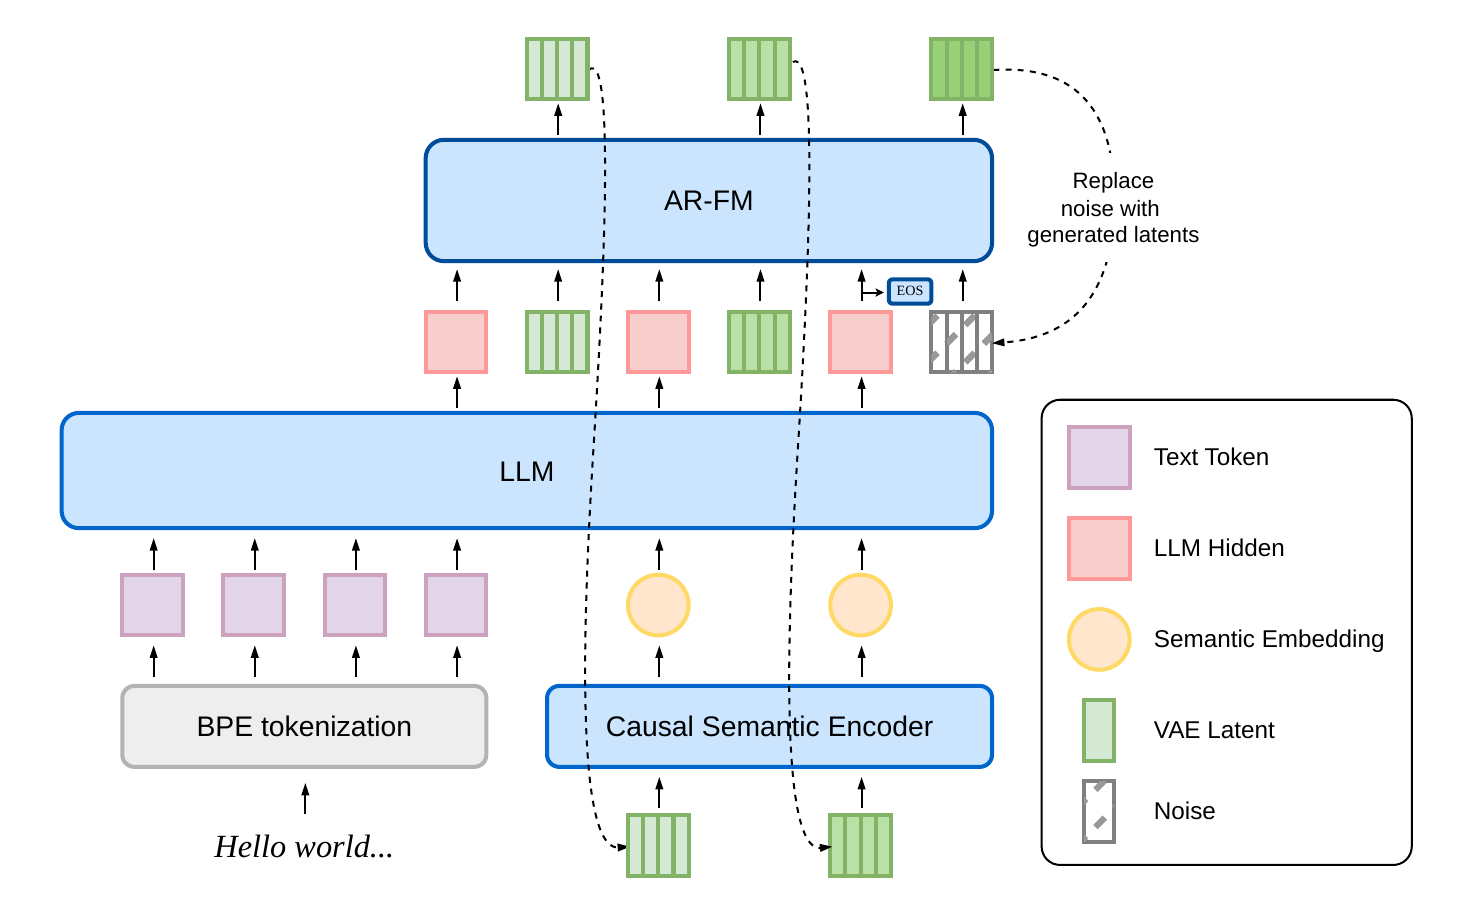 模型
dots.tts:連續聲學潛變量、流匹配和 48 kHz 長程語音
語音合成 / 論文精讀
閱讀全文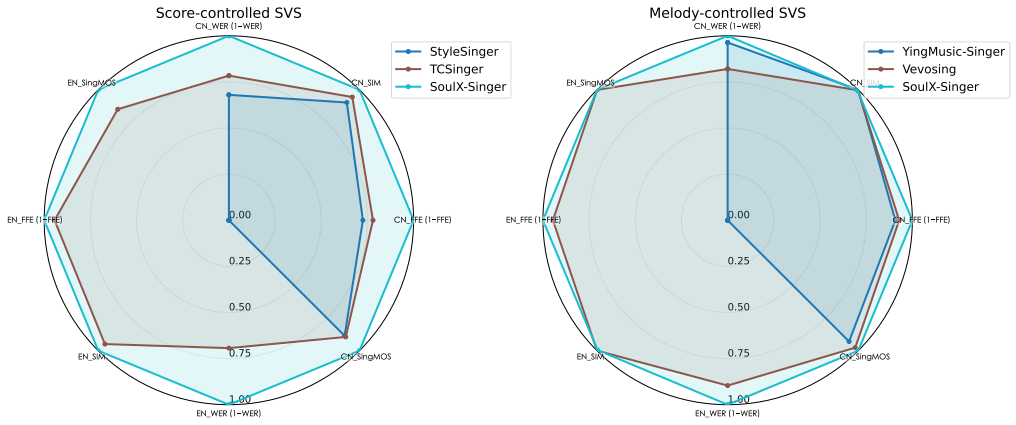 模型
SoulX-Singer 與 YingMusic-Singer-Plus:樂譜驅動與旋律參考,兩首歌聲合成路線
唱出合成 / 路線比較
閱讀全文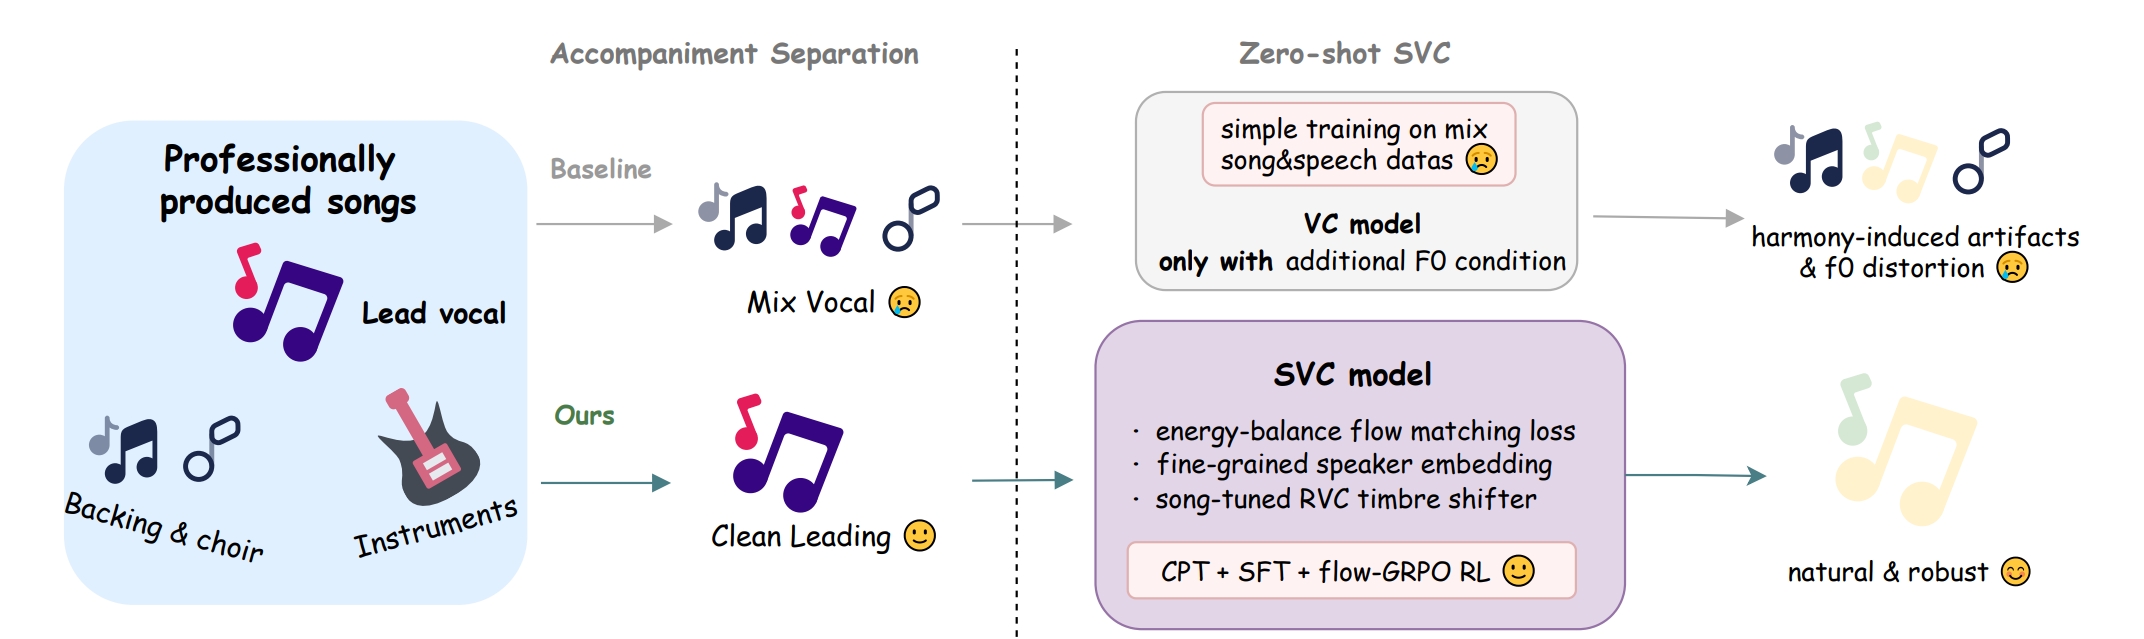 模型
HQ-SVC 與 YingMusic-SVC:拆解歌聲轉換的內容、F0、能量與音色
歌聲轉換 / 技術比較
閱讀全文 模型
Beat This!:不靠 DBN 收尾的節拍跟踪
音樂資訊檢索 / 論文解讀
閱讀全文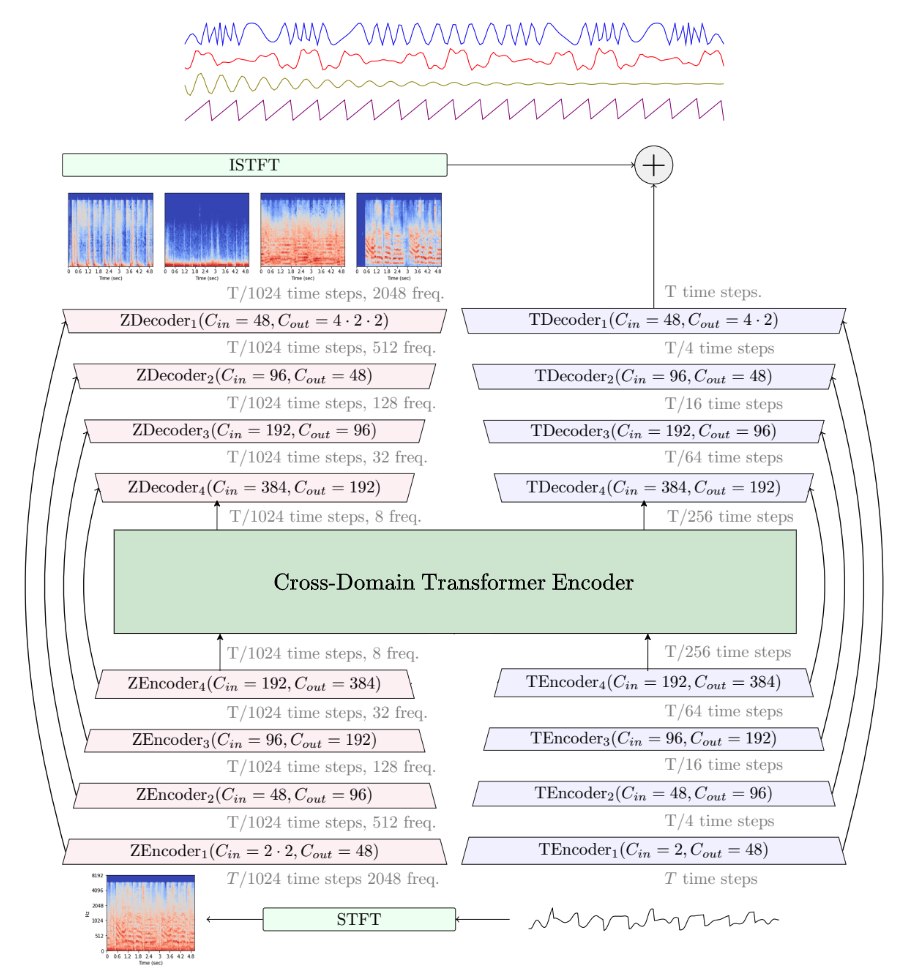 模型
Demucs v3 薩克斯風專模:14.22 dB 與窄域曲庫 A/B
樂器分離 / 技術筆記
閱讀全文 模型
Qwen3-TTS、Fish S2 Pro、MOSS-TTS 與 VoxCPM2:四種語音條件接口
語音合成 / 開放模型比較
閱讀全文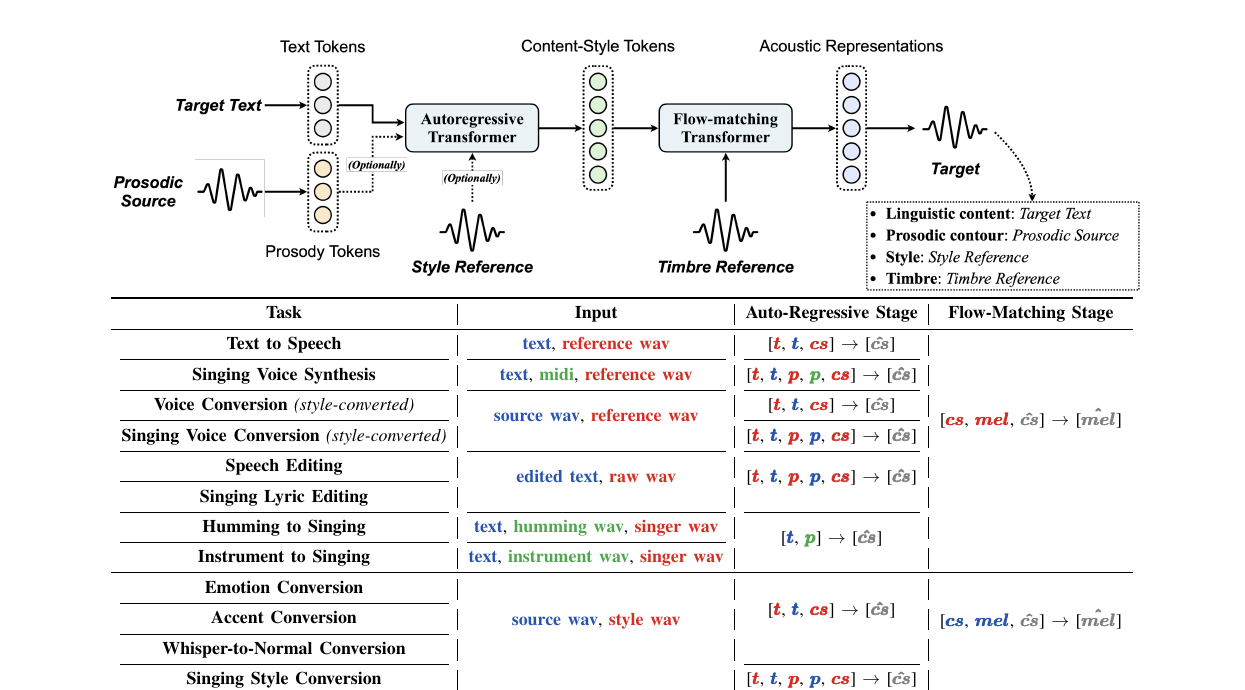 模型
Vevo2:內容、音色、韻律三條件的歌聲重組
演唱合成 / 技術筆記
閱讀全文 模型
四軌音訊分離技術解析:從 MSS 架構演進看 Huge-SCNet 的模型取捨
TelkNet 目前四軌工具使用 Huge-SCNet-4stems V1.2,把完整混音分離為 Vocals、Drums、Bass 和 Other。文章從 MSS 架構演進、Mel-Band RoFormer 的強項與局限、SCNet 的子帶建模和公開四軌分數解釋這次模型取捨。
閱讀全文 模型
Krea 2:Krea AI 公開 Raw 與 Turbo 兩組影像生成權重
Krea AI 公開 Krea 2 Raw 和 Krea 2 Turbo 兩組開放權重。官方技術報告將其描述為從零訓練的 12B 參數文生圖擴散模型,並披露資料過濾、caption 管線、後訓練、強化學習和安全許可邊界。
閱讀全文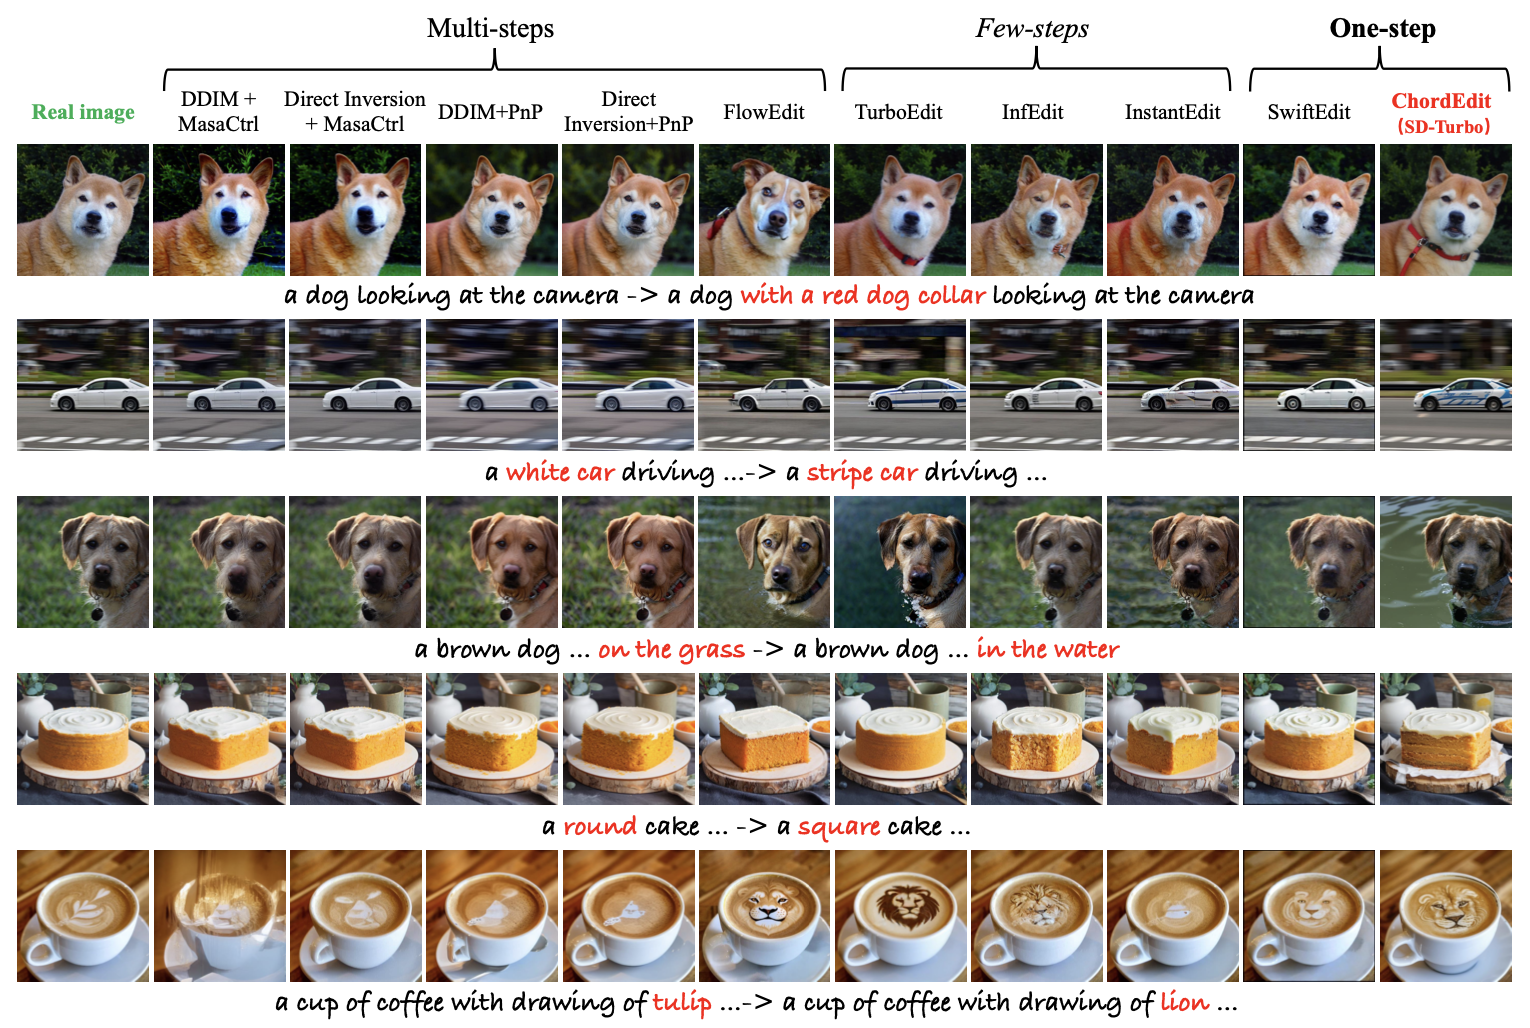 模型
ChordEdit:一步式低能量傳輸,讓文字影像編輯更快落地
ChordEdit 是 CVPR 2026 Oral / Best Student Paper Honorable Mention 論文。它把 one-step 文字引導影像編輯寫成 source prompt 與 target prompt 之間的動態最優傳輸問題,並用 Chord Control Field 降低會扭曲物件、破壞背景的高能量漂移。官方 demo 提供 source_prompt、target_prompt、seed、sample count、time-window 和 step-scale 等參數。
閱讀全文 模型
Zyphra ZONOS2:開源 TTS MoE 將高保真語音克隆帶進站內工具流程
Zyphra 以 Apache-2.0 發布 ZONOS2。它採用 8B 總參數、約 900M 啟用參數的 MoE TTS 架構,訓練資料超過 600 萬小時;TelkNet 已將 ZONOS2 Voice Cloning TTS 接入本站工具體驗。
閱讀全文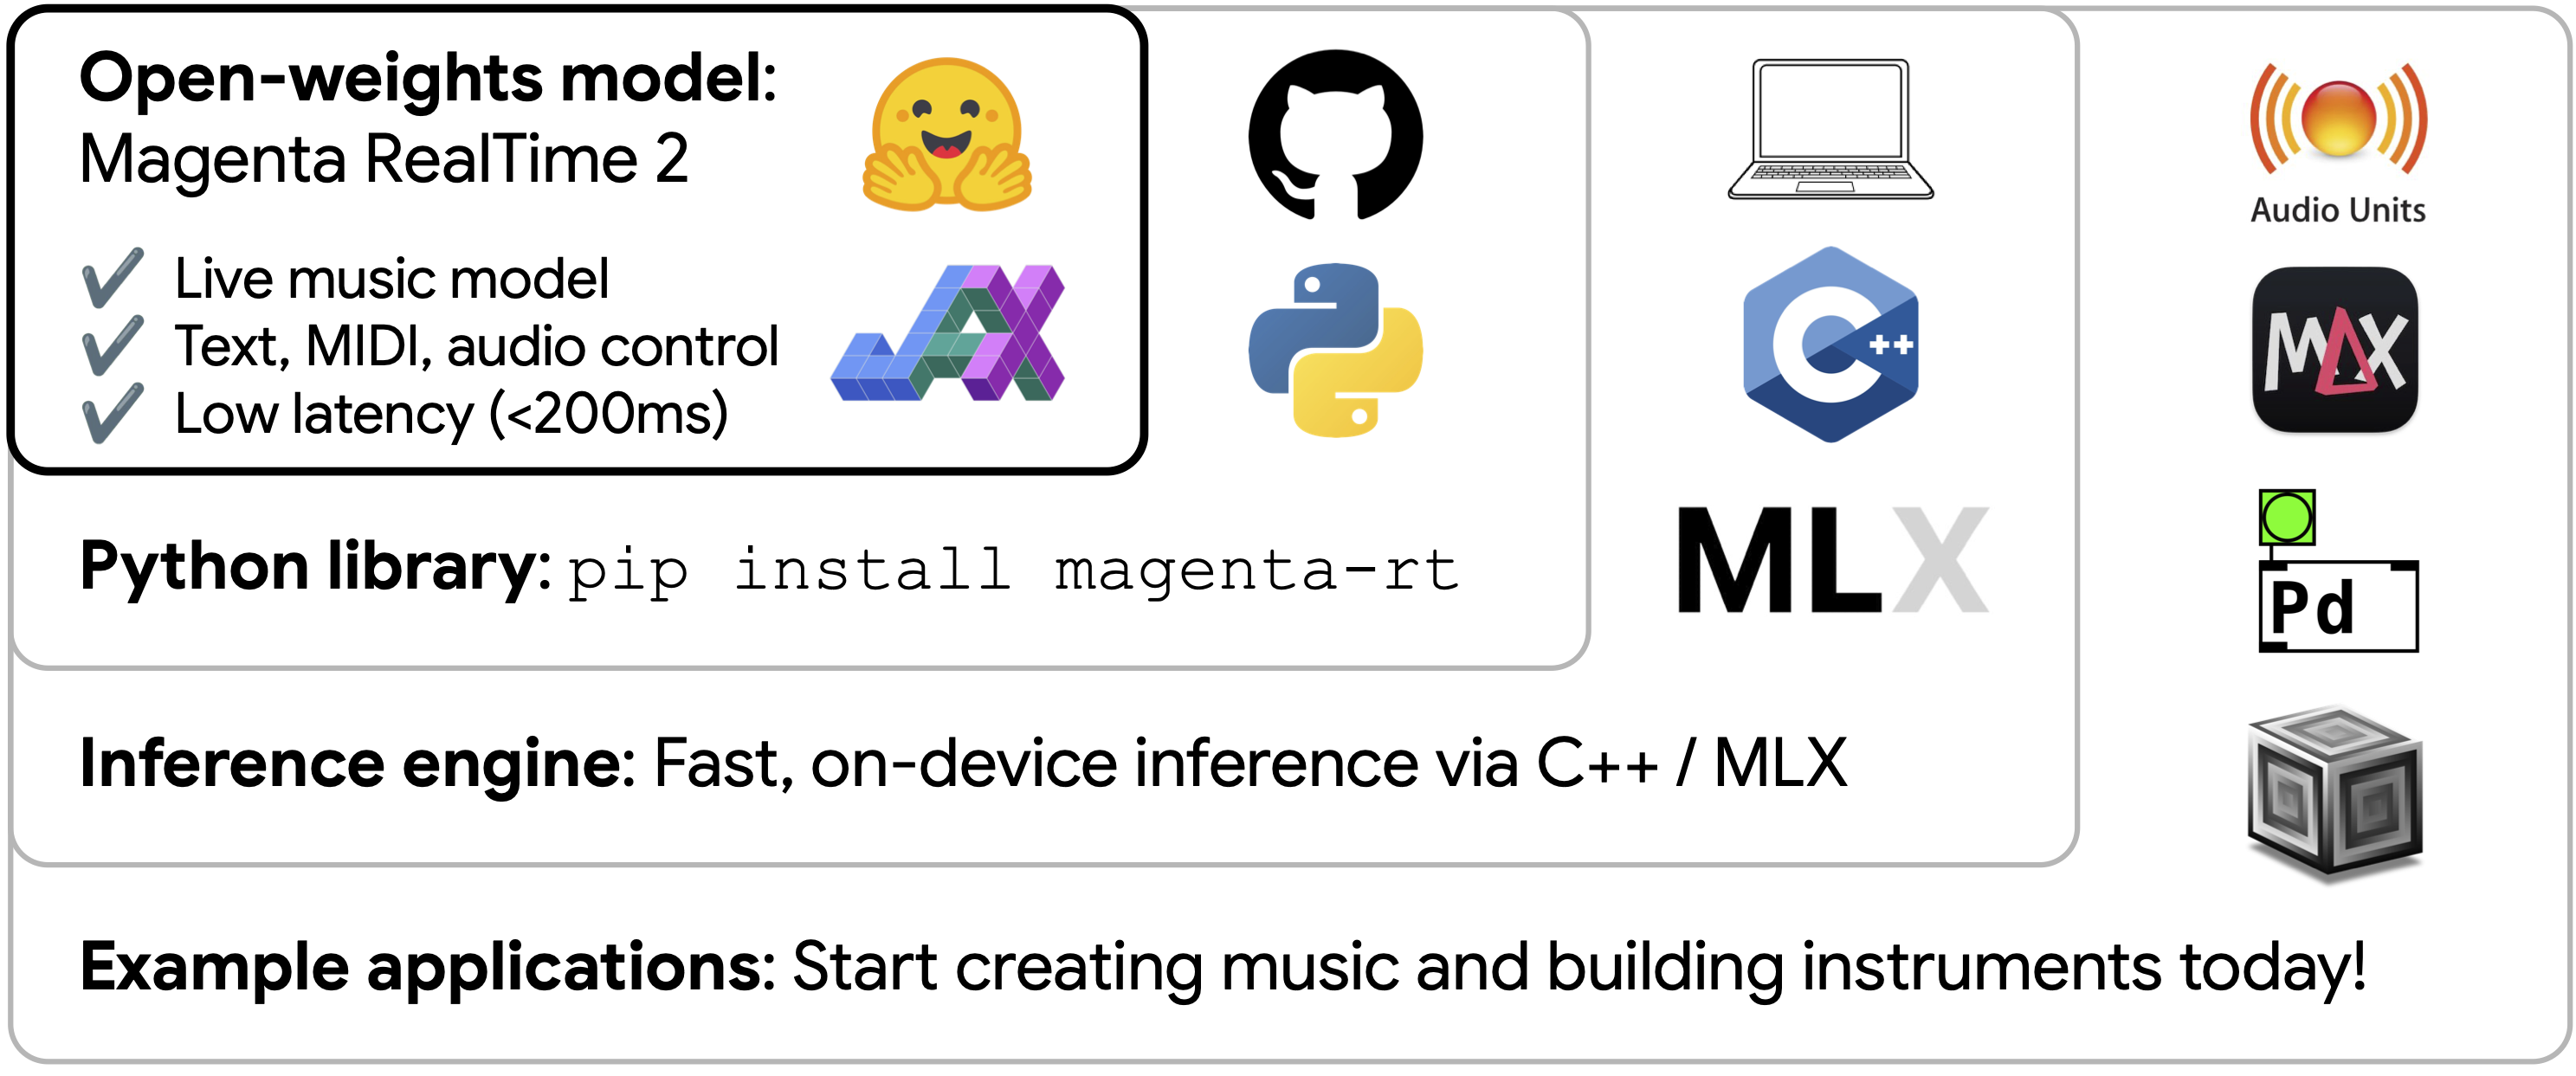 模型
Google Magenta RealTime 2:即時音樂模型從「生成器」走向「可演奏樂器」
以來源可核對的技術解析方式整理 MRT2 的 40ms 幀級自回歸、低延遲 MIDI/文字/音訊控制、2.4B/230M 雙模型結構、SpectroStream codec 路徑、MusicCoCa 風格嵌入與即時演奏邊界。
閱讀全文