Модель
AudioSep-Hive: розділяйте довільні звуки за допомогою текстового запиту
Звукорозділення / технічні примітки
Звукорозділення / технічні примітки
РОЗДІЛЕННЯ ЗВУКУ / ТЕХНІЧНА НОТАТКА
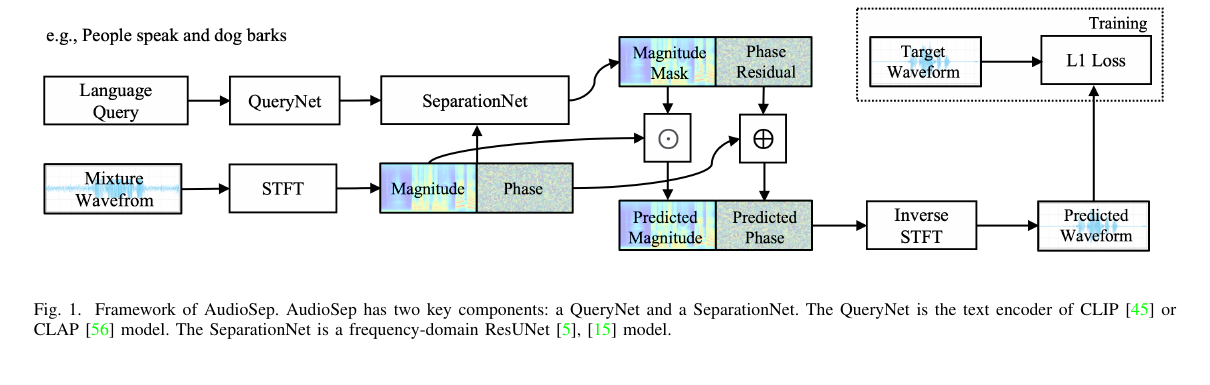
Сепаратор із фіксованими стемами визначає простір відповідей ще до інференсу. AudioSep-Hive спочатку читає опис і лише тоді вирішує, який компонент суміші є ціллю.
Для x(t)=s(t)+n(t) текстовий енкодер видає q=E_text(c). Сепаратор оцінює M=F(X,q) і відновлює Ŝ=M⊙X. Компактний запис цільової функції:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Семантичний доданок змушує споріднені описи займати неперервний простір запитів. Неоднозначність це не знімає: широкі підказки, слабкі цілі та семантично перехресні описи лишаються важкими випадками.
Опублікований шлях інференсу — насамперед моно 32 kHz. Для видобування за мовним запитом і відкритих досліджень цього достатньо, але заміною стемам 44.1 kHz у стерео для продакшну це не є. Зміна опису змінює вектор умови й може зрушити межу цілі.
AudioSep 2023 року представив відкрите розділення за запитами природною мовою. Hive розвиває цю лінію через семантично узгоджену побудову даних та ефективне за даними навчання. Стаття, репозиторій Hive і картка моделі відповідно документують метод, реалізацію набору даних та опубліковані ваги.
Традиційні сепаратори музики визначають вокал, ударні та бас ще до навчання. AudioSep підключив текстово-аудіальні представлення CLAP до сепаратора, відкривши цілі на кшталт сирени, тенор-саксофона чи жіночого мовлення. Hive продовжує цей напрям із ширшим слабко розміченим аудіотекстовим покриттям для відкритих категорій.
Відкритий словник не означає 283 незалежні контрольні точки. Навчальні класи забезпечують акустичне та мовне покриття; під час інференсу змінюється лише текстовий вектор. Перехід від 'dog' до 'small dog barking behind music' зсуває умову, але мова не здатна створити відокремлювану межу джерела, якої немає в суміші.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT сумішіe_qембедінг текстового запитуMθмаска, зумовлена запитомЗапит q вкладається у спільний аудіомовний простір як e_q, який керує оцінювачем маски. 283 мітки описують покриття навчання; це не 283 фіксовані вихідні стеми в одній задачі.
Один звук має багато формулювань, а заперечення чи відношення можуть змінити результат. Зафіксуйте аудіо, перефразуйте запит, потім перевірте утримання цілі, протікання та узгодженість суміші.
Статтю, код і ваги можна простежити через Hive source / AudioSep-Hive weights / AudioSep paper.
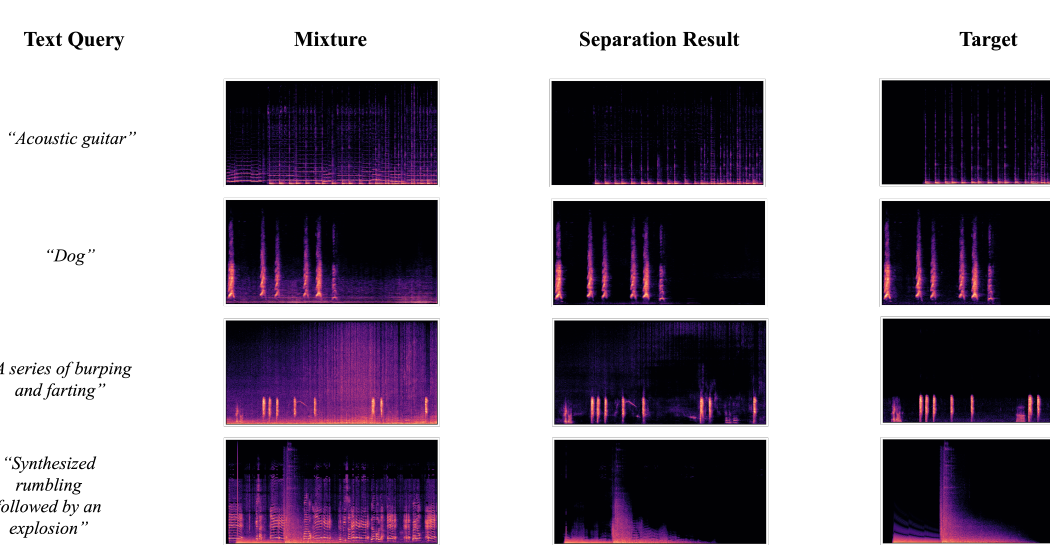
Тут порівнюються вхідні контракти та валідація, а не бали з несумісних задач.
| Підхід | Запит | Головна перевірка прийняття |
|---|---|---|
| AudioSep-Hive | ціль природною мовою | чи відповідає вихід запитаному звуку |
| фіксовані музичні стеми | наперед визначені класи | перехресні протікання та збереження стерео |
| детекція звукових подій | клас плюс часовий проміжок | локалізує події, але не повертає чисту форму хвилі |
Широкий іменник змушує модель йти на компроміс між кандидатами; надто довгий опис може втратити рідкісні уточнення. Починайте зі звучного джерела, потім додавайте розташування, регістр чи дію замість абстрактного наративу сцени.
Відкрита за категоріями гілка — насамперед дослідницький інференс у моно 32 kHz, корисний для пошуку, очищення та виявлення. Фіксовані стерео стеми музики 44.1 kHz лишаються іншою продакшн-задачею.
Сильно корельовані джерела, слабкі цілі та потужна реверберація не мають єдиної маски лише тому, що їхня семантика різна. Сусідній звук сцени може проникнути в результат.
Мовний запит сам є експериментальною змінною. У порівняннях варто тримати суміш і модель незмінними, перевіряючи утримання цілі, протікання нецільових складників та узгодженість суміші після рекомбінації.
Назви моделей, числа та обмеження простежуються до статей, репозиторіїв або карток моделей нижче.