Modèle
AudioSep-Hive : séparez les sons arbitraires avec une requête textuelle
Séparation acoustique / notes techniques
Séparation acoustique / notes techniques
SÉPARATION AUDIO / NOTE TECHNIQUE
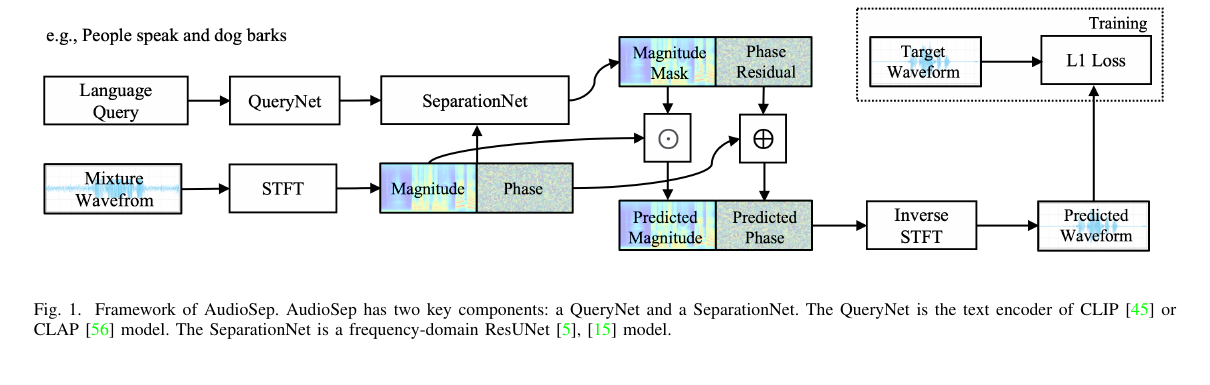
Un séparateur à stems fixes décide de l'espace des réponses avant même l'inférence. AudioSep-Hive commence par lire une description, puis s'en sert pour déterminer quelle composante du mélange constitue la cible.
Pour x(t)=s(t)+n(t), l'encodeur de texte produit q=E_text(c). Le séparateur estime M=F(X,q) et reconstruit Ŝ=M⊙X. L'objectif se résume ainsi :
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Le terme sémantique fait occuper aux descriptions voisines un espace de requêtes continu. Il ne lève pas l'ambiguïté pour autant : requêtes trop larges, cibles faibles et descriptions sémantiquement proches restent des cas difficiles.
Le chemin d'inférence publié fonctionne avant tout en mono 32 kHz. Il sert l'extraction par requête langagière et la recherche en domaine ouvert, mais ne remplace pas des stems de production stéréo à 44.1 kHz. Modifier la description modifie le vecteur de conditionnement et peut déplacer la frontière de la cible.
AudioSep a introduit la séparation en domaine ouvert par requêtes en langage naturel en 2023. Hive prolonge cette voie grâce à une construction de données sémantiquement cohérente et à un entraînement économe en données. L'article, le dépôt Hive et la fiche modèle documentent respectivement la méthode, l'implémentation du jeu de données et les poids publiés.
Les séparateurs de musique traditionnels définissent voix, batterie et basse avant l'entraînement. AudioSep a relié les représentations texte-audio de CLAP à un séparateur, autorisant des cibles comme une sirène, un saxophone ténor ou une voix de femme. Hive poursuit cette voie avec une couverture audio-texte faiblement étiquetée plus large pour les catégories ouvertes.
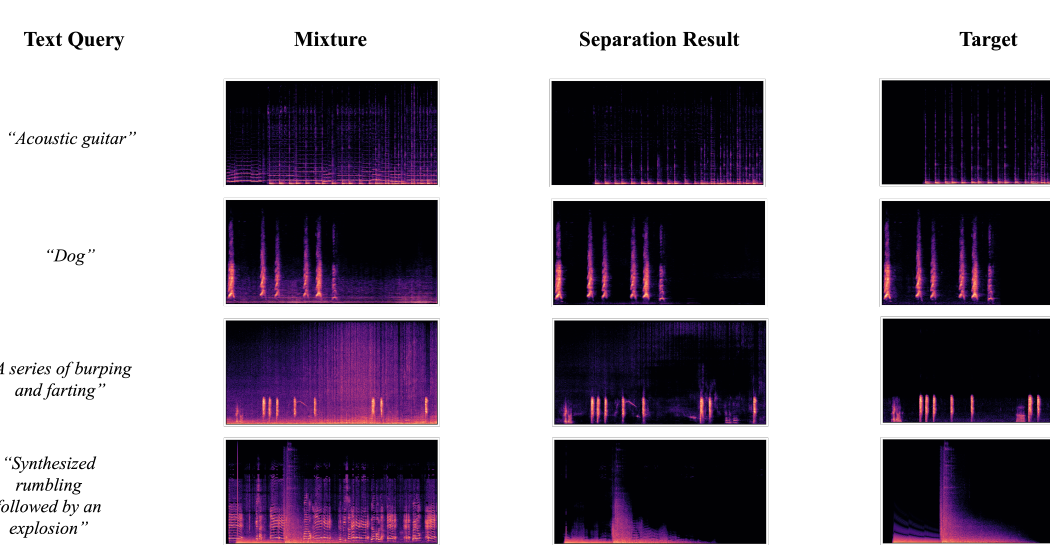
Un vocabulaire ouvert ne signifie pas 283 checkpoints indépendants. Les classes d'entraînement assurent la couverture acoustique et linguistique ; c'est le vecteur de texte qui change à l'inférence. Passer de 'dog' à 'small dog barking behind music' déplace le conditionnement, mais la langue ne peut pas créer une frontière de source séparable absente du mélange.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT du mélangee_qplongement de la requête textuelleMθmasque conditionné par la requêteLa requête q est plongée dans un espace audio-langage partagé sous la forme e_q, qui conditionne un estimateur de masque. Les 283 étiquettes décrivent la couverture d'entraînement ; ce ne sont pas 283 stems de sortie fixes au sein d'une même tâche.
Un même son admet de nombreuses formulations, et la négation ou les relations peuvent changer le résultat. Gardez l'audio fixe, paraphrasez la requête, puis examinez la conservation de la cible, les fuites et la cohérence du mélange.
L'article, le code et les poids se retrouvent via Hive source / AudioSep-Hive weights / AudioSep paper.
La comparaison porte sur les contrats d'entrée et la validation, pas sur des scores issus de tâches incompatibles.
| Voie | Requête | Contrôle d'acceptation principal |
|---|---|---|
| AudioSep-Hive | cible en langage naturel | la sortie correspond-elle au son demandé |
| stems musicaux fixes | classes prédéfinies | diaphonie et préservation de la stéréo |
| détection d'événements sonores | classe plus intervalle temporel | localise les événements sans restituer de forme d'onde propre |
Un nom trop générique oblige le modèle à un compromis entre candidats ; une description très longue peut perdre les modificateurs rares. Commencez par la source audible, puis ajoutez emplacement, registre ou action plutôt qu'un récit de scène abstrait.
La voie en catégories ouvertes relève avant tout d'une inférence de recherche mono 32 kHz, utile pour la recherche documentaire, le nettoyage et la découverte. Les stems musicaux stéréo fixes à 44.1 kHz restent une tâche de production distincte.
Des sources fortement corrélées, des cibles faibles ou une réverbération marquée n'ont pas de masque unique sous prétexte que leurs sémantiques diffèrent. L'audio d'une scène voisine peut fuiter dans le résultat.
La requête langagière est elle-même une variable expérimentale. Toute comparaison doit garder mélange et modèle fixes, tout en auditant la conservation de la cible, les fuites hors cible et la cohérence du mélange après recombinaison.
Les noms de modèles, les chiffres et les limites se rattachent aux articles, dépôts ou fiches modèles ci-dessous.