Modello
AudioSep-Hive: separa i suoni arbitrari con una query di testo
Separazione del suono / note tecniche
Separazione del suono / note tecniche
SEPARAZIONE AUDIO / NOTA TECNICA
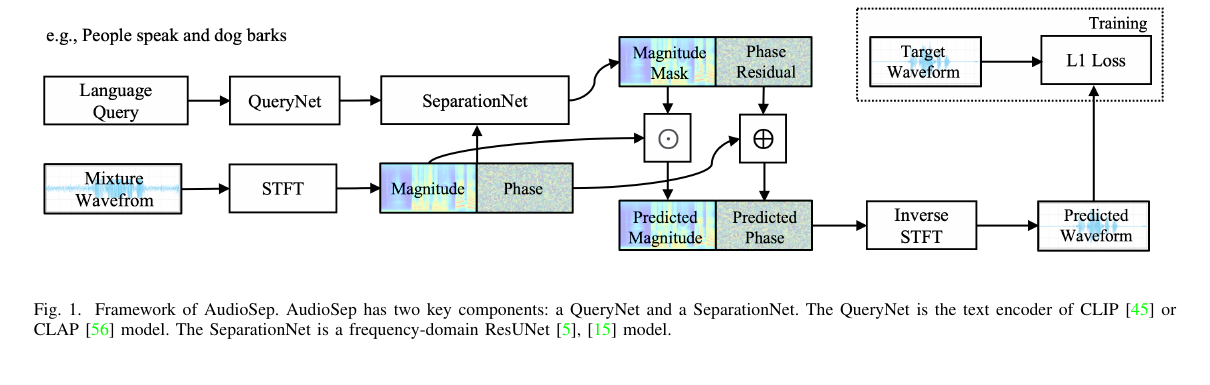
Un separatore a stem fissi decide lo spazio delle risposte prima ancora dell'inferenza. AudioSep-Hive legge prima una descrizione e la usa per decidere quale componente del mix è il bersaglio.
Per x(t)=s(t)+n(t), il text encoder produce q=E_text(c). Il separatore stima M=F(X,q) e ricostruisce Ŝ=M⊙X. Una vista compatta dell'obiettivo è:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Il termine semantico fa sì che descrizioni affini occupino uno spazio di query continuo. Non elimina l'ambiguità: prompt ampi, bersagli deboli e descrizioni semantiche sovrapposte restano casi difficili.
Il percorso di inferenza rilasciato è principalmente mono a 32 kHz. È utile per l'estrazione guidata dal linguaggio e per la ricerca open-domain, ma non sostituisce gli stem di produzione stereo a 44.1 kHz. Cambiare la descrizione modifica il vettore di condizione e può spostare il confine del bersaglio.
AudioSep ha introdotto nel 2023 la separazione open-domain tramite query in linguaggio naturale. Hive prolunga quella linea con una costruzione dei dati semanticamente coerente e un addestramento efficiente nei dati. Il paper, il repository Hive e la model card documentano rispettivamente il metodo, l'implementazione del dataset e i pesi rilasciati.
I separatori musicali tradizionali definiscono voce, batteria e basso prima dell'addestramento. AudioSep ha collegato le rappresentazioni testo-audio di CLAP a un separatore, consentendo bersagli come una sirena, un sax tenore o un parlato femminile. Hive prosegue su quella strada con una copertura audio-testo debolmente etichettata più ampia per le categorie aperte.
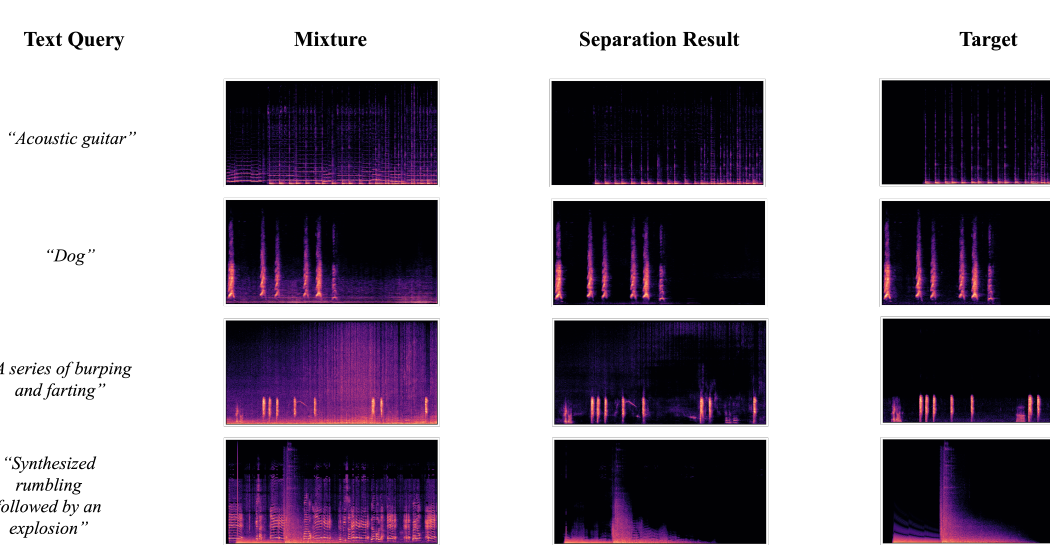
Vocabolario aperto non significa 283 checkpoint indipendenti. Le classi di addestramento forniscono copertura acustica e linguistica; è il vettore di testo a cambiare in inferenza. Passare da 'cane' a 'cagnolino che abbaia dietro la musica' sposta la condizione, ma il linguaggio non può creare un confine di sorgente separabile che il mix non contiene.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT del mixe_qembedding della query testualeMθmaschera condizionata dalla queryLa query q è proiettata come e_q in uno spazio audio-linguistico condiviso, che condiziona uno stimatore di maschera. Le 283 etichette descrivono la copertura dell'addestramento; non sono 283 stem di output fissi in un unico task.
Uno stesso suono ammette molte formulazioni, e negazioni o relazioni possono cambiare il risultato. Tieni fisso l'audio, riformula la query, poi verifica ritenzione del bersaglio, leakage e coerenza del mix.
Paper, codice e pesi si possono seguire tramite Hive source / AudioSep-Hive weights / AudioSep paper.
Qui si confrontano contratti di input e validazione, non punteggi di task incompatibili.
| Percorso | Query | Verifica di accettazione primaria |
|---|---|---|
| AudioSep-Hive | bersaglio in linguaggio naturale | l'output corrisponde al suono richiesto |
| stem musicali fissi | classi predefinite | cross-bleed e preservazione dello stereo |
| rilevamento di eventi sonori | classe più intervallo temporale | localizza gli eventi ma non restituisce una forma d'onda pulita |
Un sostantivo generico costringe il modello a un compromesso tra i candidati; una descrizione troppo lunga può perdere i modificatori rari. Parti dalla sorgente udibile, poi aggiungi posizione, registro o azione invece di una narrazione astratta della scena.
Il percorso a categorie aperte è principalmente inferenza di ricerca mono a 32 kHz, utile per retrieval, pulizia e scoperta. Gli stem musicali stereo fissi a 44.1 kHz restano un task di produzione diverso.
Sorgenti fortemente correlate, bersagli deboli e riverbero intenso non hanno un'unica maschera solo perché la loro semantica differisce. L'audio di una scena vicina può infiltrarsi nel risultato.
La query linguistica è essa stessa una variabile sperimentale. I confronti dovrebbero tenere fissi mix e modello, verificando ritenzione del bersaglio, leakage fuori bersaglio e coerenza del mix dopo la ricombinazione.
Nomi dei modelli, numeri e limiti sono riconducibili ai paper, ai repository o alle model card elencati qui sotto.