โมเดล
AudioSep-Hive: แยกเสียงที่กำหนดเองด้วยข้อความค้นหา
การแยกเสียง / หมายเหตุทางเทคนิค
การแยกเสียง / หมายเหตุทางเทคนิค
© 2026 TelkNet สงวนลิขสิทธิ์.
การแยกเสียง / บันทึกทางเทคนิค
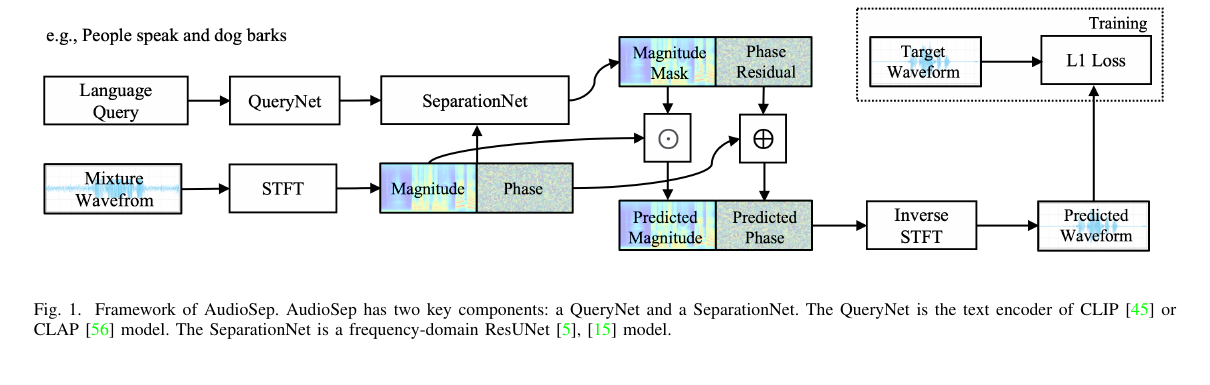
ตัวแยกแบบ stem ตายตัวกำหนดขอบเขตของคำตอบไว้ก่อนการอินเฟอเรนซ์เสียอีก แต่ AudioSep-Hive อ่านคำอธิบายก่อน แล้วใช้คำอธิบายนั้นตัดสินว่าองค์ประกอบใดของเสียงผสมคือเป้าหมาย
สำหรับ x(t)=s(t)+n(t) ตัวเข้ารหัสข้อความจะให้ q=E_text(c) ตัวแยกประมาณ M=F(X,q) แล้วสร้าง Ŝ=M⊙X ขึ้นมาใหม่ มุมมองแบบย่อของฟังก์ชันเป้าหมายคือ
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
พจน์เชิงความหมายทำให้คำอธิบายที่ใกล้เคียงกันอยู่ในพื้นที่คำค้นต่อเนื่องเดียวกัน แต่มันไม่ได้ขจัดความกำกวมออกไป: พรอมป์ที่กว้าง เป้าหมายที่เบา และคำอธิบายเชิงความหมายที่ซ้อนทับกันยังคงเป็นกรณีที่ยากอยู่
เส้นทางอินเฟอเรนซ์ที่เผยแพร่ออกมาเป็นแบบโมโน 32 kHz เป็นหลัก เหมาะสำหรับการสกัดด้วยคำค้นเชิงภาษาและงานวิจัยโดเมนเปิด แต่ไม่ใช่ตัวทดแทน stem สเตอริโอ 44.1 kHz สำหรับงานผลิต การเปลี่ยนคำอธิบายคือการเปลี่ยนเวกเตอร์เงื่อนไข และอาจเลื่อนขอบเขตของเป้าหมายไปด้วย
AudioSep เปิดทางการแยกเสียงโดเมนเปิดด้วยคำค้นภาษาธรรมชาติตั้งแต่ปี 2023 Hive ต่อยอดแนวทางนั้นด้วยการสร้างข้อมูลที่สอดคล้องกันเชิงความหมายและการฝึกที่ใช้ข้อมูลอย่างคุ้มค่า บทความวิชาการ รีโพ Hive และการ์ดโมเดลบันทึกวิธีการ การนำชุดข้อมูลไปใช้งาน และน้ำหนักที่เผยแพร่ไว้ตามลำดับ
ตัวแยกดนตรีแบบดั้งเดิมนิยามเสียงร้อง กลอง และเบสไว้ก่อนการฝึก AudioSep เชื่อมการแทนความหมายข้อความ-เสียงของ CLAP เข้ากับตัวแยก ทำให้เลือกเป้าหมายอย่างเสียงไซเรน แซ็กโซโฟนเทเนอร์ หรือเสียงพูดผู้หญิงได้ Hive เดินหน้าแนวทางนั้นด้วยข้อมูลเสียง-ข้อความแบบกำกับหละหลวมที่ครอบคลุมกว้างขึ้นสำหรับหมวดหมู่แบบเปิด
คำศัพท์แบบเปิดไม่ได้หมายถึงเช็กพอยต์อิสระ 283 ตัว คลาสที่ใช้ฝึกให้การครอบคลุมด้านอะคูสติกและภาษา ส่วนสิ่งที่เปลี่ยนตอนอินเฟอเรนซ์คือเวกเตอร์ข้อความ การเปลี่ยนจาก 'หมา' เป็น 'หมาตัวเล็กเห่าอยู่หลังเสียงดนตรี' เป็นการเลื่อนเงื่อนไข แต่ภาษาสร้างขอบเขตของแหล่งเสียงที่แยกออกจากกันได้ขึ้นมาไม่ได้ หากขอบเขตนั้นไม่มีอยู่ในเสียงผสมตั้งแต่แรก
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT ของเสียงผสมe_qการฝังคำค้นข้อความMθมาสก์ที่ถูกกำหนดเงื่อนไขด้วยคำค้นคำค้น q ถูกฝังลงในพื้นที่เสียง-ภาษาร่วมกันเป็น e_q ซึ่งไปกำหนดเงื่อนไขให้ตัวประมาณมาสก์ ป้ายกำกับ 283 รายการอธิบายขอบเขตของการฝึก ไม่ใช่ stem ผลลัพธ์ตายตัว 283 อันในงานเดียว
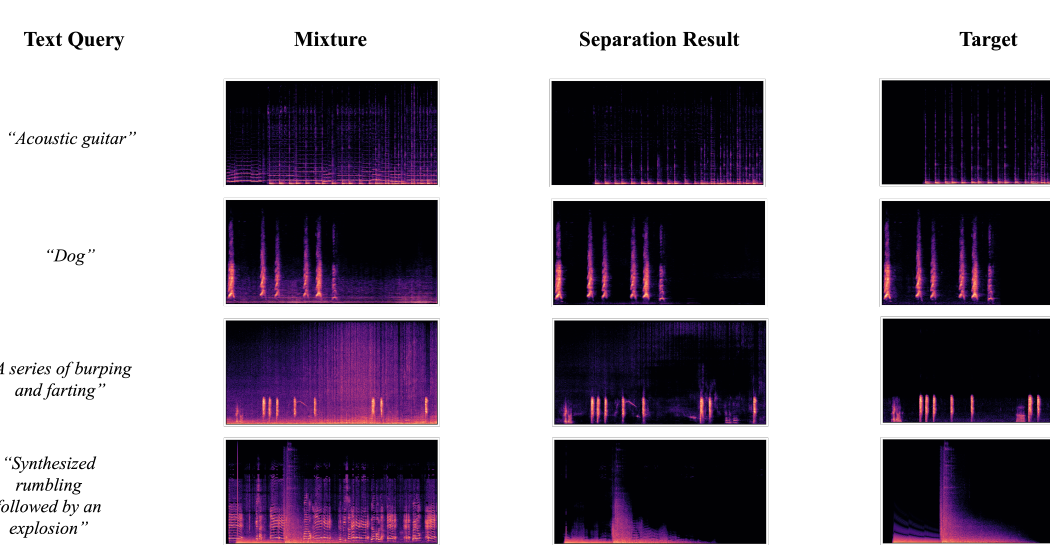
เสียงหนึ่งเสียงเขียนเป็นวลีได้หลายแบบ และการปฏิเสธหรือความสัมพันธ์อาจเปลี่ยนผลลัพธ์ คงเสียงต้นทางไว้ เปลี่ยนวิธีเขียนคำค้น แล้วตรวจการรักษาเป้าหมาย การรั่วไหล และความสอดคล้องของเสียงผสม
ติดตามบทความ โค้ด และน้ำหนักได้ผ่านซอร์ส Hive / น้ำหนัก AudioSep-Hive / บทความ AudioSep
การเปรียบเทียบนี้มองที่สัญญาของอินพุตและวิธีตรวจรับ ไม่ใช่คะแนนจากงานที่เทียบกันไม่ได้
| แนวทาง | คำค้น | การตรวจรับหลัก |
|---|---|---|
| AudioSep-Hive | เป้าหมายที่ระบุด้วยภาษาธรรมชาติ | ผลลัพธ์ตรงกับเสียงที่ร้องขอหรือไม่ |
| stem ดนตรีแบบตายตัว | คลาสที่กำหนดไว้ล่วงหน้า | เสียงเลอะข้ามแทร็กและการรักษาสเตอริโอ |
| การตรวจจับเหตุการณ์เสียง | คลาสบวกช่วงเวลา | ระบุตำแหน่งเหตุการณ์ได้แต่ไม่คืนคลื่นเสียงที่สะอาด |
คำนามที่กว้างเกินไปทำให้โมเดลต้องประนีประนอมระหว่างตัวเลือกหลายตัว ส่วนคำอธิบายที่ยาวมากอาจทำให้คำขยายที่พบน้อยหลุดหายไป เริ่มจากแหล่งเสียงที่ได้ยินจริง แล้วค่อยเติมตำแหน่ง ระดับเสียง หรือการกระทำ แทนที่จะเล่าฉากแบบนามธรรม
เส้นทางหมวดหมู่เปิดเป็นอินเฟอเรนซ์เชิงวิจัยแบบโมโน 32 kHz เป็นหลัก มีประโยชน์สำหรับการค้นคืน การทำความสะอาด และการสำรวจค้นพบ ส่วน stem ดนตรีสเตอริโอ 44.1 kHz แบบตายตัวยังเป็นงานผลิตอีกประเภทหนึ่ง
แหล่งเสียงที่สหสัมพันธ์กันสูง เป้าหมายที่เบา และเสียงก้องที่แรง ไม่ได้มีมาสก์เฉพาะตัวเพียงเพราะความหมายต่างกัน เสียงจากฉากใกล้เคียงอาจรั่วเข้ามาในผลลัพธ์
คำค้นเชิงภาษาเองก็เป็นตัวแปรทดลองตัวหนึ่ง การเปรียบเทียบควรคงเสียงผสมและโมเดลไว้ แล้วตรวจการรักษาเป้าหมาย การรั่วไหลของสิ่งที่ไม่ใช่เป้าหมาย และความสอดคล้องของเสียงผสมหลังรวมกลับ
ชื่อโมเดล ตัวเลข และข้อจำกัดทั้งหมดย้อนไปถึงบทความ รีโพ หรือการ์ดโมเดลด้านล่างนี้