Model
AudioSep-Hive: Oddziel dowolne dźwięki za pomocą zapytania tekstowego
Separacja dźwięku / uwagi techniczne
Separacja dźwięku / uwagi techniczne
SEPARACJA DŹWIĘKU / NOTA TECHNICZNA
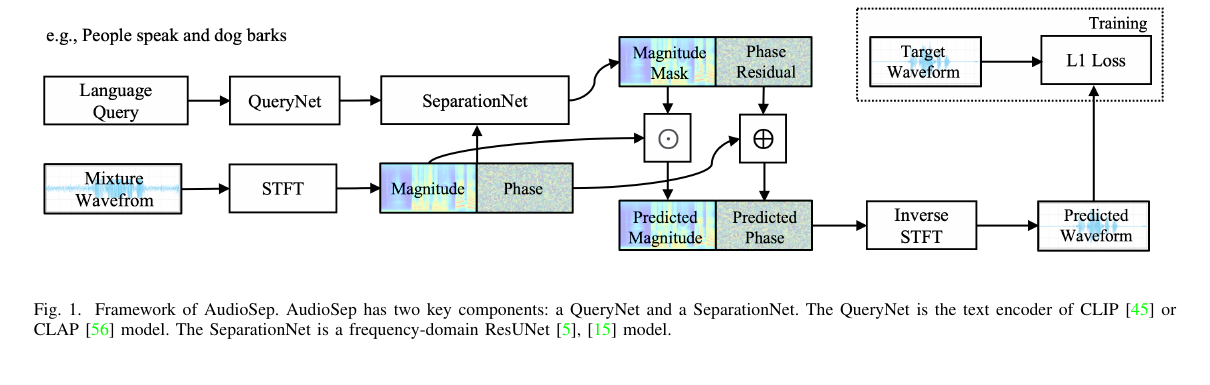
Separator o stałych ścieżkach wyznacza przestrzeń odpowiedzi jeszcze przed wnioskowaniem. AudioSep-Hive najpierw czyta opis i na jego podstawie decyduje, który składnik miksu jest celem.
Dla x(t)=s(t)+n(t) enkoder tekstu daje q=E_text(c). Separator estymuje M=F(X,q) i rekonstruuje Ŝ=M⊙X. Zwarty zapis celu wygląda tak:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Składnik semantyczny sprawia, że pokrewne opisy zajmują ciągłą przestrzeń zapytań. Nie usuwa to niejednoznaczności: szerokie prompty, słabe cele i nakładające się opisy semantyczne pozostają trudnymi przypadkami.
Opublikowana ścieżka wnioskowania to przede wszystkim 32 kHz mono. Sprawdza się w ekstrakcji sterowanej językiem i badaniach otwartej domeny, ale nie zastępuje produkcyjnych ścieżek stereo 44.1 kHz. Zmiana opisu zmienia wektor warunku i może przesunąć granicę celu.
AudioSep wprowadził w 2023 roku separację otwartej domeny sterowaną zapytaniami w języku naturalnym. Hive rozwija tę linię przez semantycznie spójną konstrukcję danych i trening oszczędny danymi. Metodę, implementację zbioru danych i opublikowane wagi dokumentują odpowiednio artykuł, repozytorium Hive i karta modelu.
Tradycyjne separatory muzyczne definiują wokal, perkusję i bas jeszcze przed treningiem. AudioSep połączył reprezentacje tekstowo-dźwiękowe CLAP z separatorem, dopuszczając cele takie jak syrena, saksofon tenorowy czy kobieca mowa. Hive kontynuuje ten kierunek z szerszym, słabo oznaczonym pokryciem par audio-tekst dla kategorii otwartych.
Otwarty słownik nie oznacza 283 niezależnych punktów kontrolnych. Klasy treningowe zapewniają pokrycie akustyczne i językowe; to wektor tekstowy zmienia się podczas wnioskowania. Przejście od 'pies' do 'mały pies szczekający za muzyką' przesuwa warunek, ale język nie stworzy granicy separowalnego źródła, której nie ma w miksie.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT miksue_qosadzenie zapytania tekstowegoMθmaska warunkowana zapytaniemZapytanie q jest osadzane we wspólnej przestrzeni audio-język jako e_q, która warunkuje estymator maski. 283 etykiety opisują pokrycie treningowe; nie są 283 stałymi ścieżkami wyjściowymi w jednym zadaniu.
Jeden dźwięk ma wiele sformułowań, a negacja lub relacje potrafią zmienić wynik. Przy niezmienionym audio parafrazuj zapytanie, a potem sprawdzaj zatrzymanie celu, przecieki i spójność miksu.
Artykuł, kod i wagi można prześledzić przez Hive source / AudioSep-Hive weights / AudioSep paper.
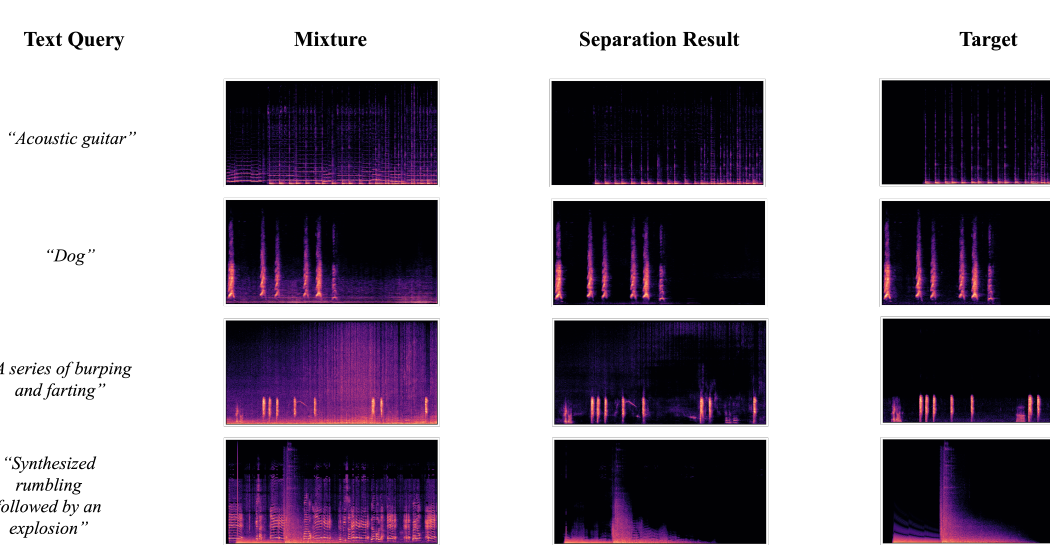
Porównanie dotyczy kontraktów wejściowych i walidacji, a nie wyników z niekompatybilnych zadań.
| Ścieżka | Zapytanie | Główna kontrola akceptacyjna |
|---|---|---|
| AudioSep-Hive | cel w języku naturalnym | czy wynik odpowiada żądanemu dźwiękowi |
| stałe ścieżki muzyczne | predefiniowane klasy | przesłuchy i zachowanie stereo |
| detekcja zdarzeń dźwiękowych | klasa plus przedział czasu | lokalizuje zdarzenia, ale nie zwraca czystej fali |
Szeroki rzeczownik zmusza model do kompromisu między kandydatami; bardzo długi opis może zgubić rzadkie przydawki. Zacznij od słyszalnego źródła, potem dodaj lokalizację, rejestr lub działanie zamiast abstrakcyjnej narracji sceny.
Ścieżka otwartych kategorii to głównie badawcze wnioskowanie mono 32 kHz, przydatne w wyszukiwaniu, czyszczeniu i eksploracji. Stałe ścieżki muzyczne stereo 44.1 kHz pozostają odrębnym zadaniem produkcyjnym.
Silnie skorelowane źródła, słabe cele i mocny pogłos nie mają jednoznacznej maski tylko dlatego, że różnią się semantycznie. Sąsiedni dźwięk sceny może przeciekać do wyniku.
Zapytanie językowe samo jest zmienną eksperymentalną. Porównania powinny utrzymywać miks i model niezmienione, kontrolując zatrzymanie celu, przecieki spoza celu i spójność miksu po rekombinacji.
Nazwy modeli, liczby i ograniczenia prowadzą do artykułów, repozytoriów lub kart modeli poniżej.