Modell
AudioSep-Hive: Trennen Sie beliebige Sounds mit einer Textabfrage
Tontrennung / technische Hinweise
Tontrennung / technische Hinweise
QUELLENTRENNUNG / TECHNISCHE NOTIZ
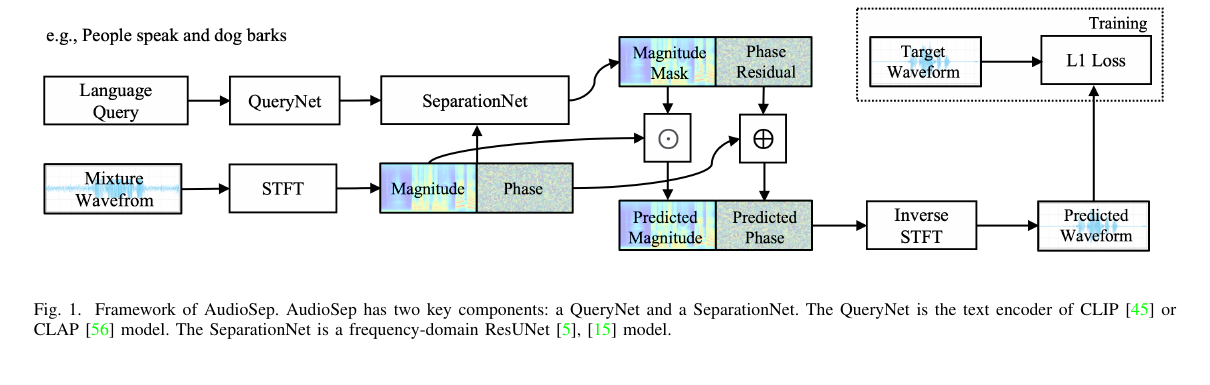
Ein Separator mit festen Stems legt den Antwortraum schon vor der Inferenz fest. AudioSep-Hive liest zuerst eine Beschreibung und bestimmt daraus, welche Komponente der Mischung das Ziel ist.
Für x(t)=s(t)+n(t) liefert der Textencoder q=E_text(c). Der Separator schätzt M=F(X,q) und rekonstruiert Ŝ=M⊙X. Kompakt lautet die Zielfunktion:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Der semantische Term sorgt dafür, dass verwandte Beschreibungen einen kontinuierlichen Abfrageraum einnehmen. Mehrdeutigkeit beseitigt er nicht: Breite Prompts, schwache Ziele und semantisch überlappende Beschreibungen bleiben schwierige Fälle.
Der veröffentlichte Inferenzpfad arbeitet vorrangig mit 32 kHz in Mono. Er eignet sich für sprachgesteuerte Extraktion und Open-Domain-Forschung, ersetzt aber keine 44.1-kHz-Stereo-Stems für die Produktion. Wer die Beschreibung ändert, ändert den Konditionsvektor und kann damit die Zielgrenze verschieben.
AudioSep führte 2023 die Open-Domain-Separation über natürlichsprachliche Abfragen ein. Hive setzt diese Linie mit semantisch konsistenter Datenkonstruktion und dateneffizientem Training fort. Paper, Hive-Repository und Modellkarte dokumentieren jeweils die Methode, die Datensatzimplementierung und die veröffentlichten Gewichte.
Klassische Musikseparatoren definieren Gesang, Schlagzeug und Bass bereits vor dem Training. AudioSep verband CLAP-Text-Audio-Repräsentationen mit einem Separator und machte Ziele wie eine Sirene, ein Tenorsaxophon oder weibliche Sprache adressierbar. Hive führt diese Linie mit einer größeren schwach gelabelten Audio-Text-Abdeckung für offene Kategorien fort.
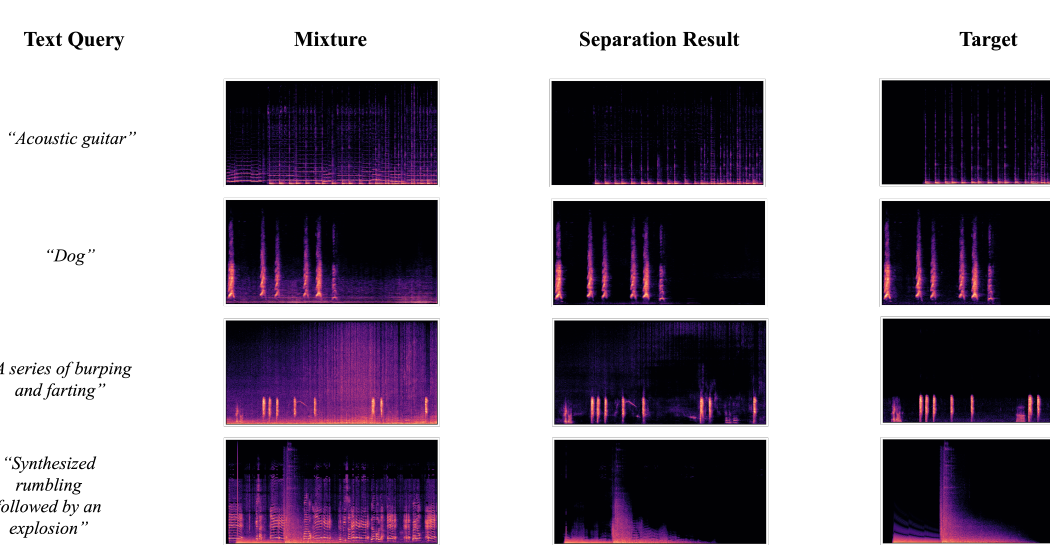
Ein offenes Vokabular bedeutet nicht 283 unabhängige Checkpoints. Die Trainingsklassen liefern akustische und sprachliche Abdeckung; was sich bei der Inferenz ändert, ist der Textvektor. Der Wechsel von 'dog' zu 'small dog barking behind music' verschiebt die Kondition, doch Sprache kann keine trennbare Quellengrenze erzeugen, die in der Mischung nicht vorhanden ist.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT der Mischunge_qEmbedding der TextabfrageMθabfragekonditionierte MaskeDie Abfrage q wird als e_q in einen gemeinsamen Audio-Sprach-Raum eingebettet und konditioniert so einen Maskenschätzer. Die 283 Labels beschreiben die Trainingsabdeckung; es sind nicht 283 feste Ausgabe-Stems in einer einzigen Aufgabe.
Ein Klang hat viele Formulierungen, und Negation oder Relationen können das Ergebnis verändern. Audio konstant halten, die Abfrage umformulieren und dann Zieltreue, Übersprechen und Mischungskonsistenz prüfen.
Paper, Code und Gewichte lassen sich über Hive-Quellcode / AudioSep-Hive-Gewichte / AudioSep-Paper nachvollziehen.
Verglichen werden Eingabeverträge und Validierung, nicht Scores aus nicht vergleichbaren Aufgaben.
| Ansatz | Abfrage | Zentrale Abnahmeprüfung |
|---|---|---|
| AudioSep-Hive | natürlichsprachliches Ziel | trifft die Ausgabe den angefragten Klang |
| feste Musik-Stems | vordefinierte Klassen | Übersprechen und Stereo-Erhalt |
| Erkennung von Klangereignissen | Klasse plus Zeitfenster | lokalisiert Ereignisse, liefert aber keine saubere Wellenform |
Ein breites Substantiv zwingt das Modell zu einem Kompromiss zwischen Kandidaten; eine sehr lange Beschreibung kann seltene Modifikatoren verlieren. Man beginnt am besten mit der hörbaren Quelle und ergänzt dann Ort, Register oder Aktion, statt eine abstrakte Szenenerzählung zu formulieren.
Der Open-Kategorie-Pfad ist vorrangig Mono-Forschungsinferenz mit 32 kHz und eignet sich für Retrieval, Bereinigung und Exploration. Feste 44.1-kHz-Stereo-Musik-Stems bleiben eine andere Produktionsaufgabe.
Stark korrelierte Quellen, schwache Ziele und kräftiger Hall haben keine eindeutige Maske, nur weil sich ihre Semantik unterscheidet. Benachbartes Szenen-Audio kann in das Ergebnis übergreifen.
Die Sprachabfrage ist selbst eine experimentelle Variable. Vergleiche sollten Mischung und Modell konstant halten und dabei Zieltreue, Nicht-Ziel-Übersprechen und Mischungskonsistenz nach der Rekombination prüfen.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die unten genannten Paper, Repositories oder Modellkarten zurückführen.