AudioSep-Hive:用一句文字查詢分離任意聲音
聲音分離 / 技術筆記
聲音分離 / 技術筆記
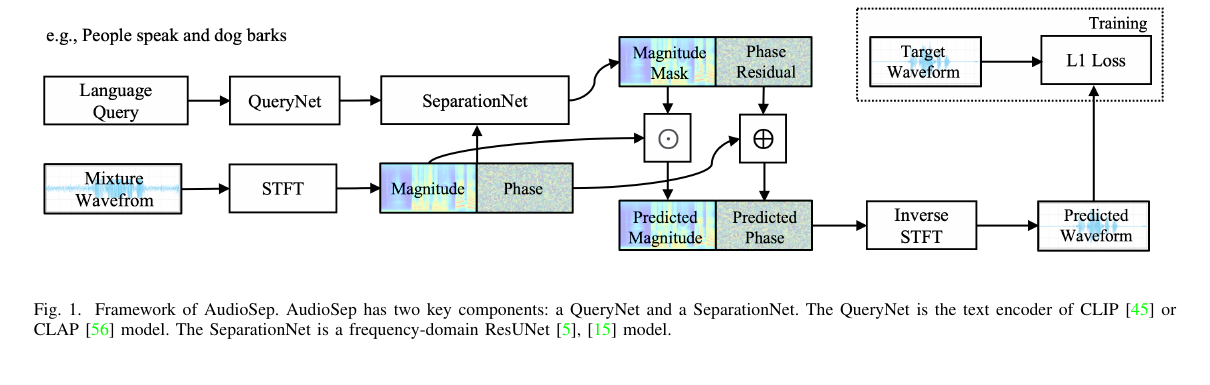
固定 stem 的分離器在推論之前就先決定了答案空間。AudioSep-Hive 先讀一段描述,再依此判斷混音中哪個成分才是目標。
以查詢為條件的目標函數
對 x(t)=s(t)+n(t) 而言,文字編碼器產生 q=E_text(c)。分離器估計 M=F(X,q),再重建 Ŝ=M⊙X。目標函數可簡潔表示為:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
語意項讓相關描述佔據連續的查詢空間。它並未消除歧義:寬泛的提示、微弱的目標與語意重疊的描述,仍是困難的案例。
輸出的適用範圍
釋出的推論路徑以 32 kHz 單聲道為主,適合以語言查詢的擷取與開放領域研究,但無法取代 44.1 kHz 立體聲的製作用 stem。改動描述就會改動條件向量,目標邊界也可能隨之移動。
從 AudioSep 到 Hive
AudioSep 在 2023 年以自然語言查詢實現開放領域分離。Hive 延續這條路線,採用語意一致的資料建構與資料效率更高的訓練。論文、Hive 儲存庫與模型卡分別記載方法、資料集實作與釋出的權重。
查詢成為固定 stem 之外的變數
傳統音樂分離器在訓練前就先定義人聲、鼓與貝斯。AudioSep 把 CLAP 的文字-音訊表徵接上分離器,讓警笛、次中音薩克斯風或女性語音都能成為目標。Hive 以更大規模的弱標註音訊-文字覆蓋延續這條路線,支撐開放類別。
開放詞彙不等於 283 個獨立檢查點。訓練類別提供聲學與語言覆蓋;推論時改變的是文字向量。從「dog」換成「small dog barking behind music」會移動條件,但若混音中本來沒有可分離的來源邊界,語言也無法憑空造出一個。
語言查詢如何變成時頻遮罩
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)X混音 STFTe_q文字查詢嵌入Mθ以查詢為條件的遮罩
查詢 q 會以 e_q 的形式嵌入共享的音訊-語言空間,作為遮罩估計器的條件。283 個標籤描述訓練覆蓋範圍;單一任務中並不存在 283 個固定的輸出 stem。
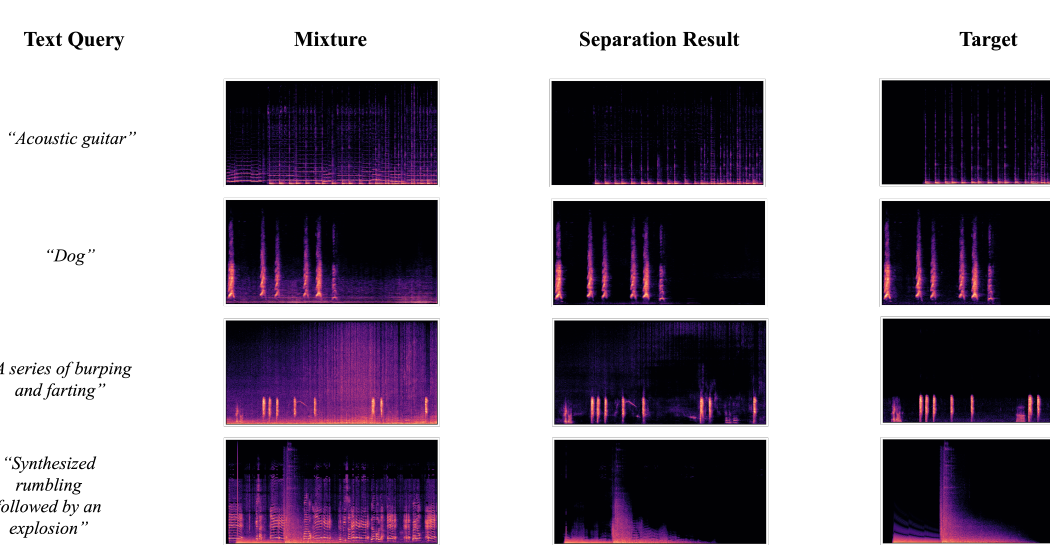
同一種聲音有許多說法,否定或關係詞都可能改變結果。固定音訊、改寫查詢措辭,再檢查目標保留、洩漏與混音一致性。
論文、程式碼與權重可循 Hive source / AudioSep-Hive weights / AudioSep paper 取得。
開放查詢與固定 stem 的對照
比較的是輸入契約與驗收方式,並非互不相容任務的分數。
| 路線 | 查詢 | 主要驗收檢查 |
|---|---|---|
| AudioSep-Hive | 自然語言目標 | 輸出是否符合指定的聲音 |
| 固定音樂 stem | 預先定義的類別 | 串音與立體聲保留 |
| 聲音事件偵測 | 類別加時間區間 | 能定位事件,但不回傳乾淨波形 |
寫查詢就是聲學標註
寬泛的名詞會讓模型在候選之間妥協;過長的描述可能丟掉罕見的修飾語。從聽得到的來源寫起,再補上位置、音域或動作,勝過抽象的場景敘事。
開放類別路線以 32 kHz 單聲道的研究型推論為主,適合檢索、清理與探索。固定的 44.1 kHz 立體聲音樂 stem 仍是另一種製作任務。
CLAP 空間並非實體分離器
高度相關的來源、微弱的目標與強殘響,不會只因語意不同就存在唯一遮罩。鄰近的場景音訊可能滲入結果。
語言查詢本身就是實驗變數。比較時應固定混音與模型,稽核目標保留、非目標洩漏,以及重組後的混音一致性。
Hive 來源的論文與公開檔案
模型名稱、數字與限制均可追溯至下列論文、儲存庫或模型卡。