Mô hình
AudioSep-Hive: Tách âm thanh tùy ý bằng truy vấn văn bản
Tách âm/ghi chú kỹ thuật
Tách âm/ghi chú kỹ thuật
© 2026 TelkNet. Đã đăng ký Bản quyền.
TÁCH ÂM THANH / GHI CHÚ KỸ THUẬT
Bộ tách stem cố định quyết định không gian câu trả lời trước cả khi suy luận. AudioSep-Hive đọc mô tả trước, rồi dùng nó để quyết định thành phần nào trong hỗn hợp là mục tiêu.
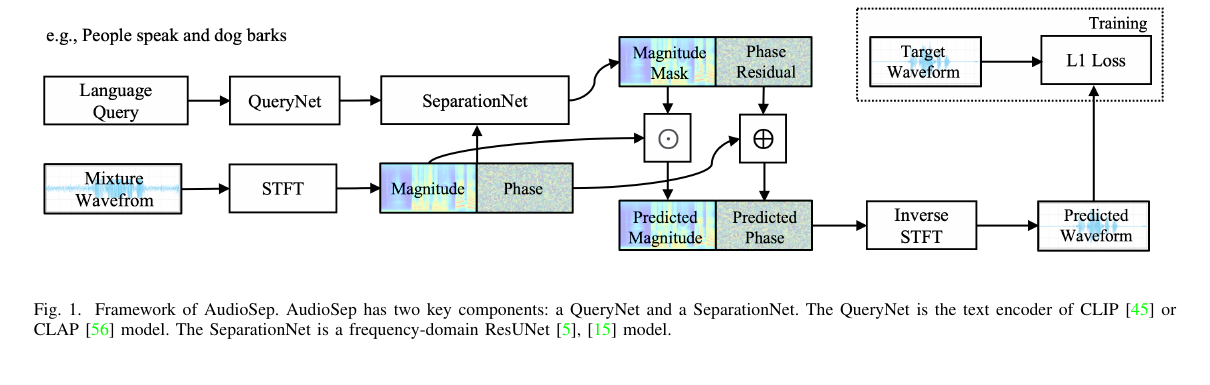
Với x(t)=s(t)+n(t), bộ mã hóa văn bản cho ra q=E_text(c). Bộ tách ước lượng M=F(X,q) và tái dựng Ŝ=M⊙X. Dạng rút gọn của hàm mục tiêu:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Số hạng ngữ nghĩa khiến các mô tả liên quan nằm trong một không gian truy vấn liên tục. Nó không xóa được sự mơ hồ: những câu lệnh rộng, mục tiêu yếu và các mô tả ngữ nghĩa chồng lấp vẫn là những trường hợp khó.
Đường suy luận được phát hành chủ yếu là mono 32 kHz. Nó hữu ích cho việc trích xuất bằng truy vấn ngôn ngữ và nghiên cứu miền mở, nhưng không thay thế được các stem sản xuất stereo 44.1 kHz. Đổi mô tả là đổi vector điều kiện, và ranh giới mục tiêu có thể dịch chuyển theo.
AudioSep đã giới thiệu khả năng tách miền mở qua truy vấn ngôn ngữ tự nhiên vào năm 2023. Hive nối dài hướng đi đó bằng cách xây dựng dữ liệu nhất quán về mặt ngữ nghĩa và huấn luyện tiết kiệm dữ liệu. Bài báo, kho mã nguồn Hive và model card lần lượt ghi lại phương pháp, cách hiện thực bộ dữ liệu và các trọng số đã phát hành.
Các bộ tách nhạc truyền thống định nghĩa sẵn giọng hát, trống và bass trước khi huấn luyện. AudioSep nối biểu diễn văn bản-âm thanh CLAP với một bộ tách, cho phép nhắm tới những mục tiêu như tiếng còi hụ, kèn saxophone tenor hay giọng nói nữ. Hive tiếp nối hướng đi ấy với độ bao phủ âm thanh-văn bản gán nhãn yếu lớn hơn cho các danh mục mở.
Từ vựng mở không có nghĩa là 283 checkpoint độc lập. Các lớp huấn luyện cung cấp độ bao phủ về âm học lẫn ngôn ngữ; thứ thay đổi lúc suy luận là vector văn bản. Chuyển từ 'dog' sang 'small dog barking behind music' làm dịch điều kiện, nhưng ngôn ngữ không thể tạo ra ranh giới nguồn tách biệt vốn không tồn tại trong hỗn hợp.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT của hỗn hợpe_qembedding của truy vấn văn bảnMθmặt nạ có điều kiện theo truy vấnTruy vấn q được nhúng vào một không gian âm thanh-ngôn ngữ dùng chung dưới dạng e_q, và nó điều kiện hóa một bộ ước lượng mặt nạ. 283 nhãn mô tả độ bao phủ huấn luyện; chúng không phải 283 stem đầu ra cố định trong một tác vụ.
Một âm thanh có nhiều cách diễn đạt, và phép phủ định hay các quan hệ có thể làm kết quả thay đổi. Giữ nguyên âm thanh, diễn đạt lại truy vấn, rồi kiểm tra mức giữ lại mục tiêu, độ rò rỉ và tính nhất quán của hỗn hợp.
Có thể truy theo bài báo, mã nguồn và trọng số qua Hive source / AudioSep-Hive weights / AudioSep paper.
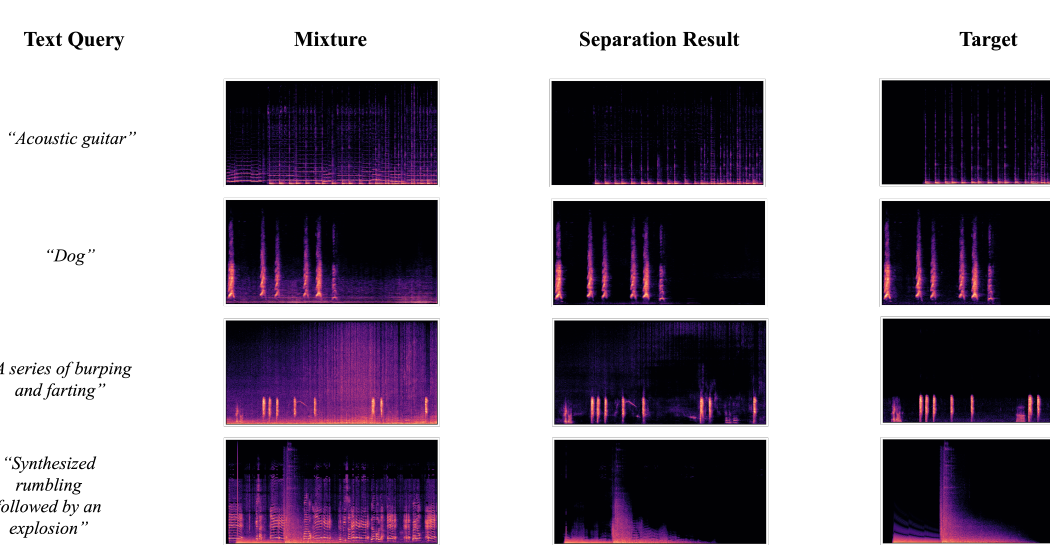
Phép so sánh ở đây nhìn vào hợp đồng đầu vào và cách kiểm chứng, không phải điểm số từ những tác vụ không tương thích.
| Hướng đi | Truy vấn | Tiêu chí nghiệm thu chính |
|---|---|---|
| AudioSep-Hive | mục tiêu bằng ngôn ngữ tự nhiên | đầu ra có khớp với âm thanh được yêu cầu không |
| stem nhạc cố định | các lớp định sẵn | nhiễm chéo và độ giữ stereo |
| phát hiện sự kiện âm thanh | lớp kèm khoảng thời gian | định vị sự kiện nhưng không trả về dạng sóng sạch |
Một danh từ rộng buộc mô hình phải thỏa hiệp giữa các ứng viên; một mô tả quá dài có thể làm mất những bổ nghĩa hiếm gặp. Hãy bắt đầu từ nguồn âm nghe được, rồi thêm vị trí, âm vực hoặc hành động thay vì kể lại cảnh một cách trừu tượng.
Đường danh mục mở chủ yếu là suy luận nghiên cứu mono 32 kHz, hữu ích cho truy hồi, làm sạch và khám phá. Các stem nhạc stereo 44.1 kHz cố định vẫn là một bài toán sản xuất khác.
Những nguồn tương quan mạnh, mục tiêu yếu và reverb lớn không có một mặt nạ duy nhất chỉ vì ngữ nghĩa của chúng khác nhau. Âm thanh cảnh lân cận có thể rò vào kết quả.
Bản thân truy vấn ngôn ngữ cũng là một biến thực nghiệm. Khi so sánh cần giữ cố định hỗn hợp và mô hình, đồng thời kiểm toán mức giữ lại mục tiêu, rò rỉ ngoài mục tiêu và tính nhất quán của hỗn hợp sau khi ghép lại.
Tên mô hình, các con số và giới hạn được truy về các bài báo, kho mã nguồn hoặc model card bên dưới.