মডেল
AudioSep-Hive: একটি টেক্সট ক্যোয়ারী দিয়ে স্বেচ্ছাচারী শব্দ আলাদা করুন
শব্দ বিচ্ছেদ / প্রযুক্তিগত নোট
শব্দ বিচ্ছেদ / প্রযুক্তিগত নোট
শব্দ বিচ্ছিন্নকরণ / প্রযুক্তিগত নোট
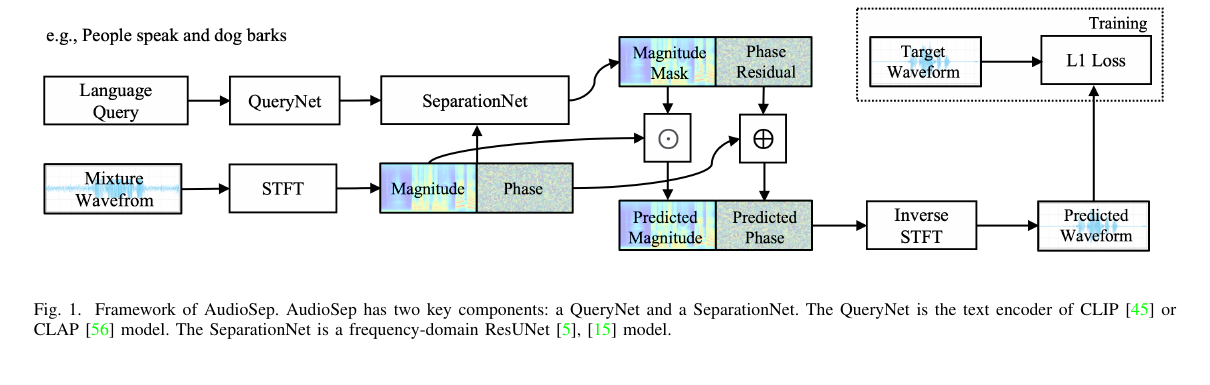
একটি নির্দিষ্ট-স্টেম সেপারেটর ইনফারেন্সের আগেই উত্তরের সীমা ঠিক করে দেয়। AudioSep-Hive আগে একটি বর্ণনা পড়ে, তারপর সেটি দিয়ে নির্ধারণ করে মিশ্রণের কোন অংশটি লক্ষ্য।
x(t)=s(t)+n(t)-এর ক্ষেত্রে টেক্সট এনকোডার q=E_text(c) দেয়। সেপারেটর M=F(X,q) অনুমান করে এবং Ŝ=M⊙X পুনর্গঠন করে। উদ্দেশ্যটির সংক্ষিপ্ত রূপ:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
শব্দার্থগত পদটি সম্পর্কিত বর্ণনাগুলোকে একটি ধারাবাহিক ক্যোয়ারি স্পেসে স্থান দেয়। এটি অস্পষ্টতা দূর করে না: বিস্তৃত প্রম্পট, দুর্বল লক্ষ্য এবং পরস্পরের সঙ্গে ওভারল্যাপ করা শব্দার্থগত বর্ণনা এখনও কঠিন কেস।
প্রকাশিত ইনফারেন্স পথটি মূলত 32 kHz মোনো। ভাষা-ক্যোয়ারি নির্ভর এক্সট্রাকশন ও ওপেন-ডোমেইন গবেষণায় এটি কাজে লাগে, কিন্তু এটি 44.1 kHz স্টেরিও প্রোডাকশন স্টেমের বিকল্প নয়। বর্ণনা বদলালে কন্ডিশন ভেক্টরও বদলায়, আর তাতে লক্ষ্যের সীমানাও সরে যেতে পারে।
2023 সালে AudioSep প্রাকৃতিক-ভাষার ক্যোয়ারির মাধ্যমে ওপেন-ডোমেইন বিচ্ছিন্নকরণের সূচনা করে। Hive সেই ধারাকে এগিয়ে নিয়ে যায় শব্দার্থগতভাবে সামঞ্জস্যপূর্ণ ডেটা নির্মাণ ও ডেটা-দক্ষ প্রশিক্ষণের মাধ্যমে। পেপার, Hive রিপোজিটরি ও মডেল কার্ড যথাক্রমে পদ্ধতি, ডেটাসেট বাস্তবায়ন ও প্রকাশিত ওজনের তথ্য নথিভুক্ত করে।
প্রচলিত মিউজিক সেপারেটর প্রশিক্ষণের আগেই ভোকাল, ড্রাম ও বেস নির্ধারণ করে দেয়। AudioSep একটি সেপারেটরের সঙ্গে CLAP টেক্সট-অডিও রিপ্রেজেন্টেশন যুক্ত করে, ফলে সাইরেন, টেনর স্যাক্সোফোন বা নারীর কণ্ঠস্বরের মতো লক্ষ্য নির্বাচন করা যায়। উন্মুক্ত ক্যাটাগরির জন্য বৃহত্তর দুর্বল-লেবেলযুক্ত অডিও-টেক্সট কভারেজ নিয়ে Hive সেই ধারা অব্যাহত রাখে।
ওপেন ভোকাবুলারি মানে 283টি স্বাধীন চেকপয়েন্ট নয়। প্রশিক্ষণ ক্লাসগুলো অ্যাকুস্টিক ও ভাষাগত কভারেজ দেয়; ইনফারেন্সে বদলায় টেক্সট ভেক্টরটি। 'dog' থেকে 'small dog barking behind music'-এ গেলে কন্ডিশন সরে যায়, কিন্তু মিশ্রণে যে বিচ্ছেদ্য উৎস-সীমানা নেই, ভাষা সেটি তৈরি করতে পারে না।
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)Xমিশ্রণের STFTe_qটেক্সট-ক্যোয়ারি এমবেডিংMθক্যোয়ারি-কন্ডিশনড মাস্কক্যোয়ারি q একটি ভাগ করা অডিও-ভাষা স্পেসে e_q হিসেবে এমবেড হয়, যা একটি মাস্ক এস্টিমেটরকে কন্ডিশন করে। 283টি লেবেল প্রশিক্ষণের কভারেজ বর্ণনা করে; একটি টাস্কে এগুলো 283টি নির্দিষ্ট আউটপুট স্টেম নয়।
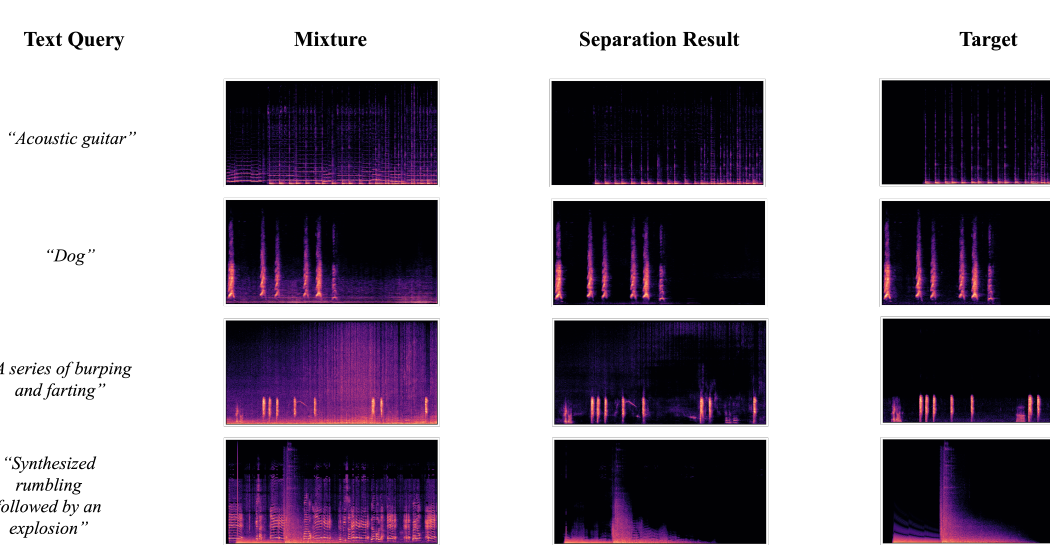
একই শব্দের অনেক রকম প্রকাশ থাকে, আর নেগেশন বা সম্পর্কের উল্লেখ ফল বদলে দিতে পারে। অডিও অপরিবর্তিত রেখে ক্যোয়ারি প্যারাফ্রেজ করুন, তারপর টার্গেট রিটেনশন, লিকেজ ও মিক্সচার কনসিস্টেন্সি পরীক্ষা করুন।
পেপার, কোড ও ওজন অনুসরণ করা যাবে Hive source / AudioSep-Hive weights / AudioSep paper-এর মাধ্যমে।
তুলনাটি ইনপুট কন্ট্রাক্ট ও যাচাইকরণের মানদণ্ড নিয়ে; পরস্পরের সঙ্গে মেলে না এমন টাস্কের স্কোর নিয়ে নয়।
| রুট | ক্যোয়ারি | প্রাথমিক গ্রহণযোগ্যতা যাচাই |
|---|---|---|
| AudioSep-Hive | প্রাকৃতিক-ভাষার লক্ষ্য | আউটপুট কি চাওয়া শব্দের সঙ্গে মিলছে |
| নির্দিষ্ট মিউজিক স্টেম | পূর্বনির্ধারিত ক্লাস | ক্রস-ব্লিড ও স্টেরিও সংরক্ষণ |
| শব্দ-ঘটনা শনাক্তকরণ | ক্লাস ও সময়সীমা | ঘটনা স্থানীয়করণ করে, কিন্তু পরিষ্কার ওয়েভফর্ম ফেরত দেয় না |
বিস্তৃত বিশেষ্য মডেলকে সম্ভাব্য উত্তরগুলোর মধ্যে আপসে বাধ্য করে; অতিরিক্ত লম্বা বর্ণনায় বিরল বিশেষণ হারিয়ে যেতে পারে। শোনা যাচ্ছে এমন উৎস দিয়ে শুরু করুন, তারপর বিমূর্ত দৃশ্য-বর্ণনার বদলে অবস্থান, রেজিস্টার বা ক্রিয়া যোগ করুন।
ওপেন-ক্যাটাগরি পথটি মূলত মোনো 32 kHz গবেষণা-ইনফারেন্স; রিট্রিভাল, ক্লিনআপ ও আবিষ্কারে কার্যকর। নির্দিষ্ট 44.1 kHz স্টেরিও মিউজিক স্টেম আলাদা প্রোডাকশন টাস্কই রয়ে গেছে।
শব্দার্থ আলাদা হলেই বহুল সম্পর্কযুক্ত উৎস, দুর্বল লক্ষ্য বা তীব্র রিভার্বের জন্য অনন্য কোনো মাস্ক তৈরি হয় না। পাশের দৃশ্যের অডিও ফলাফলে ঢুকে পড়তে পারে।
ভাষার ক্যোয়ারি নিজেই একটি পরীক্ষণ-চলক। তুলনায় মিশ্রণ ও মডেল অপরিবর্তিত রেখে টার্গেট রিটেনশন, নন-টার্গেট লিকেজ এবং পুনঃসংমিশ্রণের পর মিক্সচার কনসিস্টেন্সি নিরীক্ষণ করা উচিত।
মডেলের নাম, সংখ্যা ও সীমাবদ্ধতার উৎস নিচের পেপার, রিপোজিটরি বা মডেল কার্ডগুলো।