Modell
AudioSep-Hive: Skill vilkårlige lyder med en tekstspørring
Lydseparasjon / tekniske merknader
Lydseparasjon / tekniske merknader
LYDSEPARASJON / TEKNISK NOTAT
En separator med faste stems fastlegger svarrommet før inferens. AudioSep-Hive leser en beskrivelse først og bruker den til å avgjøre hvilken del av miksen som er målet.
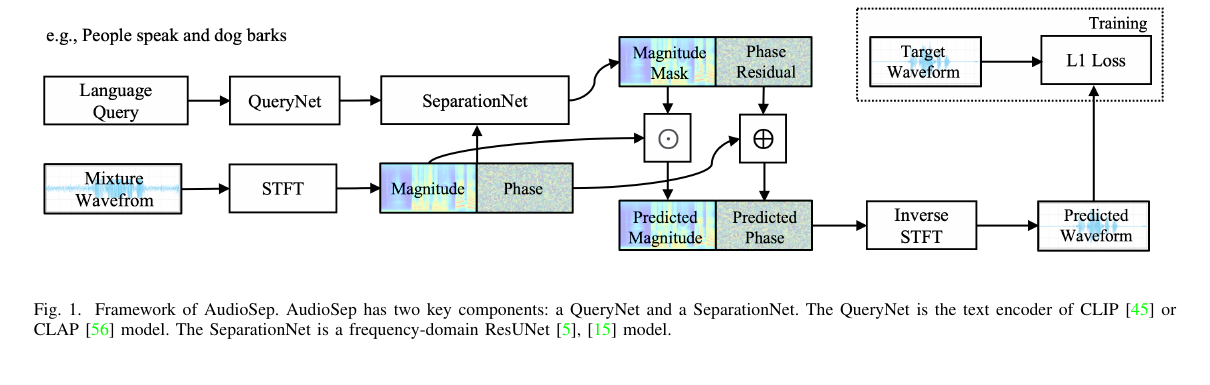
For x(t)=s(t)+n(t) gir tekstkoderen q=E_text(c). Separatoren estimerer M=F(X,q) og rekonstruerer Ŝ=M⊙X. En kompakt form for målet:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Det semantiske leddet lar beslektede beskrivelser dele et kontinuerlig spørringsrom. Det fjerner ikke tvetydighet: brede beskrivelser, svake mål og semantisk overlappende formuleringer forblir vanskelige tilfeller.
Den utgitte inferensveien er i hovedsak 32 kHz mono. Den egner seg for språkstyrt uttrekking og forskning på åpne domener, men erstatter ikke 44.1 kHz stereo-stems for produksjon. Endrer du beskrivelsen, endres betingelsesvektoren, og målgrensen kan flytte seg.
AudioSep introduserte separasjon på åpne domener med naturlig-språklige spørringer i 2023. Hive fører linjen videre med semantisk konsistent datakonstruksjon og dataeffektiv trening. Artikkelen, Hive-repositoriet og modellkortet dokumenterer henholdsvis metoden, datasettimplementasjonen og de utgitte vektene.
Tradisjonelle musikkseparatorer definerer vokal, trommer og bass før trening. AudioSep koblet CLAPs tekst-lyd-representasjoner til en separator og åpnet for mål som en sirene, en tenorsaksofon eller kvinnelig tale. Hive fører linjen videre med større svakt merket lyd-tekst-dekning for åpne kategorier.
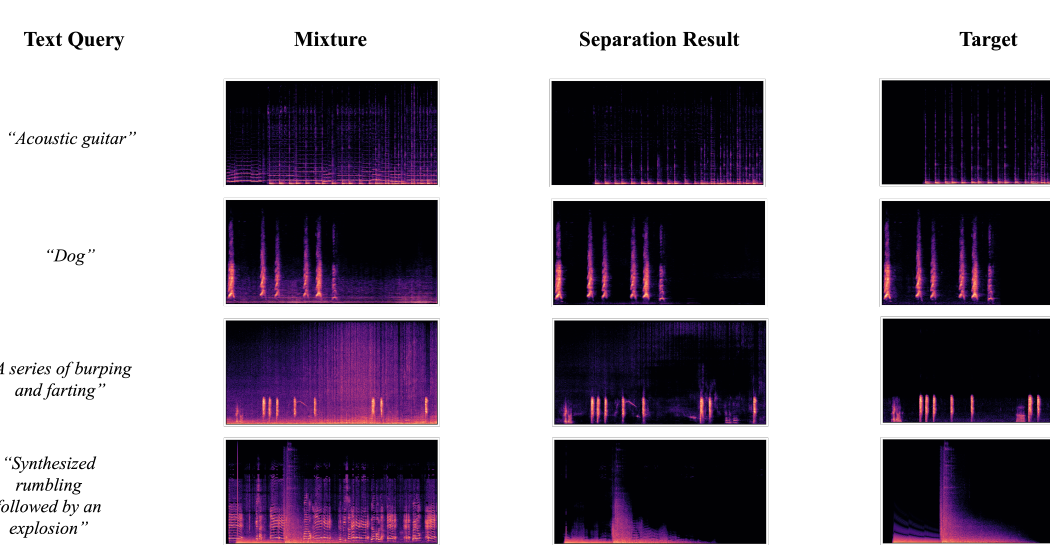
Åpent vokabular betyr ikke 283 uavhengige checkpoints. Treningsklassene gir akustisk og språklig dekning; det er tekstvektoren som endres ved inferens. Å gå fra 'dog' til 'small dog barking behind music' flytter betingelsen, men språk kan ikke skape en separerbar kildegrense som ikke finnes i miksen.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT for miksene_qembedding av tekstspørringenMθspørringsbetinget maskeSpørringen q embeddes i et delt lyd-språk-rom som e_q, som betinger et maskeestimat. De 283 etikettene beskriver treningsdekningen; de er ikke 283 faste utdata-stems i én oppgave.
Én lyd kan formuleres på mange måter, og nektelser eller relasjoner kan endre resultatet. Hold lyden fast, parafraser spørringen, og undersøk deretter målbevaring, lekkasje og mikskonsistens.
Artikkel, kode og vekter kan følges via Hive source / AudioSep-Hive weights / AudioSep paper.
Her sammenlignes inndatakontrakter og validering, ikke score fra inkompatible oppgaver.
| Tilnærming | Spørring | Primær akseptsjekk |
|---|---|---|
| AudioSep-Hive | naturlig-språklig mål | samsvarer utdata med den forespurte lyden |
| faste musikk-stems | forhåndsdefinerte klasser | overhøring og stereobevaring |
| lydhendelsesdeteksjon | klasse pluss tidsspenn | lokaliserer hendelser, men returnerer ikke en ren bølgeform |
Et bredt substantiv tvinger modellen til å gå på kompromisser blant kandidatene; en svært lang beskrivelse kan miste sjeldne tilleggsord. Begynn med den hørbare kilden, og legg deretter til sted, register eller handling i stedet for en abstrakt scenefortelling.
Den åpne-kategori-veien er i hovedsak mono 32 kHz forskningsinferens, nyttig for uthenting, opprydding og oppdagelse. Faste 44.1 kHz stereo musikk-stems forblir en annen produksjonsoppgave.
Sterkt korrelerte kilder, svake mål og kraftig etterklang får ikke en entydig maske bare fordi semantikken skiller seg. Nærliggende scenelyd kan lekke inn i resultatet.
Språkspørringen er i seg selv en eksperimentell variabel. Sammenligninger bør holde miks og modell fast mens målbevaring, lekkasje fra ikke-mål og mikskonsistens etter rekombinering granskes.
Modellnavn, tall og begrensninger kan spores til artiklene, repositoriene eller modellkortene nedenfor.