Modelo
AudioSep-Hive: Separe sonidos arbitrarios con una consulta de texto
Separación de sonido / notas técnicas
Separación de sonido / notas técnicas
© 2026 TelkNet. Todos los derechos reservados.
SEPARACIÓN DE SONIDO / NOTA TÉCNICA
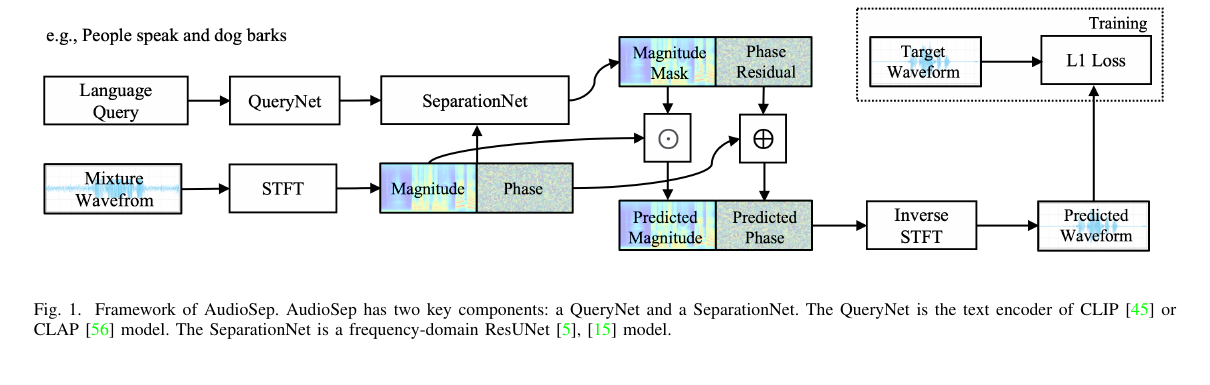
Un separador de stems fijos decide el espacio de respuestas antes de la inferencia. AudioSep-Hive lee primero una descripción y la usa para decidir qué componente de la mezcla es el objetivo.
Para x(t)=s(t)+n(t), el codificador de texto produce q=E_text(c). El separador estima M=F(X,q) y reconstruye Ŝ=M⊙X. Una vista compacta del objetivo es:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
El término semántico hace que las descripciones afines ocupen un espacio de consultas continuo. No elimina la ambigüedad: las indicaciones amplias, los objetivos débiles y las descripciones semánticas solapadas siguen siendo casos difíciles.
La ruta de inferencia publicada es principalmente mono a 32 kHz. Sirve para la extracción mediante consultas en lenguaje y para la investigación de dominio abierto, pero no sustituye a los stems de producción estéreo a 44.1 kHz. Cambiar la descripción cambia el vector de condición y puede desplazar la frontera del objetivo.
AudioSep introdujo en 2023 la separación de dominio abierto mediante consultas en lenguaje natural. Hive prolonga esa línea con una construcción de datos semánticamente coherente y un entrenamiento eficiente en datos. El artículo, el repositorio Hive y la ficha del modelo documentan, respectivamente, el método, la implementación del conjunto de datos y los pesos publicados.
Los separadores musicales tradicionales definen voces, batería y bajo antes del entrenamiento. AudioSep conectó las representaciones texto-audio de CLAP con un separador, lo que permitió objetivos como una sirena, un saxofón tenor o una voz femenina. Hive continúa esa línea con una cobertura audio-texto más amplia y débilmente etiquetada para categorías abiertas.
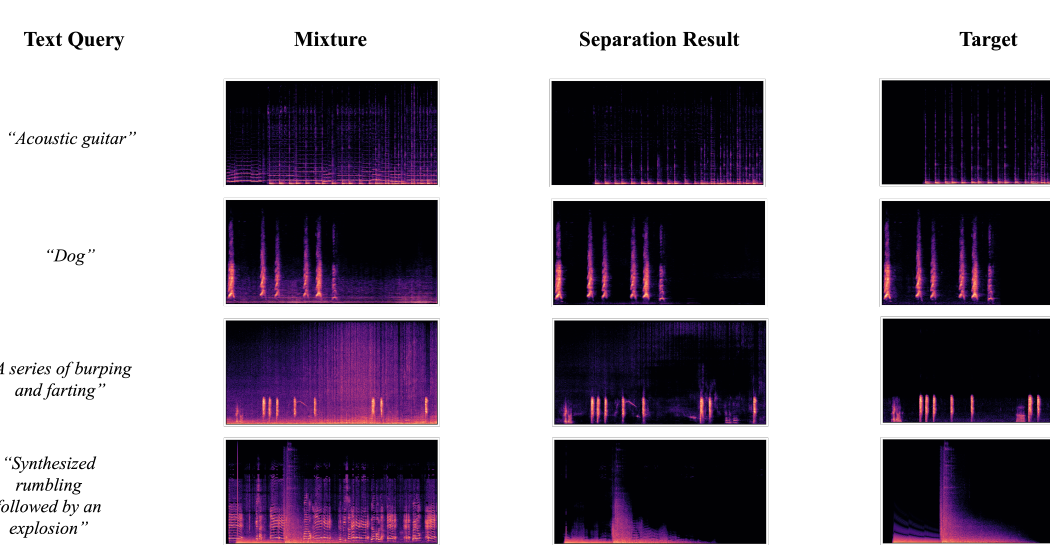
Vocabulario abierto no significa 283 puntos de control independientes. Las clases de entrenamiento aportan cobertura acústica y lingüística; el vector de texto es lo que cambia en la inferencia. Pasar de 'dog' a 'small dog barking behind music' desplaza la condición, pero el lenguaje no puede crear una frontera de fuente separable que no exista en la mezcla.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT de la mezclae_qembedding de la consulta de textoMθmáscara condicionada por la consultaLa consulta q se incrusta en un espacio compartido audio-lenguaje como e_q, que condiciona un estimador de máscara. Las 283 etiquetas describen la cobertura de entrenamiento; no son 283 stems de salida fijos en una sola tarea.
Un mismo sonido admite muchas formulaciones, y la negación o las relaciones pueden cambiar el resultado. Mantén fijo el audio, parafrasea la consulta y luego inspecciona la retención del objetivo, las fugas y la consistencia de la mezcla.
El artículo, el código y los pesos pueden consultarse en Hive source / AudioSep-Hive weights / AudioSep paper.
Se comparan contratos de entrada y validación, no puntuaciones de tareas incompatibles.
| Ruta | Consulta | Comprobación principal de aceptación |
|---|---|---|
| AudioSep-Hive | objetivo en lenguaje natural | si la salida coincide con el sonido solicitado |
| stems musicales fijos | clases predefinidas | contaminación cruzada y preservación del estéreo |
| detección de eventos sonoros | clase más intervalo temporal | localiza eventos pero no devuelve una forma de onda limpia |
Un sustantivo amplio obliga al modelo a transigir entre candidatos; una descripción muy larga puede perder modificadores poco frecuentes. Empieza por la fuente audible y luego añade ubicación, registro o acción en lugar de una narración abstracta de la escena.
La ruta de categorías abiertas es principalmente inferencia de investigación mono a 32 kHz, útil para recuperación, limpieza y descubrimiento. Los stems musicales fijos estéreo a 44.1 kHz siguen siendo una tarea de producción distinta.
Las fuentes altamente correlacionadas, los objetivos débiles y la reverberación fuerte no tienen una máscara única solo porque su semántica difiera. El audio de escenas vecinas puede filtrarse en el resultado.
La consulta en lenguaje es en sí misma una variable experimental. Las comparaciones deben mantener fijos la mezcla y el modelo mientras se audita la retención del objetivo, la fuga de fuentes ajenas y la consistencia de la mezcla tras la recombinación.
Los nombres de modelos, las cifras y las limitaciones se remiten a los artículos, repositorios o fichas de modelo que figuran a continuación.