모델
AudioSep-Hive: 텍스트 쿼리로 임의의 사운드를 분리합니다.
소리 분리/기술 노트
소리 분리/기술 노트
사운드 분리 / 기술 노트
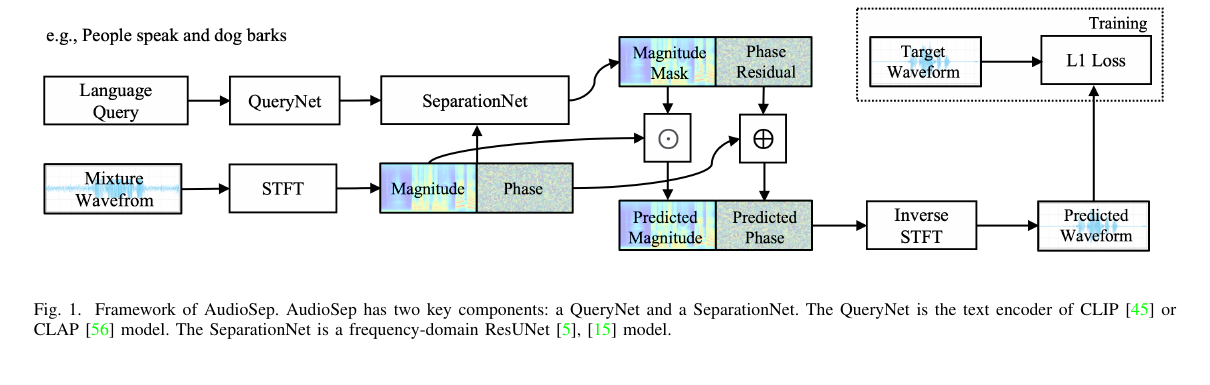
고정 스템 분리기는 추론에 앞서 답의 공간부터 정해 둔다. AudioSep-Hive는 먼저 설명 문장을 읽고, 그 문장으로 믹스처의 어느 성분이 타깃인지를 결정한다.
x(t)=s(t)+n(t)에서 텍스트 인코더는 q=E_text(c)를 산출한다. 분리기는 M=F(X,q)를 추정하고 Ŝ=M⊙X로 복원한다. 목적 함수를 간략하게 적으면 다음과 같다:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
시맨틱 항은 비슷한 설명들이 연속적인 질의 공간에 놓이게 한다. 그렇다고 모호함이 사라지지는 않는다. 넓은 프롬프트, 약한 타깃, 의미가 겹치는 설명은 여전히 어려운 사례로 남는다.
공개된 추론 경로는 기본적으로 32 kHz 모노다. 언어 질의 추출과 오픈 도메인 연구에는 유용하지만, 44.1 kHz 스테레오 프로덕션 스템을 대체하는 도구는 아니다. 설명 문장을 바꾸면 조건 벡터가 바뀌고, 타깃 경계가 움직일 수 있다.
AudioSep은 2023년에 자연어 질의를 통한 오픈 도메인 분리를 선보였다. Hive는 의미적으로 일관된 데이터 구축과 데이터 효율적인 학습으로 그 흐름을 이어 간다. 방법은 논문에, 데이터셋 구현은 Hive 리포지토리에, 공개 가중치는 모델 카드에 각각 정리되어 있다.
전통적인 음악 분리기는 학습 전에 보컬, 드럼, 베이스를 미리 정의한다. AudioSep은 CLAP 텍스트-오디오 표현을 분리기에 연결해 사이렌, 테너 색소폰, 여성 음성 같은 타깃을 가능하게 했다. Hive는 오픈 카테고리를 겨냥해 더 넓은 약지도 오디오-텍스트 커버리지로 그 흐름을 잇는다.
오픈 보캐뷸러리가 283개의 독립 체크포인트를 뜻하지는 않는다. 학습 클래스가 음향적·언어적 커버리지를 제공하고, 추론 시점에 바뀌는 것은 텍스트 벡터뿐이다. '개'에서 '음악 뒤에서 짖는 작은 개'로 옮기면 조건이 이동하지만, 언어가 믹스처에 없는 분리 가능한 소스 경계를 만들어 내지는 못한다.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)X믹스처 STFTe_q텍스트 질의 임베딩Mθ질의 조건화 마스크질의 q는 공유 오디오-언어 공간에 e_q로 임베딩되어 마스크 추정기를 조건화한다. 283개 레이블은 학습 커버리지를 나타낼 뿐, 한 태스크의 고정 출력 스템 283개가 아니다.
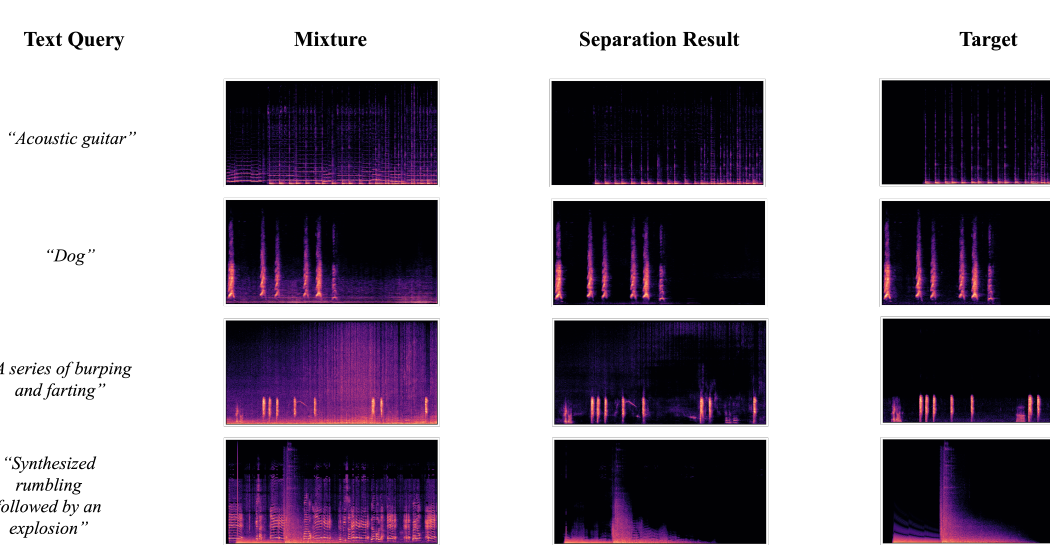
하나의 소리에는 여러 표현이 있고, 부정이나 관계 표현은 결과를 바꿀 수 있다. 오디오는 고정한 채 질의를 바꿔 보고, 타깃 유지와 리키지, 믹스처 일관성을 살펴야 한다.
논문과 코드, 가중치는 Hive 소스 / AudioSep-Hive 가중치 / AudioSep 논문에서 이어서 확인할 수 있다.
비교하는 것은 입력 계약과 검증 방식이지, 호환되지 않는 태스크의 점수가 아니다.
| 경로 | 질의 | 주요 수용 확인 |
|---|---|---|
| AudioSep-Hive | 자연어 타깃 | 출력이 요청한 소리와 일치하는가 |
| 고정 음악 스템 | 사전 정의된 클래스 | 크로스블리드와 스테레오 보존 |
| 사운드 이벤트 검출 | 클래스와 시간 구간 | 이벤트 위치는 잡지만 깨끗한 파형을 돌려주지는 않는다 |
넓은 명사는 모델이 후보들 사이에서 타협하게 만들고, 지나치게 긴 설명은 드문 수식어를 놓칠 수 있다. 추상적인 장면 서술보다, 들리는 소스에서 시작해 위치나 음역, 동작을 덧붙이는 편이 낫다.
오픈 카테고리 경로는 기본적으로 모노 32 kHz 연구용 추론으로, 검색과 정리, 발견에 유용하다. 고정된 44.1 kHz 스테레오 음악 스템은 여전히 별도의 프로덕션 태스크다.
강하게 상관된 소스, 약한 타깃, 심한 리버브는 의미가 다르다고 해서 유일한 마스크를 갖지 않는다. 주변 장면 오디오가 결과에 새어 들어올 수 있다.
언어 질의 그 자체가 실험 변수다. 비교할 때는 믹스처와 모델을 고정한 채, 타깃 유지와 비타깃 리키지, 재합성 후 믹스처 일관성을 점검해야 한다.
모델명, 수치, 한계는 아래 논문과 리포지토리, 모델 카드에서 확인할 수 있다.