モデル
AudioSep-Hive: テキスト クエリで任意のサウンドを分離する
音の分離 / 技術的なメモ
音の分離 / 技術的なメモ
音源分離 / テクニカルノート
固定ステム型の分離器は、推論を始める前に答えの空間を決めてしまう。AudioSep-Hive はまず記述文を読み取り、それを手がかりに混合音のどの成分をターゲットにするかを決める。
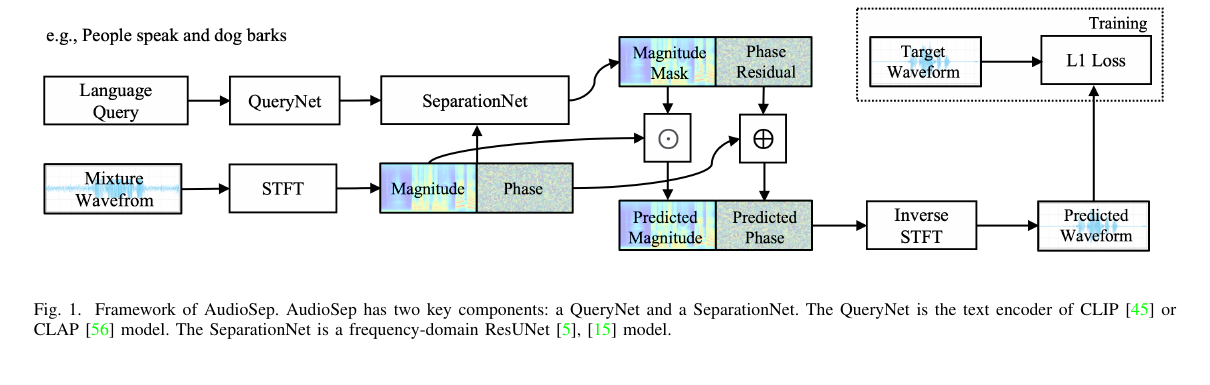
x(t)=s(t)+n(t) に対し、テキストエンコーダーは q=E_text(c) を出力する。分離器は M=F(X,q) を推定し、Ŝ=M⊙X として再構成する。目的関数をコンパクトに書くと次のようになる。
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
この意味項のおかげで、関連する記述は連続的なクエリ空間の中に配置される。ただし曖昧さが消えるわけではない。広すぎるプロンプト、弱いターゲット、意味の重なった記述は、依然として難しいケースのままだ。
公開されている推論パスは基本的に 32 kHz モノラルだ。言語クエリによる抽出やオープンドメインの研究には使いやすいが、44.1 kHz ステレオの制作用ステムを置き換える存在ではない。記述を変えれば条件ベクトルが変わり、ターゲットの境界も動きうる。
AudioSep は 2023 年、自然言語クエリによるオープンドメイン分離を打ち出した。Hive はその系譜を、意味的に一貫したデータ構築とデータ効率の高い学習によって引き継ぐ。手法は論文が、データセットの実装は Hive リポジトリが、公開済みの重みはモデルカードが、それぞれ記録している。
従来の音楽分離器は、学習の前にボーカル、ドラム、ベースを定義する。AudioSep は CLAP のテキスト・音声表現を分離器につなぎ、サイレン、テナーサクソフォン、女性の話し声をターゲットにすることを可能にした。Hive はその流れを、オープンなカテゴリに向けた、より大規模な弱ラベル付き音声・テキストのカバレッジで推し進める。
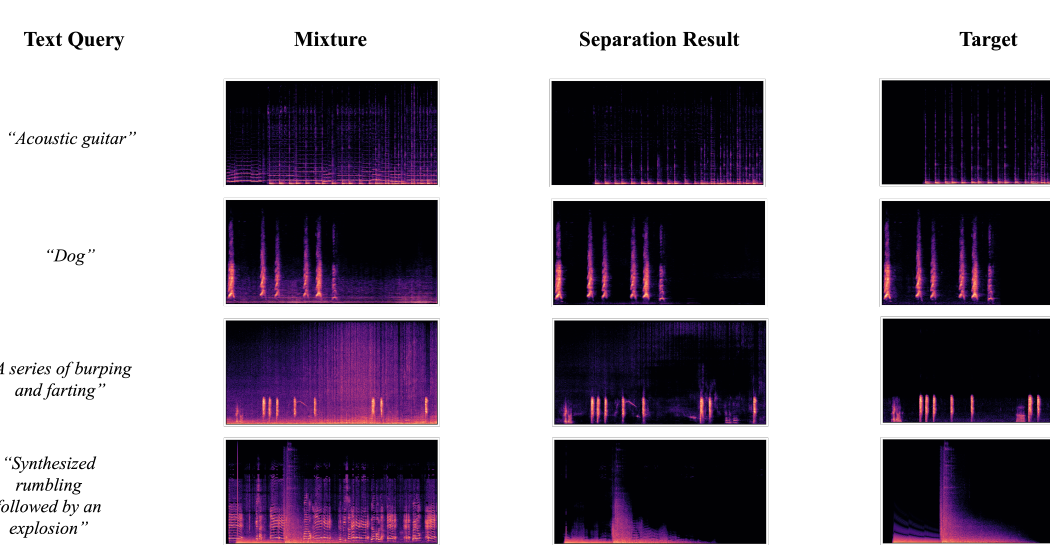
語彙が開かれているからといって、283 個の独立したチェックポイントがあるわけではない。学習クラスが音響と言語のカバレッジを提供し、推論時に変わるのはテキストベクトルのほうだ。'dog' から 'small dog barking behind music' へ変えれば条件は動くが、混合音に存在しない分離可能な音源の境界を、言語が新たに作り出すことはできない。
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)X混合音の STFTe_qテキストクエリの埋め込みMθクエリ条件付きマスククエリ q は e_q として音声・言語の共有空間に埋め込まれ、マスク推定器を条件付ける。283 のラベルが示すのは学習のカバレッジであり、ひとつのタスクに 283 の固定出力ステムがあるという意味ではない。
ひとつの音にも言い回しはいくつもあり、否定や関係の表現で結果が変わりうる。音声を固定したままクエリを言い換え、ターゲットの保持、漏洩、混合音との整合性を確かめるとよい。
論文、コード、重みは Hive source / AudioSep-Hive weights / AudioSep paper から辿れる。
比べるのは入力の約束事と検証方法であり、互換性のないタスクのスコアではない。
| 方式 | クエリ | 主な受け入れ基準 |
|---|---|---|
| AudioSep-Hive | 自然言語のターゲット | 出力が要求した音と合っているか |
| 固定音楽ステム | 事前定義クラス | クロストークとステレオ保持 |
| 音響イベント検出 | クラスと時間区間 | イベントは特定するが、きれいな波形は返さない |
漠然とした名詞では、モデルは候補のあいだで妥協せざるを得ない。長すぎる記述では、珍しい修飾語が抜け落ちることもある。まず聞こえる音源から始め、抽象的な情景描写ではなく、位置や音域、動作を足していく。
オープンカテゴリの経路は主にモノラル 32 kHz の研究用推論で、検索、クリーンアップ、探索に向いている。固定の 44.1 kHz ステレオ音楽ステムは、依然として別の制作タスクだ。
強く相関した音源、弱いターゲット、強いリバーブは、意味が異なるからといって一意なマスクを持つわけではない。隣接するシーンの音が結果に漏れ込むこともある。
言語クエリそのものが実験変数だ。比較するときは混合音とモデルを固定し、再合成後のターゲット保持、非ターゲットの漏洩、混合音との整合性を監査する必要がある。
モデル名、数値、限界は、各論文・リポジトリ・モデルカードに遡って確認できる。