Modelvalg
AudioSep-Hive: Adskil vilkårlige lyde med en tekstforespørgsel
Lydseparation / tekniske noter
Lydseparation / tekniske noter
LYDSEPARATION / TEKNISK NOTE
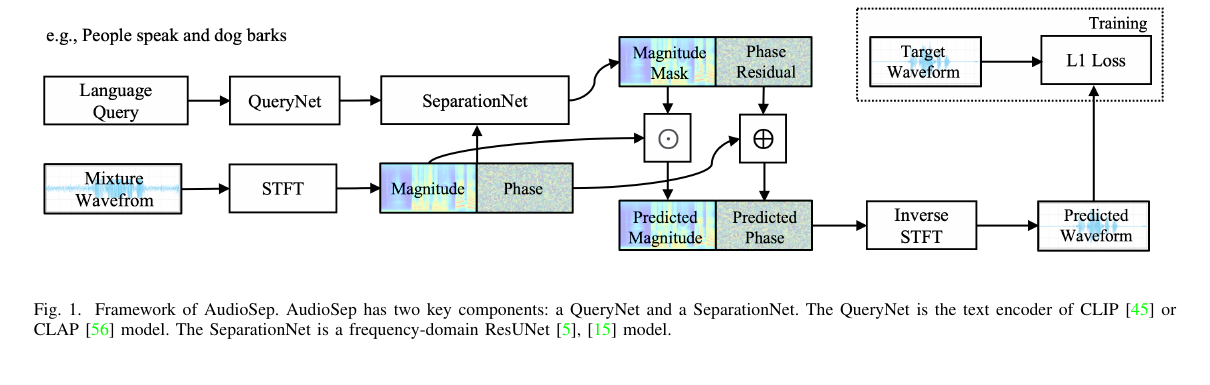
En separator med faste stems afgør svarrummet, før inferensen begynder. AudioSep-Hive læser først en beskrivelse og bruger den til at bestemme, hvilken komponent af miksen der er målet.
For x(t)=s(t)+n(t) giver tekstkoderen q=E_text(c). Separatoren estimerer M=F(X,q) og rekonstruerer Ŝ=M⊙X. En kompakt formulering af målet er:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Det semantiske led får beslægtede beskrivelser til at ligge i et kontinuert forespørgselsrum. Det fjerner ikke tvetydigheden: brede prompter, svage mål og overlappende semantiske beskrivelser er stadig svære tilfælde.
Den udgivne inferenssti er primært 32 kHz mono. Den egner sig til sprogforespurgt udtrækning og forskning i åbne domæner, men den er ikke en erstatning for 44.1 kHz stereostems til produktion. Ændrer man beskrivelsen, ændres konditioneringsvektoren, og målets afgrænsning kan flytte sig.
AudioSep introducerede separation i åbne domæner via forespørgsler på naturligt sprog i 2023. Hive fører linjen videre med semantisk konsistent datakonstruktion og dataeffektiv træning. Artiklen, Hive-arkivet og modelkortet dokumenterer henholdsvis metoden, datasættets implementering og de udgivne vægte.
Traditionelle musikseparatorer definerer vokal, trommer og bas før træningen. AudioSep koblede CLAP-repræsentationer for tekst og lyd til en separator og åbnede for mål som en sirene, en tenorsaxofon eller kvindelig tale. Hive viderefører linjen med større svagt mærket lyd-tekst-dækning for åbne kategorier.
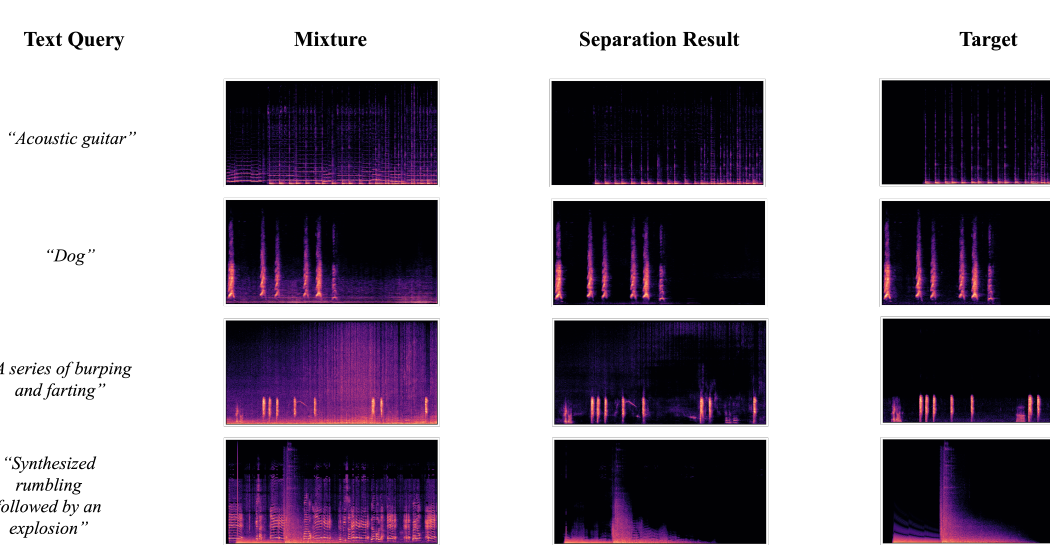
Et åbent ordforråd betyder ikke 283 uafhængige checkpoints. Træningsklasserne giver akustisk og sproglig dækning; det er tekstvektoren, der ændrer sig ved inferens. At gå fra 'dog' til 'small dog barking behind music' flytter konditioneringen, men sprog kan ikke skabe en adskillelbar kildegrænse, som ikke findes i miksen.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT af miksene_qindlejring af tekstforespørgslenMθforespørgselskonditioneret maskeForespørgslen q indlejres som e_q i et fælles lyd-sprog-rum, som konditionerer en maskeestimator. De 283 etiketter beskriver træningsdækningen; de er ikke 283 faste output-stems i én opgave.
Én lyd har mange formuleringer, og negationer eller relationer kan ændre resultatet. Hold lyden fast, omformulér forespørgslen, og undersøg derefter målbevarelse, lækage og miksekonsistens.
Artikel, kode og vægte kan følges via Hive-kilde / AudioSep-Hive-vægte / AudioSep-artikel.
Her sammenlignes inputkontrakter og validering, ikke scores fra inkompatible opgaver.
| Tilgang | Forespørgsel | Primær acceptkontrol |
|---|---|---|
| AudioSep-Hive | mål i naturligt sprog | matcher outputtet den ønskede lyd |
| faste musikstems | foruddefinerede klasser | overhøring og stereobevarelse |
| detektering af lydhændelser | klasse plus tidsforløb | lokaliserer hændelser, men returnerer ikke en ren bølgeform |
Et bredt navneord tvinger modellen til at gå på kompromis mellem kandidaterne; en meget lang beskrivelse kan miste sjældne modifikatorer. Start med den hørbare kilde, og tilføj derefter placering, register eller handling i stedet for en abstrakt scenefortælling.
Den åbne kategorivej er primært forskningsinferens i mono 32 kHz, nyttig til søgning, oprydning og opdagelse. Faste 44.1 kHz stereomusikstems forbliver en anden produktionsopgave.
Stærkt korrelerede kilder, svage mål og kraftig efterklang har ikke en entydig maske, blot fordi deres semantik er forskellig. Lyd fra tilstødende scener kan lække ind i resultatet.
Sprogforespørgslen er selv en eksperimentel variabel. Sammenligninger bør holde miksen og modellen fast, mens målbevarelse, lækage fra ikke-mål og miksekonsistens efter rekombinering granskes.
Modelnavne, tal og begrænsninger kan spores til artiklerne, arkiverne eller modelkortene nedenfor.