Model
AudioSep-Hive: Odvojite proizvoljne zvukove sa tekstualnim upitom
Razdvajanje zvuka / tehničke napomene
Razdvajanje zvuka / tehničke napomene
RAZDVAJANJE ZVUKA / TEHNIČKA NAPOMENA
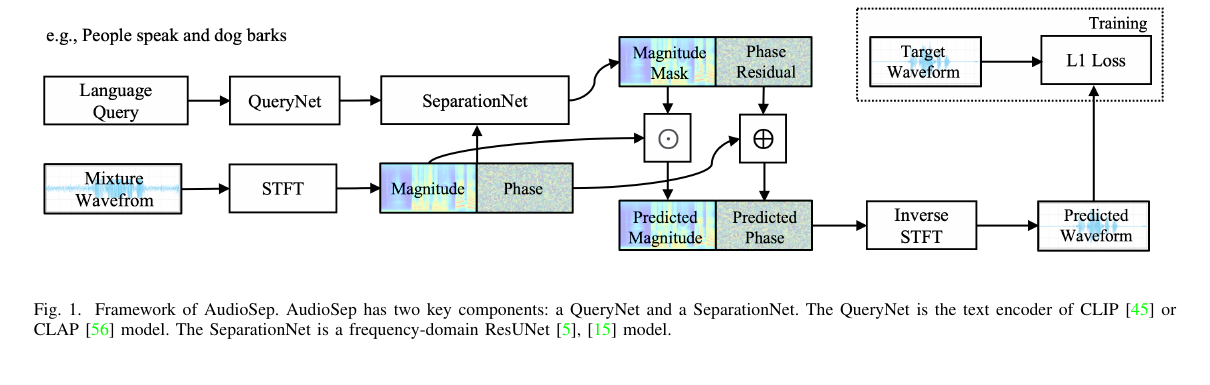
Separator s fiksnim stemovima određuje prostor odgovora prije inferencije. AudioSep-Hive prvo pročita opis i na osnovu njega odlučuje koja je komponenta miksa cilj.
Za x(t)=s(t)+n(t), tekstualni enkoder daje q=E_text(c). Separator procjenjuje M=F(X,q) i rekonstruiše Ŝ=M⊙X. Sažeti prikaz cilja glasi:
L = ||ŝ-s||₁ + λ[1-cos(E_audio(ŝ),q)]
Semantički član tjera srodne opise da zauzimaju kontinuiran prostor upita. To ne uklanja nejednoznačnost: široki upiti, slabi ciljevi i preklapajući semantički opisi ostaju teški slučajevi.
Objavljena inferencijska putanja primarno je 32 kHz mono. Korisna je za ekstrakciju jezičkim upitom i istraživanje otvorene domene, ali nije zamjena za produkcijske stemove u 44.1 kHz stereu. Promjena opisa mijenja vektor uslova i može pomjeriti granicu cilja.
AudioSep je 2023. uveo razdvajanje otvorene domene putem upita na prirodnom jeziku. Hive tu liniju nastavlja kroz semantički dosljednu izgradnju podataka i treniranje efikasno po podacima. Rad, Hive repozitorij i kartica modela redom dokumentiraju metodu, implementaciju skupa podataka i objavljene težine.
Tradicionalni muzički separatori definiraju vokale, bubnjeve i bas prije treniranja. AudioSep je povezao CLAP tekst-audio reprezentacije sa separatorom, dopuštajući ciljeve poput sirene, tenor saksofona ili ženskog govora. Hive tu liniju nastavlja većim slabo označenim audio-tekst pokrićem za otvorene kategorije.
Otvoreni vokabular ne znači 283 nezavisne kontrolne tačke. Klase za treniranje daju akustičko i jezičko pokriće; tekstualni vektor je ono što se mijenja pri inferenciji. Prelazak s 'dog' na 'small dog barking behind music' pomjera uslov, ali jezik ne može stvoriti granicu odvojivog izvora koja ne postoji u miksu.
ŝ_q=iSTFT(Mθ(X,e_q)⊙X)XSTFT miksae_qugrađivanje tekstualnog upitaMθmaska uslovljena upitomUpit q ugrađuje se u zajednički audio-jezički prostor kao e_q, čime uslovljava estimator maske. 283 oznake opisuju pokriće treniranja; to nije 283 fiksnih izlaznih stemova u jednom zadatku.
Jedan zvuk ima mnogo formulacija, a negacija ili odnosi mogu promijeniti rezultat. Držite audio fiksnim, parafrazirajte upit, pa provjerite zadržavanje cilja, propuštanje i konzistentnost miksa.
Rad, kod i težine mogu se pratiti kroz Hive izvor / AudioSep-Hive težine / AudioSep rad.
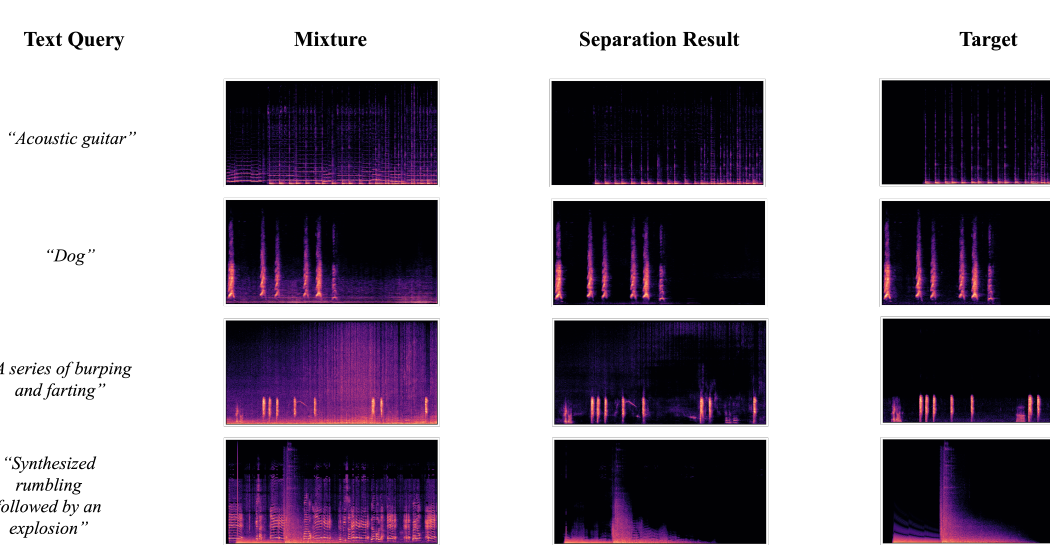
Ovdje se porede ulazni ugovori i validacija, a ne rezultati iz nespojivih zadataka.
| Pravac | Upit | Primarna provjera prihvatljivosti |
|---|---|---|
| AudioSep-Hive | cilj na prirodnom jeziku | odgovara li izlaz traženom zvuku |
| fiksni muzički stemovi | unaprijed definirane klase | prelivanje među stemovima i očuvanje sterea |
| detekcija zvučnih događaja | klasa plus vremenski raspon | lokalizira događaje, ali ne vraća čisti valni oblik |
Široka imenica tjera model na kompromis među kandidatima; vrlo dug opis može izgubiti rijetke modifikatore. Počnite od čujnog izvora, pa dodajte lokaciju, registar ili radnju umjesto apstraktne naracije scene.
Putanja otvorenih kategorija primarno je istraživačka inferencija u mono 32 kHz, korisna za pretragu, čišćenje i otkrivanje. Fiksni muzički stemovi u 44.1 kHz stereu ostaju drugačiji produkcijski zadatak.
Visoko korelirani izvori, slabi ciljevi i jaka odjeka nemaju jedinstvenu masku samo zato što im se semantika razlikuje. Susjedni zvuk scene može procuriti u rezultat.
Jezički upit sam je eksperimentalna varijabla. U poređenjima treba držati miks i model fiksnima dok se provjeravaju zadržavanje cilja, propuštanje ne-ciljanog materijala i konzistentnost miksa nakon ponovnog spajanja.
Nazivi modela, brojke i ograničenja vode do radova, repozitorija ili kartica modela navedenih dolje.