模型
LongCat-AudioDiT 3.5B:把說話人條件寫進音訊擴散 Transformer
論文精讀 / 零樣本語音克隆

論文精讀 / 零樣本語音克隆
論文研讀 / 零樣本聲音複製
LongCat-AudioDiT 3.5B 鎖定文字轉語音與零樣本複製。目標文字、說話人參考音訊與韻律線索,在一個生成聲學潛在表示的擴散 Transformer 內交會。官方公布的相似度數字,回答的問題比自然度、詞錯誤率或多語口音都來得窄。
前向過程把乾淨的聲學潛在表示 x₀ 逐步污染成 x_t。網路以文字與說話人資訊 c 為條件,預測噪聲或速度:
L=E ||ε−εθ(x_t,t,c)||²
釋出的品質路徑使用 32 次函數評估。無條件合成採用 CFG;以參考音訊為條件的複製則沿用專案的 APG 方法,減輕強引導下的音色過飽和。
許多零樣本系統逐一產生離散的聲學單元。LongCat 改用擴散 Transformer 還原連續的聲學軌跡:UMT5 提供文字特徵,參考音訊提供身分與韻律。誤差累積的位置也隨之轉移,從 token 順序搬到迭代去噪與引導上。
官方 Seed 表格列出三個說話人相似度分組,3.5B 的數值平均約 80.0。這幾列只能在所指表格內互相比較,無法取代 MOS、詞錯誤率、跨語言口音或長篇一致性。一把聲音可以聽起來很像,卻同時把人名唸錯。
好用的提示音訊要短、乾淨、只有單一說話人。多人說話、音樂與強殘響會把環境混入身分。聲音相似度是合成屬性,既非身分驗證訊號,也不構成模仿某人的許可。
零樣本複製長期以來多靠自回歸的離散音訊 token:模型逐一預測聲學單元,參考音訊則提供說話人條件。LongCat-AudioDiT 3.5B 改以擴散 Transformer 還原連續聲學潛在表示,文字交給 UMT5,音色與韻律交給參考音訊。
好處與代價同樣來自全域去噪。句子的結構可以在整條軌跡上被修改,但 32 次函數評估也推高延遲。APG 與 CFG 還會改變音色飽和度、發音穩定性以及被複製進來的背景噪聲,兩者的影響超過單一引導數字所能概括。

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_t第 t 步的聲學潛在表示c_text文字條件c_spk來自參考音訊的說話人條件這組通用的條件擴散記號呈現文字與說話人條件一同進入去噪器,並非逐行對應儲存庫中的公式。32 次函數評估反覆更新潛在表示。
說話人相似度與內容正確性分屬兩條軸。帶噪聲的提示音訊可能把房間聲響變成聲音條件,而高相似度並不保證人名、數字或停頓正確。
論文、程式碼與權重可循 LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights 取得。
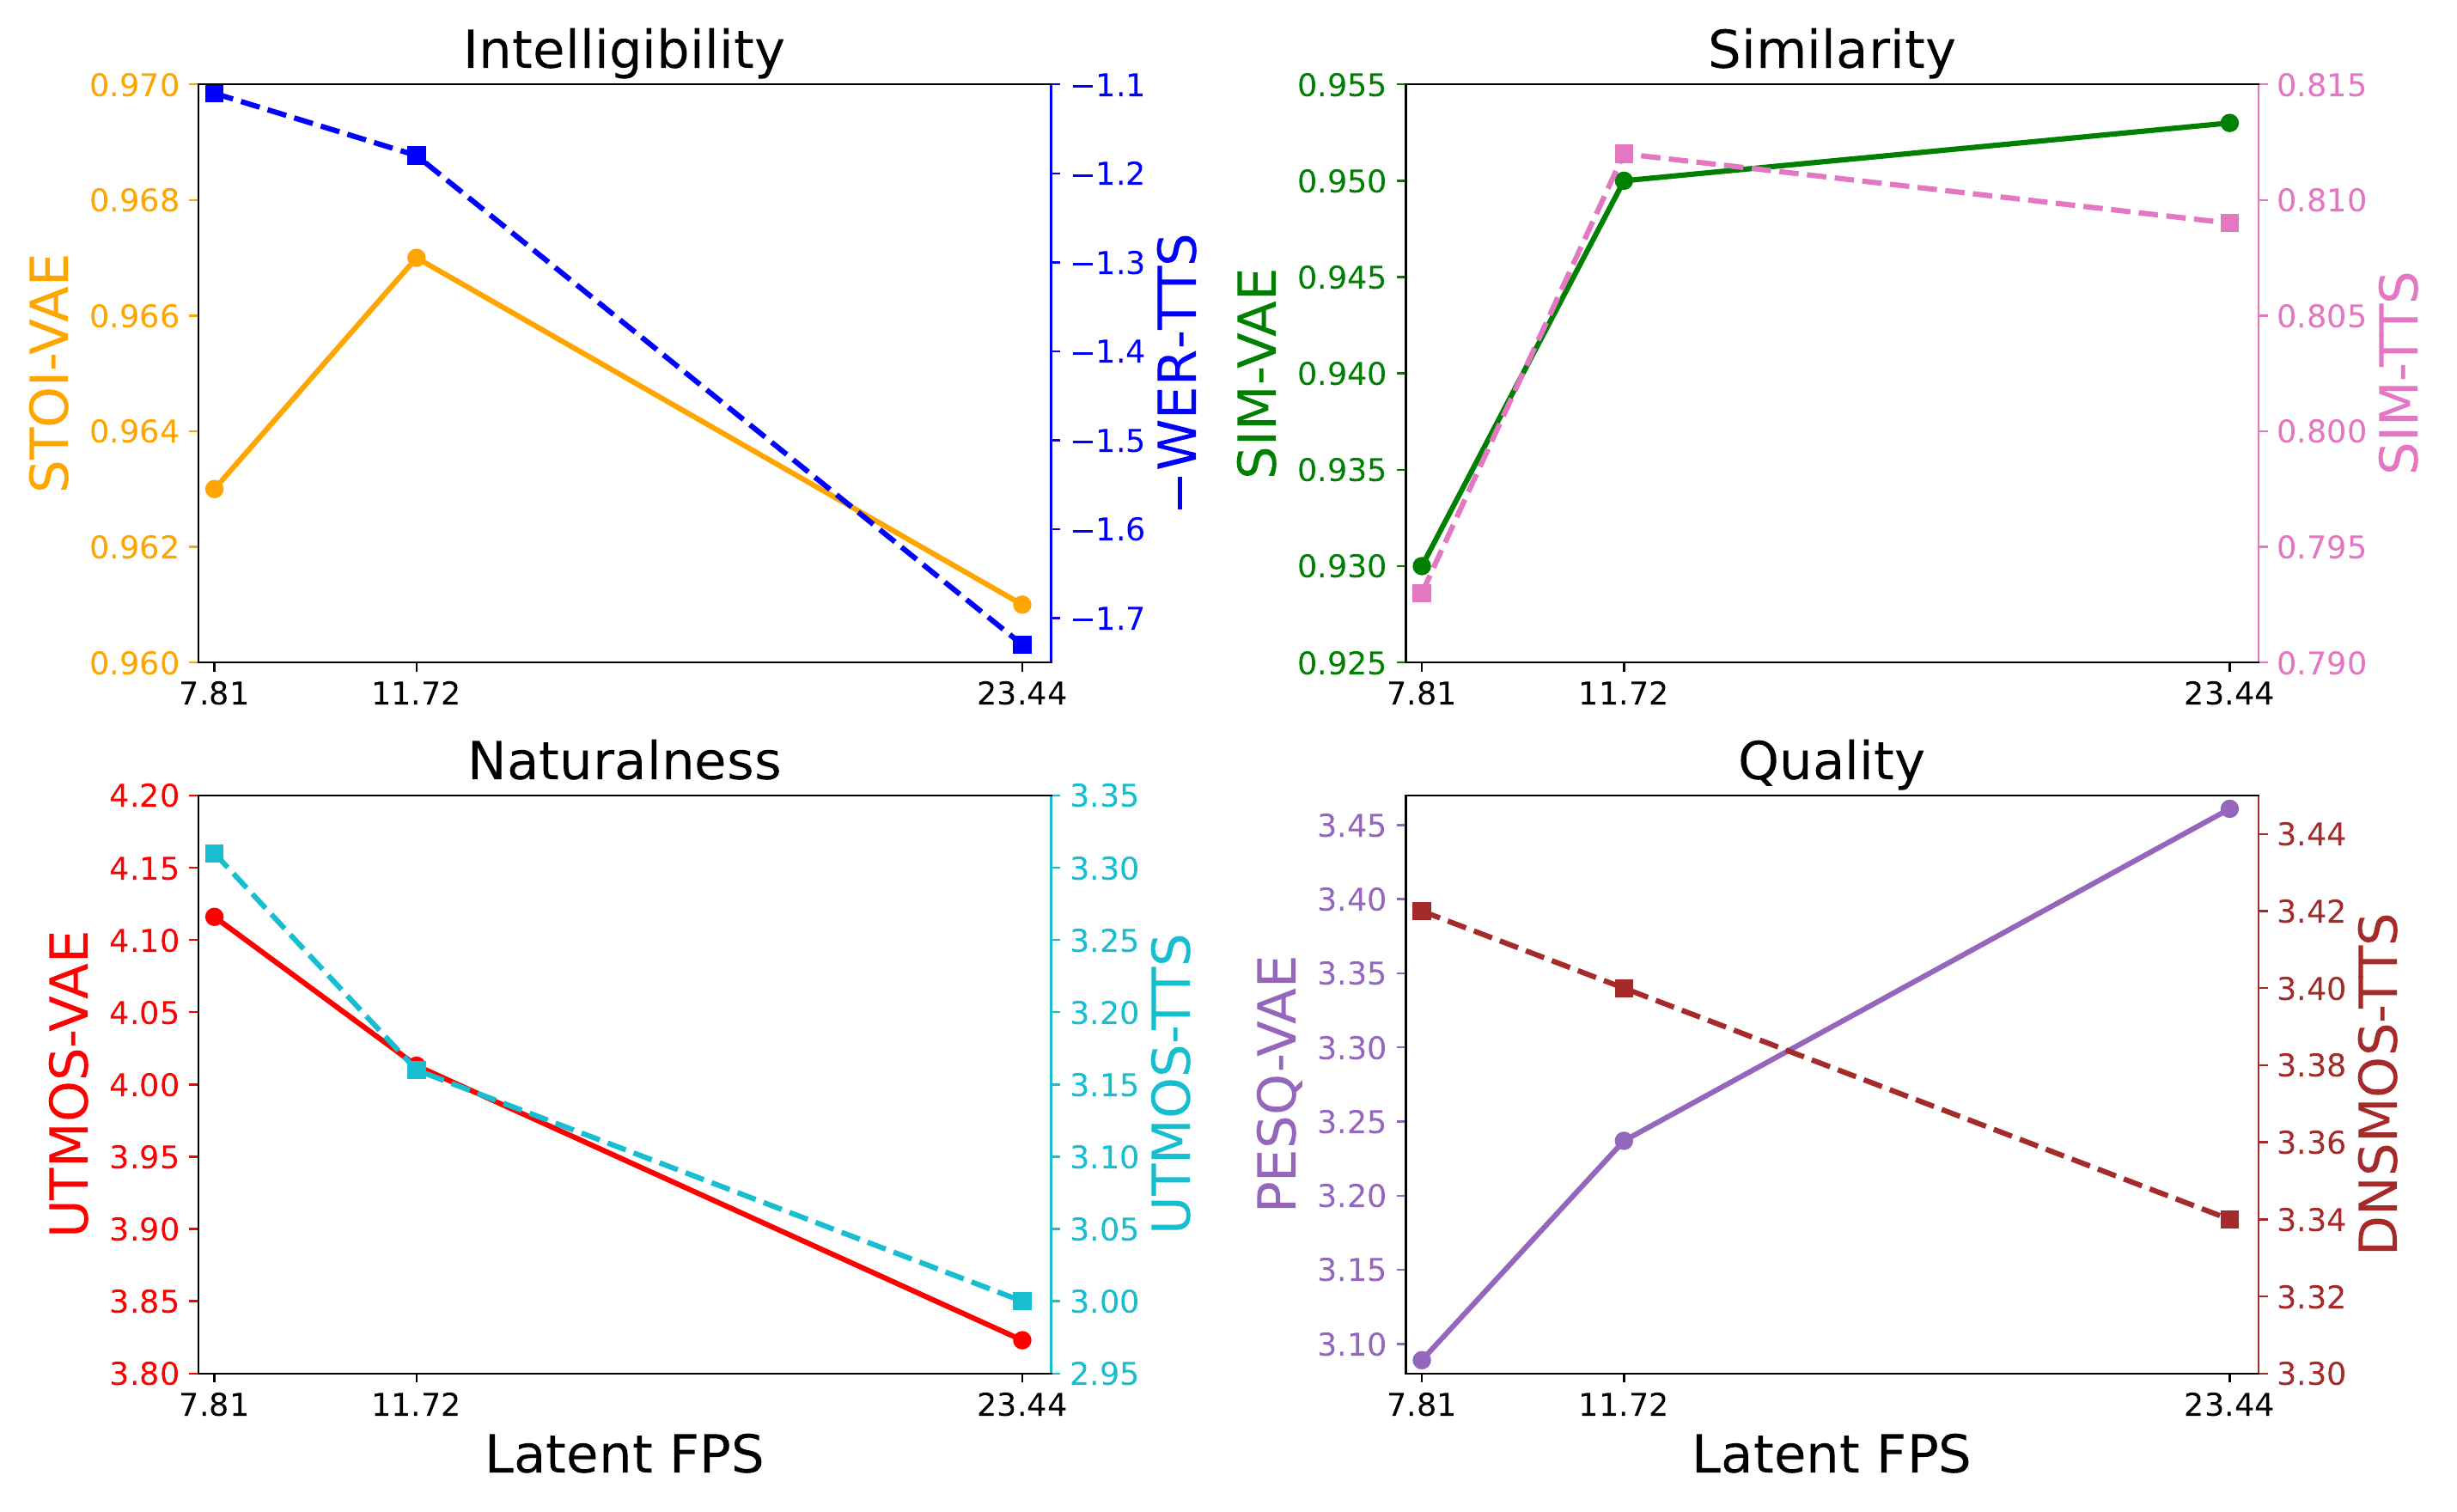
官方 ZH、EN 與 ZH-Hard 三個 SIM 欄在此取平均,僅保留資料完整的列。自然度與 WER 仍屬另一組問題。
| 模型 | 三分組平均 SIM | 仍待查驗 |
|---|---|---|
| LongCat-AudioDiT 3.5B | 約 80.0 | WER、自然度與延遲 |
| Qwen3-TTS | 約 74.5 | 聲音設計對比複製 |
| VoxCPM | 約 74.4 | 長篇連貫性與 RTF |
同一句子要同時保留無參考與參考條件兩種輸出。先核對人名、數字與停頓,再檢查音色、口音與韻律。只聽像不像,容易漏掉缺字或被複製進來的噪聲。
好用的參考音訊要短、乾淨、單一說話人。多重人聲、強殘響與音樂會把身分與環境混在一起;同一段文字重複取樣,才能看出相似度、韻律與發音的變異。
說話人相似度量測的是嵌入向量的接近程度,既不能證明身分,也不授予使用他人聲音的權利。這類工具只適用於使用者有權處理的參考素材。
公開儲存庫與 3.5B 模型卡共同界定了已釋出的材料。相似度數字始終綁定所指名的測試集,無法取代對多語發音、長篇穩定性與主觀自然度的獨立檢驗。
模型名稱、數字與限制均可追溯至下列論文、儲存庫或模型卡。