Model
LongCat-AudioDiT 3.5B: Upišite uslove zvučnika u audio difuzioni transformator
Intenzivno čitanje rada / Kloniranje glasa bez uzorka

Intenzivno čitanje rada / Kloniranje glasa bez uzorka
ČITANJE RADA / ZERO-SHOT KLONIRANJE GLASA
LongCat-AudioDiT 3.5B namijenjen je pretvaranju teksta u govor i zero-shot kloniranju glasa. Ciljni tekst, referenca govornika i prozodijske naznake susreću se unutar difuzijskog transformera koji generiše akustičke latente. Njegovi objavljeni brojevi sličnosti odgovaraju na uže pitanje od prirodnosti, grešaka u riječima ili višejezičnog naglaska.
Proces unaprijed kvari čisti akustički latent x₀ i pretvara ga u x_t. Uvjetovana tekstom i informacijom o govorniku c, mreža predviđa šum ili brzinu:
L=E ||ε−εθ(x_t,t,c)||²
Objavljena kvalitetna putanja koristi 32 evaluacije funkcije. Sinteza bez uvjetovanja koristi CFG, dok kloniranje na osnovu reference prati APG metodu projekta kako bi se smanjilo prezasićenje pri snažnom usmjeravanju.
Mnogi zero-shot sistemi generišu diskretne akustičke jedinice jednu po jednu. LongCat umjesto toga obnavlja kontinuiranu akustičku putanju difuzijskim transformerom, dok UMT5 daje tekstualna obilježja, a referenca identitet i prozodiju. Ta promjena prebacuje nakupljanje grešaka s redoslijeda tokena na iterativno uklanjanje šuma i usmjeravanje.
Zvanična Seed tabela navodi tri podjele sličnosti govornika čije vrijednosti za 3.5B u prosjeku iznose oko 80.0. Ti se redovi mogu porediti samo unutar navedene tabele; ne zamjenjuju MOS, greške u riječima, međujezični naglasak ni dosljednost u dugim snimcima. Glas može zvučati slično, a ipak pogrešno pročitati ime.
Koristan glasovni uzorak kratak je, čist i s jednim govornikom. Više govornika, muzika i snažan odjek miješaju okruženje s identitetom. Sličnost glasa svojstvo je sinteze, a ne signal za provjeru identiteta niti dozvola za imitiranje druge osobe.
Zero-shot kloniranje često se oslanjalo na autoregresivne diskretne audio tokene: model predviđa akustičke jedinice jednu po jednu, dok referenca daje uvjetovanje govornika. LongCat-AudioDiT 3.5B umjesto toga difuzijskim transformerom obnavlja kontinuirani akustički latent, koristeći UMT5 za tekst, a referencu za boju glasa i prozodiju.
I korist i cijena proizlaze iz globalnog uklanjanja šuma. Struktura rečenice može se revidirati duž cijele putanje, ali 32 evaluacije funkcije povećavaju kašnjenje. APG i CFG također mijenjaju zasićenje boje glasa, stabilnost izgovora i kopirani pozadinski šum; oni su više od jednog broja usmjeravanja.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_takustički latent u koraku tc_texttekstualni uvjetc_spkuvjet govornika iz referenceOva generička notacija uvjetne difuzije pokazuje da tekstualni i govornički uvjet ulaze zajedno u model za uklanjanje šuma; nije predstavljena kao jednadžba iz repozitorija red po red. Trideset dvije evaluacije funkcije uzastopno ažuriraju latent.
Sličnost govornika i ispravnost sadržaja dvije su odvojene osi. Zašumljeni uzorak može zvuk prostorije pretvoriti u glasovni uvjet, a visoka sličnost ne dokazuje tačna imena, brojeve ni pauze.
Rad, kod i težine mogu se pratiti putem LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
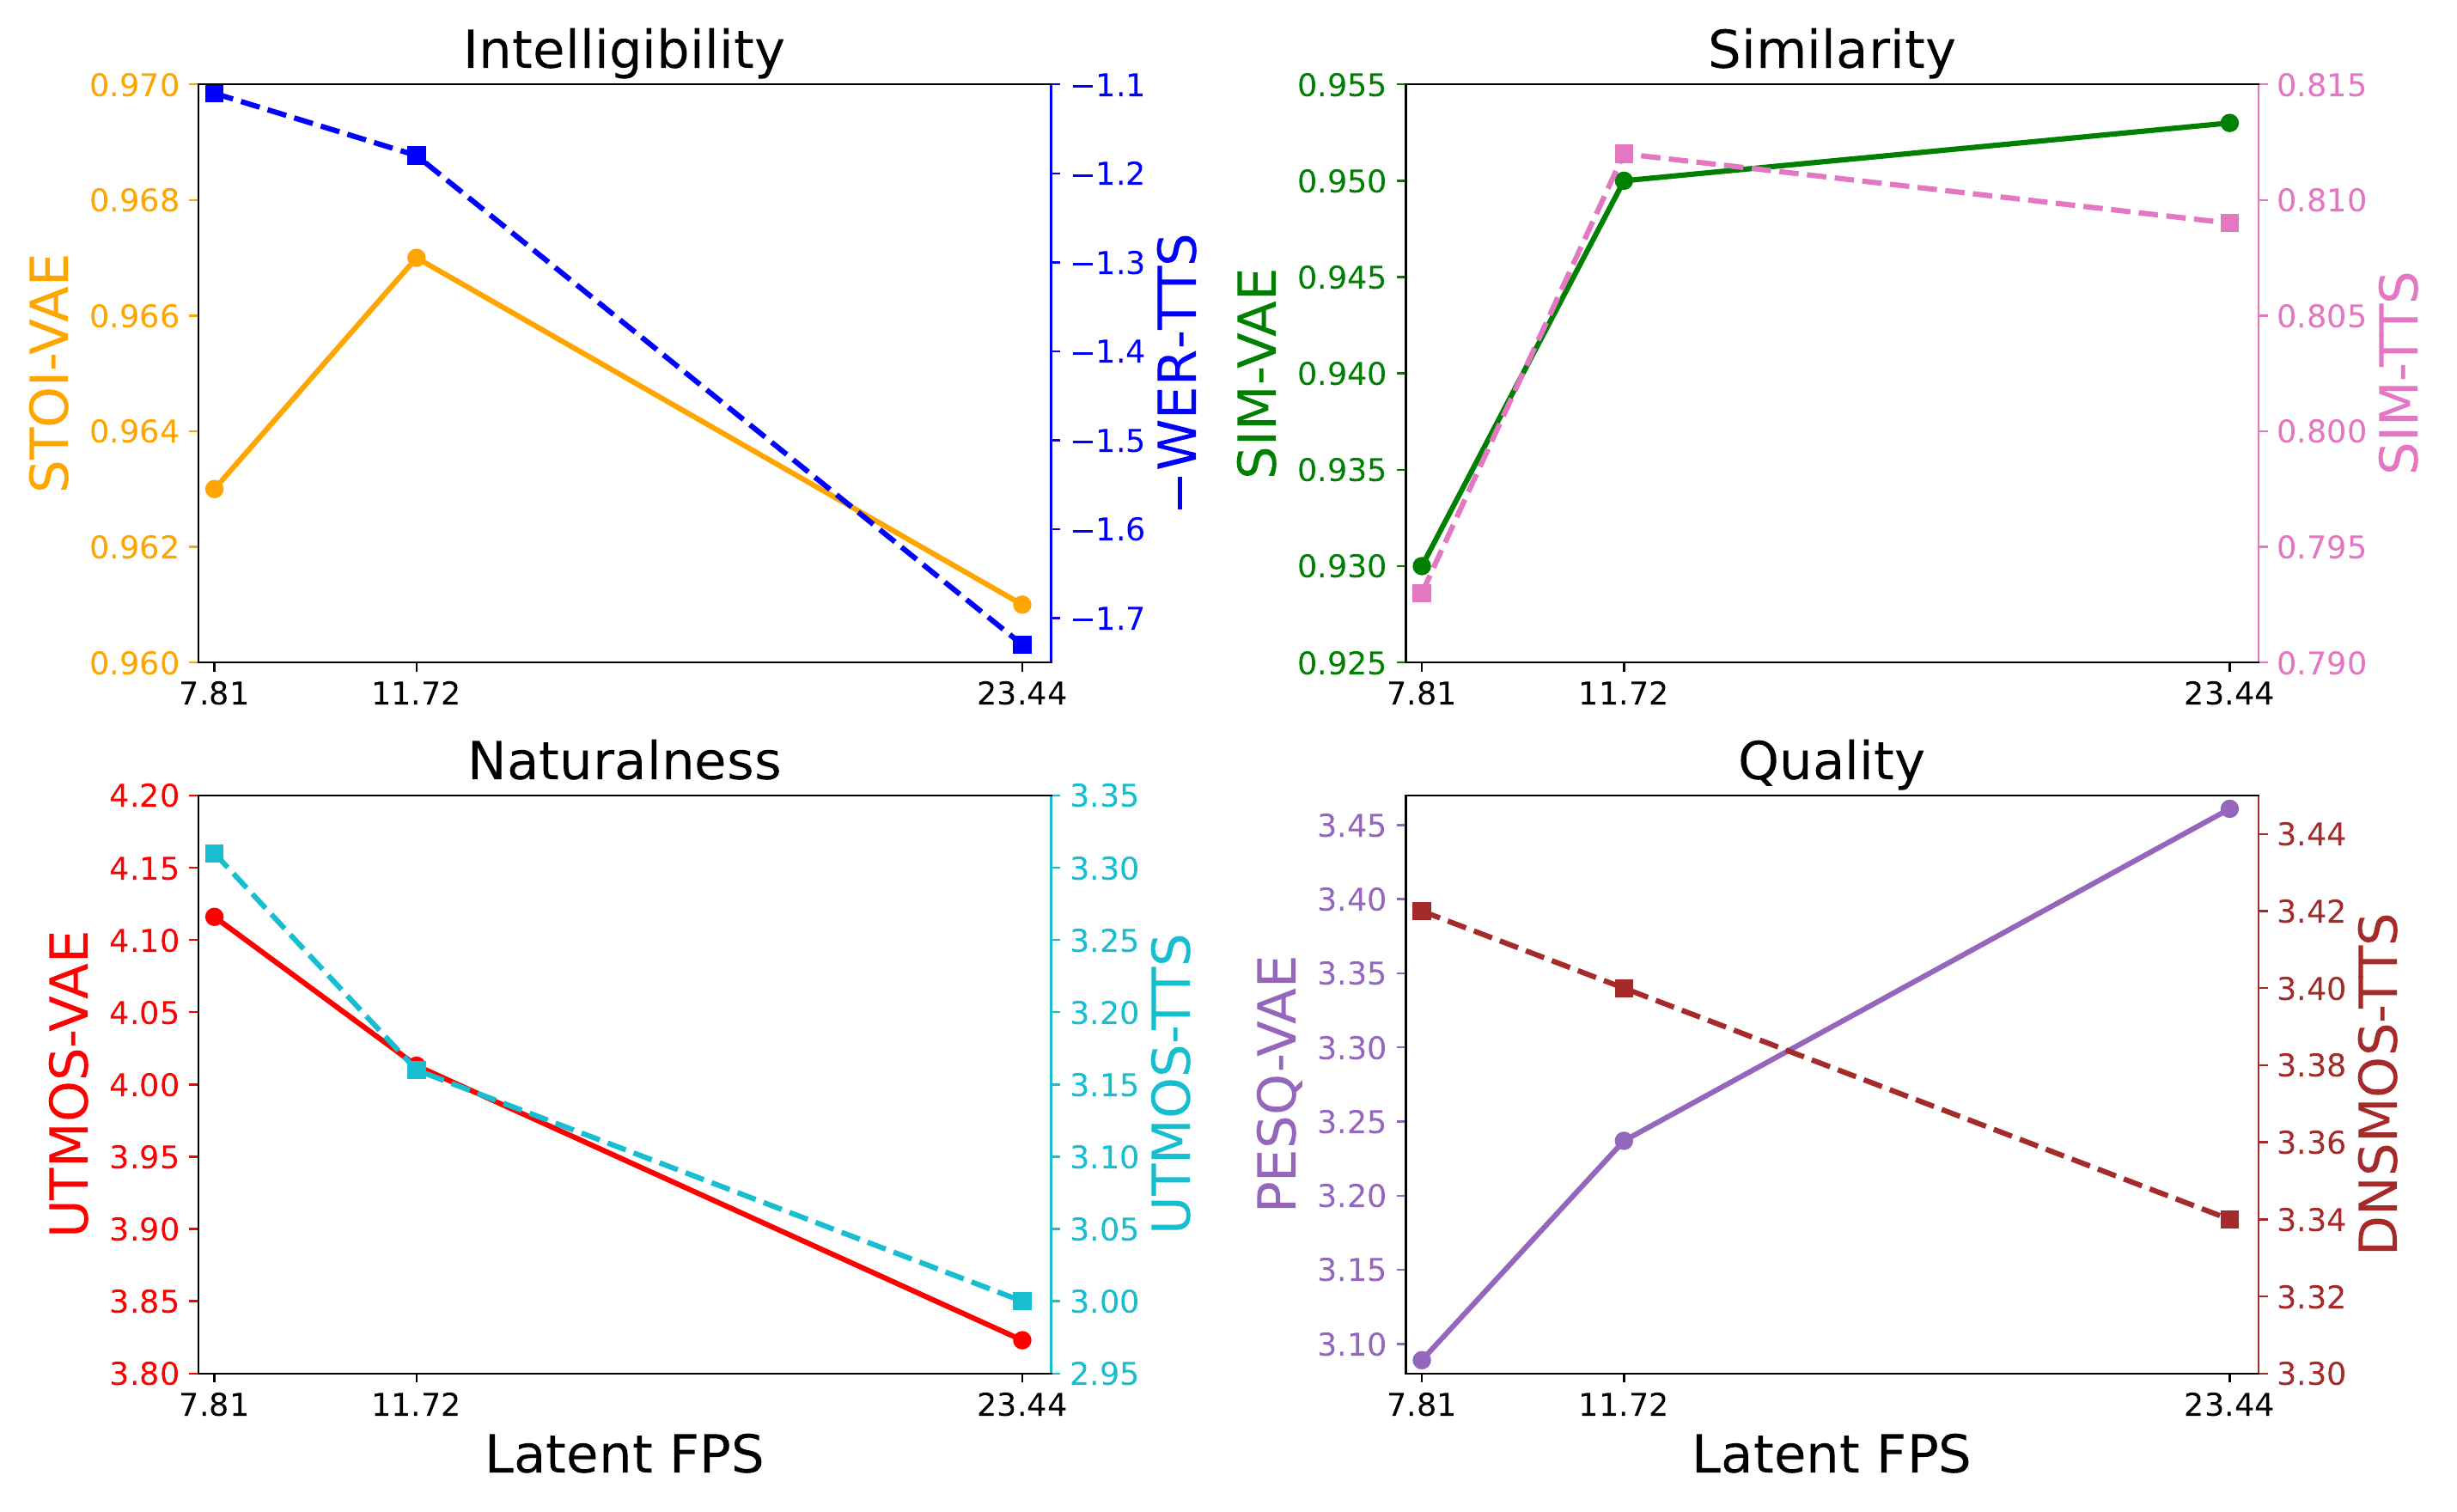
Stranica uzima prosjek zvaničnih kolona ZH, EN i ZH-Hard SIM i uključuje samo potpune redove. Prirodnost i WER ostaju odvojena pitanja.
| Model | Prosjek SIM za tri podjele | Ostaje provjeriti |
|---|---|---|
| LongCat-AudioDiT 3.5B | oko 80.0 | WER, prirodnost i kašnjenje |
| Qwen3-TTS | oko 74.5 | dizajn glasa naspram kloniranja |
| VoxCPM | oko 74.4 | koherentnost dugih snimaka i RTF |
Zadržite izlaz bez reference i izlaz uvjetovan referencom za istu rečenicu. Imena, brojeve i pauze provjerite prije boje glasa, naglaska i prozodije. Slušanje samo na sličnost može sakriti izostavljene riječi ili kopirani šum.
Korisna referenca kratka je, čista i s jednim govornikom. Više glasova, snažan odjek i muzika stapaju identitet s okruženjem; ponovljeni uzorci istog teksta otkrivaju varijabilnost u sličnosti, prozodiji i izgovoru.
Sličnost govornika mjeri bliskost embedding vektora. Ona ni dokazuje identitet ni daje dozvolu za korištenje nečijeg glasa. Alat je namijenjen referentnom materijalu koji korisnik ima pravo obrađivati.
Javni repozitorij i kartica modela 3.5B zajedno utvrđuju objavljene materijale. Brojevi sličnosti ostaju vezani za svoje imenovane testne skupove i ne zamjenjuju zasebne provjere višejezičnog izgovora, stabilnosti u dugim snimcima i percipirane prirodnosti.
Nazivi modela, brojevi i ograničenja potječu od radova, repozitorija ili kartica modela navedenih u nastavku.