โมเดล
LongCat-AudioDiT 3.5B: เขียนเงื่อนไขของลำโพงลงในหม้อแปลงกระจายเสียง
การอ่านบทความอย่างเข้มข้น / การโคลนเสียงแบบไม่มีตัวอย่าง

การอ่านบทความอย่างเข้มข้น / การโคลนเสียงแบบไม่มีตัวอย่าง
© 2026 TelkNet สงวนลิขสิทธิ์.
อ่านเปเปอร์ / โคลนเสียงแบบ ZERO-SHOT
LongCat-AudioDiT 3.5B มุ่งทำ text-to-speech และการโคลนเสียงแบบ zero-shot ข้อความเป้าหมาย เสียงอ้างอิงของผู้พูด และคิวด้านจังหวะสำเนียงมาบรรจบกันใน diffusion transformer ที่สร้าง acoustic latent ออกมา ตัวเลขความคล้ายเสียงที่ตีพิมพ์ตอบคำถามได้แคบกว่าเรื่องความเป็นธรรมชาติ อัตราคำผิด หรือสำเนียงข้ามภาษา
กระบวนการไปข้างหน้าค่อยๆ ทำลาย acoustic latent ที่สะอาด x₀ ให้กลายเป็น x_t เมื่อป้อนเงื่อนไขจากข้อความและข้อมูลผู้พูด c เน็ตเวิร์กจะทำนายสัญญาณรบกวนหรือความเร็ว:
L=E ||ε−εθ(x_t,t,c)||²
เส้นทางคุณภาพที่ปล่อยออกมาใช้การประเมินฟังก์ชัน 32 ครั้ง การสังเคราะห์แบบไร้เงื่อนไขใช้ CFG ส่วนการโคลนจากเสียงอ้างอิงใช้วิธี APG ของโปรเจกต์เพื่อลดความอิ่มตัวเกินเมื่อ guidance แรง
ระบบ zero-shot จำนวนมากสร้างหน่วยเสียงแบบไม่ต่อเนื่องทีละหน่วย LongCat เลือกฟื้นคืนวิถีเสียงแบบต่อเนื่องด้วย diffusion transformer แทน โดย UMT5 ให้ฟีเจอร์ข้อความ และเสียงอ้างอิงให้ทั้งตัวตนและจังหวะสำเนียง การเปลี่ยนแปลงนี้ย้ายการสะสมของความผิดพลาดจากลำดับ token ไปอยู่ที่การกรองสัญญาณรบกวนแบบวนซ้ำและ guidance
ตาราง Seed ทางการรายงานคะแนนความคล้ายผู้พูดสามชุด ซึ่งค่าของ 3.5B เฉลี่ยราว 80.0 แถวเหล่านั้นเปรียบเทียบได้เฉพาะภายในตารางที่ระบุชื่อ ไม่ได้มาแทนที่ MOS อัตราคำผิด สำเนียงข้ามภาษา หรือความสม่ำเสมอของชิ้นงานยาว เสียงหนึ่งอาจฟังคล้ายต้นฉบับแต่อ่านชื่อผิด
เสียงตัวอย่างที่ใช้ได้จริงควรสั้น สะอาด และมีผู้พูดคนเดียว หลายผู้พูด ดนตรี และเสียงก้องแรงจะผสมสภาพแวดล้อมเข้ากับตัวตน ความคล้ายของเสียงเป็นคุณสมบัติของการสังเคราะห์ ไม่ใช่สัญญาณยืนยันตัวตน และไม่ใช่ใบอนุญาตให้สวมรอยเป็นบุคคลอื่น
การโคลนเสียงแบบ zero-shot มักใช้ discrete audio token แบบ autoregressive: โมเดลทำนายหน่วยเสียงทีละหน่วยขณะที่เสียงอ้างอิงป้อนเงื่อนไขผู้พูด LongCat-AudioDiT 3.5B เลือกฟื้นคืน acoustic latent แบบต่อเนื่องด้วย diffusion transformer แทน โดยใช้ UMT5 กับข้อความ และใช้เสียงอ้างอิงกับเนื้อเสียงและจังหวะสำเนียง
ทั้งข้อดีและต้นทุนมาจากการกรองสัญญาณรบกวนระดับภาพรวม โครงประโยคแก้ได้ตลอดวิถี แต่การประเมินฟังก์ชัน 32 ครั้งเพิ่มเวลาแฝง APG และ CFG ยังเปลี่ยนความอิ่มของเนื้อเสียง ความมั่นคงของการออกเสียง และเสียงพื้นหลังที่ถูกคัดลอกมาด้วย ทั้งคู่มีความหมายมากกว่าตัวเลข guidance ตัวเดียว

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tacoustic latent ณ ขั้นตอน tc_textเงื่อนไขข้อความc_spkเงื่อนไขผู้พูดจากเสียงอ้างอิงสัญกรณ์ conditional-diffusion ทั่วไปนี้แสดงให้เห็นเงื่อนไขข้อความและผู้พูดเข้าสู่ตัวกรองสัญญาณรบกวนพร้อมกัน ไม่ได้นำเสนอเป็นสมการจากรีโพแบบบรรทัดต่อบรรทัด การประเมินฟังก์ชัน 32 ครั้งค่อยๆ อัปเดต latent ซ้ำแล้วซ้ำเล่า
ความคล้ายของเสียงผู้พูดกับความถูกต้องของเนื้อหาอยู่คนละแกน เสียงตัวอย่างที่มีสัญญาณรบกวนอาจเปลี่ยนเสียงห้องให้กลายเป็นเงื่อนไขเสียงพูด และความคล้ายสูงไม่ได้พิสูจน์ว่าชื่อ ตัวเลข หรือจังหวะหยุดถูกต้อง
ติดตามเปเปอร์ โค้ด และน้ำหนักได้ผ่าน LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights
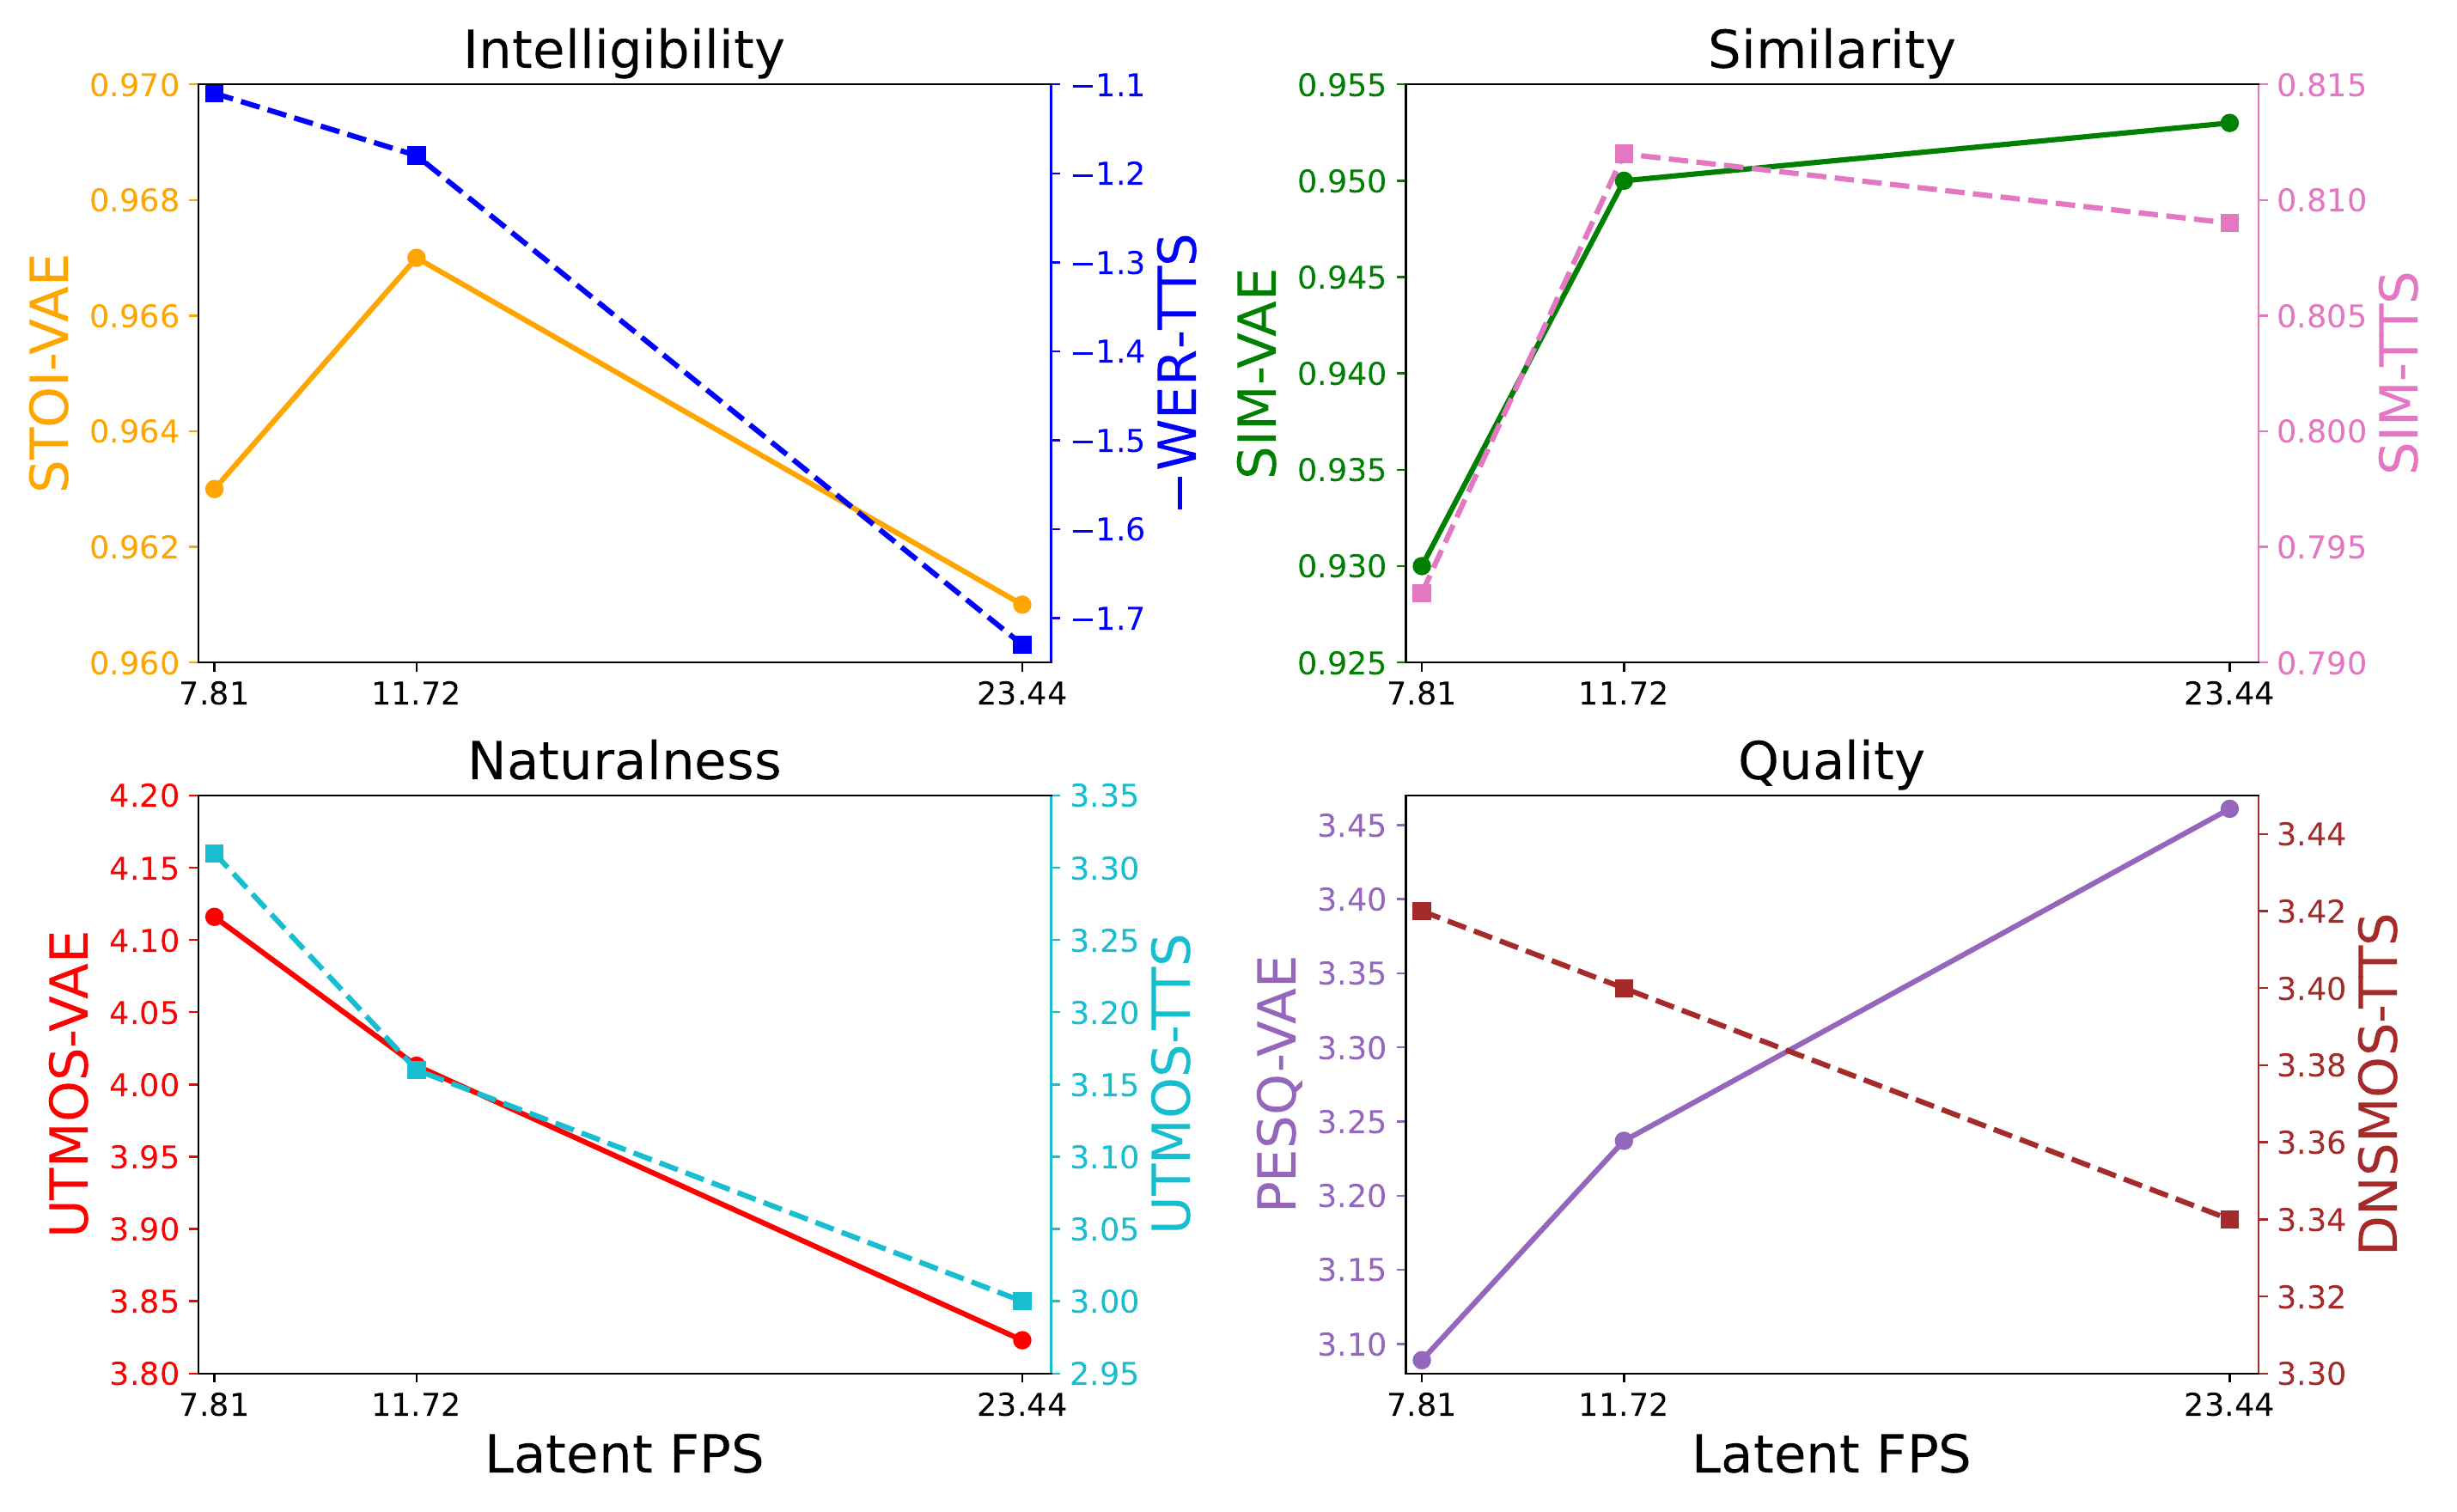
หน้านี้หาค่าเฉลี่ยของคอลัมน์ SIM ทางการสามชุด ได้แก่ ZH, EN และ ZH-Hard และรวมเฉพาะแถวที่ครบถ้วน ความเป็นธรรมชาติและ WER ยังเป็นอีกเรื่องหนึ่ง
| โมเดล | ค่าเฉลี่ย SIM สามชุด | ยังต้องตรวจ |
|---|---|---|
| LongCat-AudioDiT 3.5B | ราว 80.0 | WER ความเป็นธรรมชาติ และเวลาแฝง |
| Qwen3-TTS | ราว 74.5 | การออกแบบเสียงเทียบการโคลน |
| VoxCPM | ราว 74.4 | ความเชื่อมโยงชิ้นงานยาวและ RTF |
เก็บทั้งผลลัพธ์แบบไร้เสียงอ้างอิงและแบบมีเงื่อนไขจากเสียงอ้างอิงของประโยคเดียวกันไว้ ตรวจชื่อ ตัวเลข และจังหวะหยุดก่อนเนื้อเสียง สำเนียง และจังหวะพูด ฟังเพื่อหาความคล้ายอย่างเดียวอาจทำให้มองข้ามคำที่หายหรือเสียงรบกวนที่ถูกคัดลอกมา
เสียงอ้างอิงที่ใช้ได้จริงควรสั้น สะอาด และมีผู้พูดคนเดียว เสียงหลายคน เสียงก้องแรง และดนตรีผสมตัวตนเข้ากับสภาพแวดล้อม การสุ่มตัวอย่างข้อความเดิมซ้ำๆ จะเผยความแปรปรวนของความคล้าย จังหวะพูด และการออกเสียง
ความคล้ายของเสียงผู้พูดวัดความใกล้ของ embedding ไม่ได้พิสูจน์ตัวตนและไม่ได้ให้สิทธิ์ใช้เสียงของใคร เครื่องมือนี้มีไว้สำหรับวัสดุอ้างอิงที่ผู้ใช้มีสิทธิ์ประมวลผล
รีโพสาธารณะและ model card ของ 3.5B ร่วมกันยืนยันวัสดุที่ปล่อยออกมา ตัวเลขความคล้ายยังผูกอยู่กับชุดทดสอบที่ระบุชื่อ และไม่ได้แทนที่การตรวจแยกเรื่องการออกเสียงหลายภาษา ความมั่นคงของชิ้นงานยาว และความเป็นธรรมชาติที่รับรู้
ชื่อโมเดล ตัวเลข และข้อจำกัดทั้งหมดอ้างอิงถึงเปเปอร์ รีโพ หรือ model card ด้านล่าง