Modello
LongCat-AudioDiT 3.5B: scrive le condizioni degli altoparlanti nel trasformatore di diffusione audio
Lettura intensiva dell'articolo / Clonazione vocale a campione zero

Lettura intensiva dell'articolo / Clonazione vocale a campione zero
© 2026 TelkNet. Tutti i diritti riservati.
LETTURA DEL PAPER / CLONAZIONE VOCALE ZERO-SHOT
LongCat-AudioDiT 3.5B punta alla sintesi vocale da testo e alla clonazione zero-shot. Il testo di destinazione, un riferimento del parlante e gli indizi prosodici si incontrano dentro un transformer di diffusione che genera latenti acustici. I numeri di similarità pubblicati rispondono a una domanda più ristretta rispetto a naturalezza, tasso di errore sulle parole o accento multilingue.
Un processo in avanti corrompe un latente acustico pulito x₀ in x_t. Condizionata sul testo e sulle informazioni del parlante c, la rete predice il rumore o la velocità:
L=E ||ε−εθ(x_t,t,c)||²
Il percorso di qualità rilasciato impiega 32 valutazioni di funzione. La sintesi non condizionata usa CFG, mentre la clonazione con riferimento segue il metodo APG del progetto per ridurre la sovrasaturazione sotto guida forte.
Molti sistemi zero-shot generano unità acustiche discrete una alla volta. LongCat ricostruisce invece una traiettoria acustica continua con un transformer di diffusione, mentre UMT5 fornisce le rappresentazioni del testo e il riferimento apporta identità e prosodia. Il cambiamento sposta l'accumulo degli errori dall'ordine dei token verso la riduzione iterativa del rumore e la guida.
La tabella ufficiale Seed riporta tre suddivisioni di similarità del parlante i cui valori del 3.5B hanno in media circa 80.0. Quelle righe sono confrontabili solo all'interno della tabella citata; non sostituiscono MOS, tasso di errore sulle parole, accento tra lingue diverse o coerenza sui contenuti lunghi. Una voce può suonare simile e comunque leggere male un nome.
Un riferimento utile è breve, pulito e con un solo parlante. Più voci, musica e un riverbero marcato mescolano l'ambiente con l'identità. La similarità vocale è una proprietà della sintesi, non un segnale di verifica dell'identità né un permesso di impersonare qualcuno.
La clonazione zero-shot si è spesso affidata a token audio discreti autoregressivi: un modello predice le unità acustiche una alla volta mentre un riferimento fornisce il condizionamento del parlante. LongCat-AudioDiT 3.5B ricostruisce invece un latente acustico continuo con un transformer di diffusione, usando UMT5 per il testo e il riferimento per timbro e prosodia.
Vantaggio e costo derivano entrambi dalla riduzione globale del rumore. La struttura della frase può essere rivista lungo tutta la traiettoria, ma 32 valutazioni di funzione aumentano la latenza. APG e CFG modificano inoltre la saturazione del timbro, la stabilità della pronuncia e il rumore di fondo copiato: sono molto più di un singolo numero di guida.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatente acustico al passo tc_textcondizione del testoc_spkcondizione del parlante ricavata dal riferimentoQuesta notazione generica della diffusione condizionale mostra le condizioni di testo e parlante entrare insieme nel denoiser; non va letta come un'equazione riga per riga del repository. Trentadue valutazioni di funzione aggiornano ripetutamente il latente.
Similarità del parlante e correttezza del contenuto sono assi distinti. Un riferimento rumoroso può trasformare il suono della stanza in una condizione vocale, e una similarità elevata non dimostra nomi, numeri o pause corretti.
Il paper, il codice e i pesi si possono seguire attraverso LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
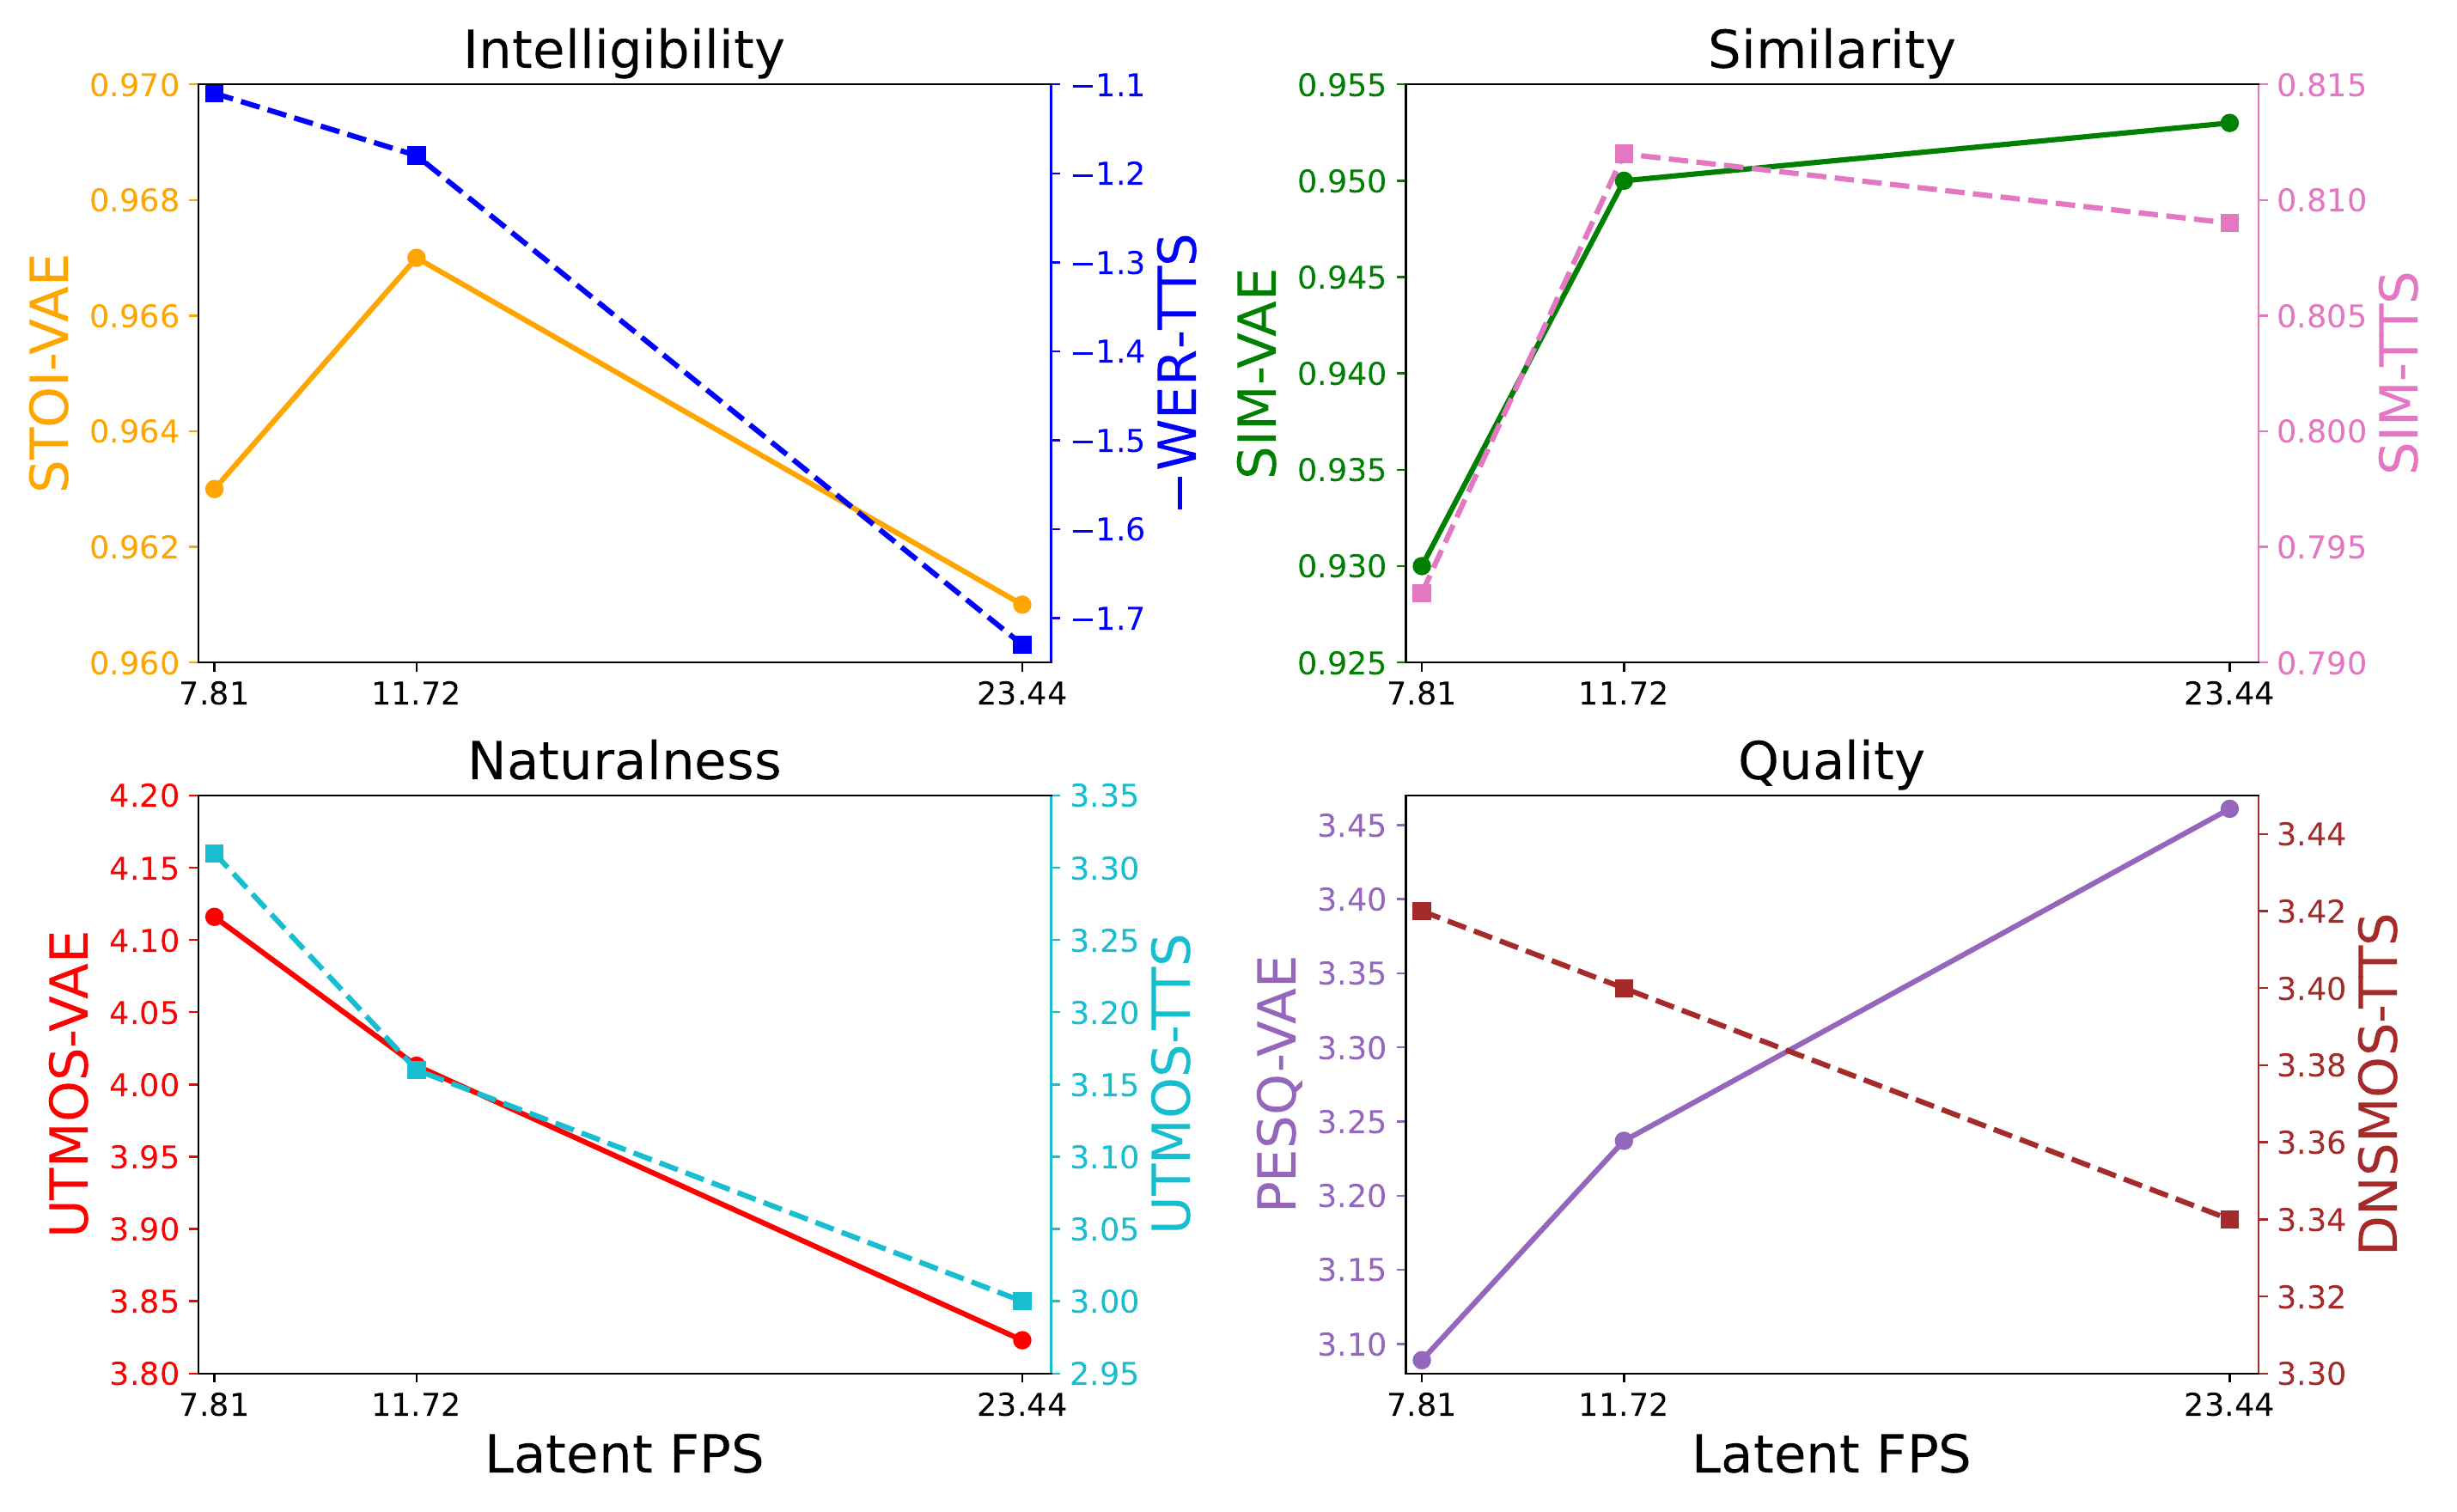
La pagina calcola la media delle colonne ufficiali SIM per ZH, EN e ZH-Hard e include solo le righe complete. Naturalezza e WER restano questioni separate.
| Modello | Media SIM sulle tre suddivisioni | Ancora da verificare |
|---|---|---|
| LongCat-AudioDiT 3.5B | circa 80.0 | WER, naturalezza e latenza |
| Qwen3-TTS | circa 74.5 | progettazione della voce vs clonazione |
| VoxCPM | circa 74.4 | coerenza sui contenuti lunghi e RTF |
Conserva per la stessa frase sia l'uscita senza riferimento sia quella condizionata dal riferimento. Controlla nomi, numeri e pause prima di timbro, accento e prosodia. Ascoltare solo la somiglianza può nascondere parole mancanti o rumore copiato.
Un riferimento utile è breve, pulito e con un solo parlante. Più voci, un riverbero forte e la musica fondono identità e ambiente; campioni ripetuti dello stesso testo rivelano la varianza tra similarità, prosodia e pronuncia.
La similarità del parlante misura la vicinanza degli embedding. Non dimostra l'identità e non concede il permesso di usare una voce. Lo strumento va usato su materiale di riferimento che l'utente ha il diritto di trattare.
Il repository pubblico e la scheda del modello 3.5B definiscono insieme i materiali rilasciati. I numeri di similarità restano legati ai rispettivi test set e non sostituiscono controlli separati su pronuncia multilingue, stabilità sui contenuti lunghi e naturalezza percepita.
Nomi dei modelli, numeri e limiti fanno riferimento ai paper, ai repository o alle schede dei modelli elencati qui sotto.