نموذج
LongCat-AudioDiT 3.5B: كتابة ظروف السماعة في محول نشر الصوت
قراءة مكثفة للورقة / استنساخ صوتي بدون عينة

قراءة مكثفة للورقة / استنساخ صوتي بدون عينة
© 2026 تيلك نت. جميع الحقوق محفوظة.
قراءة ورقة بحثية / استنساخ صوتي بلا أمثلة مسبقة
يستهدف LongCat-AudioDiT 3.5B تحويل النص إلى كلام والاستنساخ بلا أمثلة مسبقة. يلتقي النص الهدف مع مرجع صوتي للمتحدث وإشارات النغم داخل محوّل انتشار يولّد متغيّرات صوتية كامنة. أما أرقام التشابه المنشورة فتجيب عن سؤال أضيق مما تقيسه مقاييس الطبيعية أو معدل خطأ الكلمات أو اللكنة متعددة اللغات.
تُفسد عملية أمامية متغيّرًا صوتيًا كامنًا نظيفًا x₀ ليتحول إلى x_t. وبشرط النص ومعلومات المتحدث c، تتنبأ الشبكة بالضجيج أو السرعة:
L=E ||ε−εθ(x_t,t,c)||²
يستخدم مسار الجودة المنشور 32 تقييمًا للدالة. ويعتمد التوليف غير المشروط على CFG، بينما يتبع الاستنساخ القائم على مرجع طريقة APG الخاصة بالمشروع لتخفيف فرط التشبّع في ظل التوجيه القوي.
تولّد أنظمة كثيرة بلا أمثلة مسبقة وحدات صوتية متقطعة واحدة تلو الأخرى. أما LongCat فيستعيد مسارًا صوتيًا متصلًا بمحوّل انتشار، بينما يزوّد UMT5 سمات النص ويزوّد المرجع الهوية والنغم. ينقل هذا التحوّل تراكم الخطأ من ترتيب الرموز إلى إزالة الضجيج التكرارية والتوجيه.
يسجّل جدول Seed الرسمي ثلاث شرائح لتشابه المتحدث يبلغ متوسط قيم النموذج 3.5B فيها نحو 80.0. لا تُقارن تلك الصفوف إلا داخل الجدول المذكور؛ فهي لا تغني عن MOS ولا معدل خطأ الكلمات ولا اللكنة العابرة للغات ولا الاتساق في المقاطع الطويلة. قد يبدو الصوت مشابهًا بينما يخطئ في قراءة اسم.
المقطع المرجعي المفيد قصير ونظيف ولمتحدث واحد. فتعدد المتحدثين والموسيقى والصدى القوي يخلط البيئة بالهوية. تشابه الصوت خاصية توليف، وليس إشارة للتحقق من الهوية ولا إذنًا بانتحال صوت شخص.
اعتاد الاستنساخ بلا أمثلة مسبقة على رموز صوتية متقطعة ذاتية الارتداد: يتنبأ النموذج بالوحدات الصوتية واحدة تلو الأخرى بينما يوفّر المرجع شرط المتحدث. أما LongCat-AudioDiT 3.5B فيستعيد متغيّرًا صوتيًا كامنًا متصلًا بمحوّل انتشار، مستخدمًا UMT5 للنص والمرجع للون الصوت والنغم.
الفائدة والكلفة كلتاهما نتيجة إزالة الضجيج الشاملة. يمكن مراجعة بنية الجملة عبر المسار كله، لكن 32 تقييمًا للدالة تزيد زمن الاستجابة. كما يغيّر كل من APG وCFG تشبّع لون الصوت وثبات النطق والضجيج الخلفي المنسوخ؛ فهما أكثر من مجرد رقم توجيه واحد.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tالمتغيّر الصوتي الكامن عند الخطوة tc_textشرط النصc_spkشرط المتحدث المستمد من المرجعيعرض هذا الترميز العام للانتشار المشروط دخول شرطَي النص والمتحدث إلى مزيل الضجيج معًا؛ ولا يُقدَّم بوصفه معادلة مطابقة حرفيًا لما في المستودع. ويحدّث 32 تقييمًا للدالة المتغيّر الكامن تكرارًا.
تشابه المتحدث وصحة المحتوى محوران منفصلان. فقد يحوّل المقطع المرجعي المشوَّش صوت الغرفة إلى شرط صوتي، ولا يثبت التشابه المرتفع صحة الأسماء أو الأرقام أو مواضع الوقف.
يمكن تتبّع الورقة والشيفرة والأوزان عبر LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
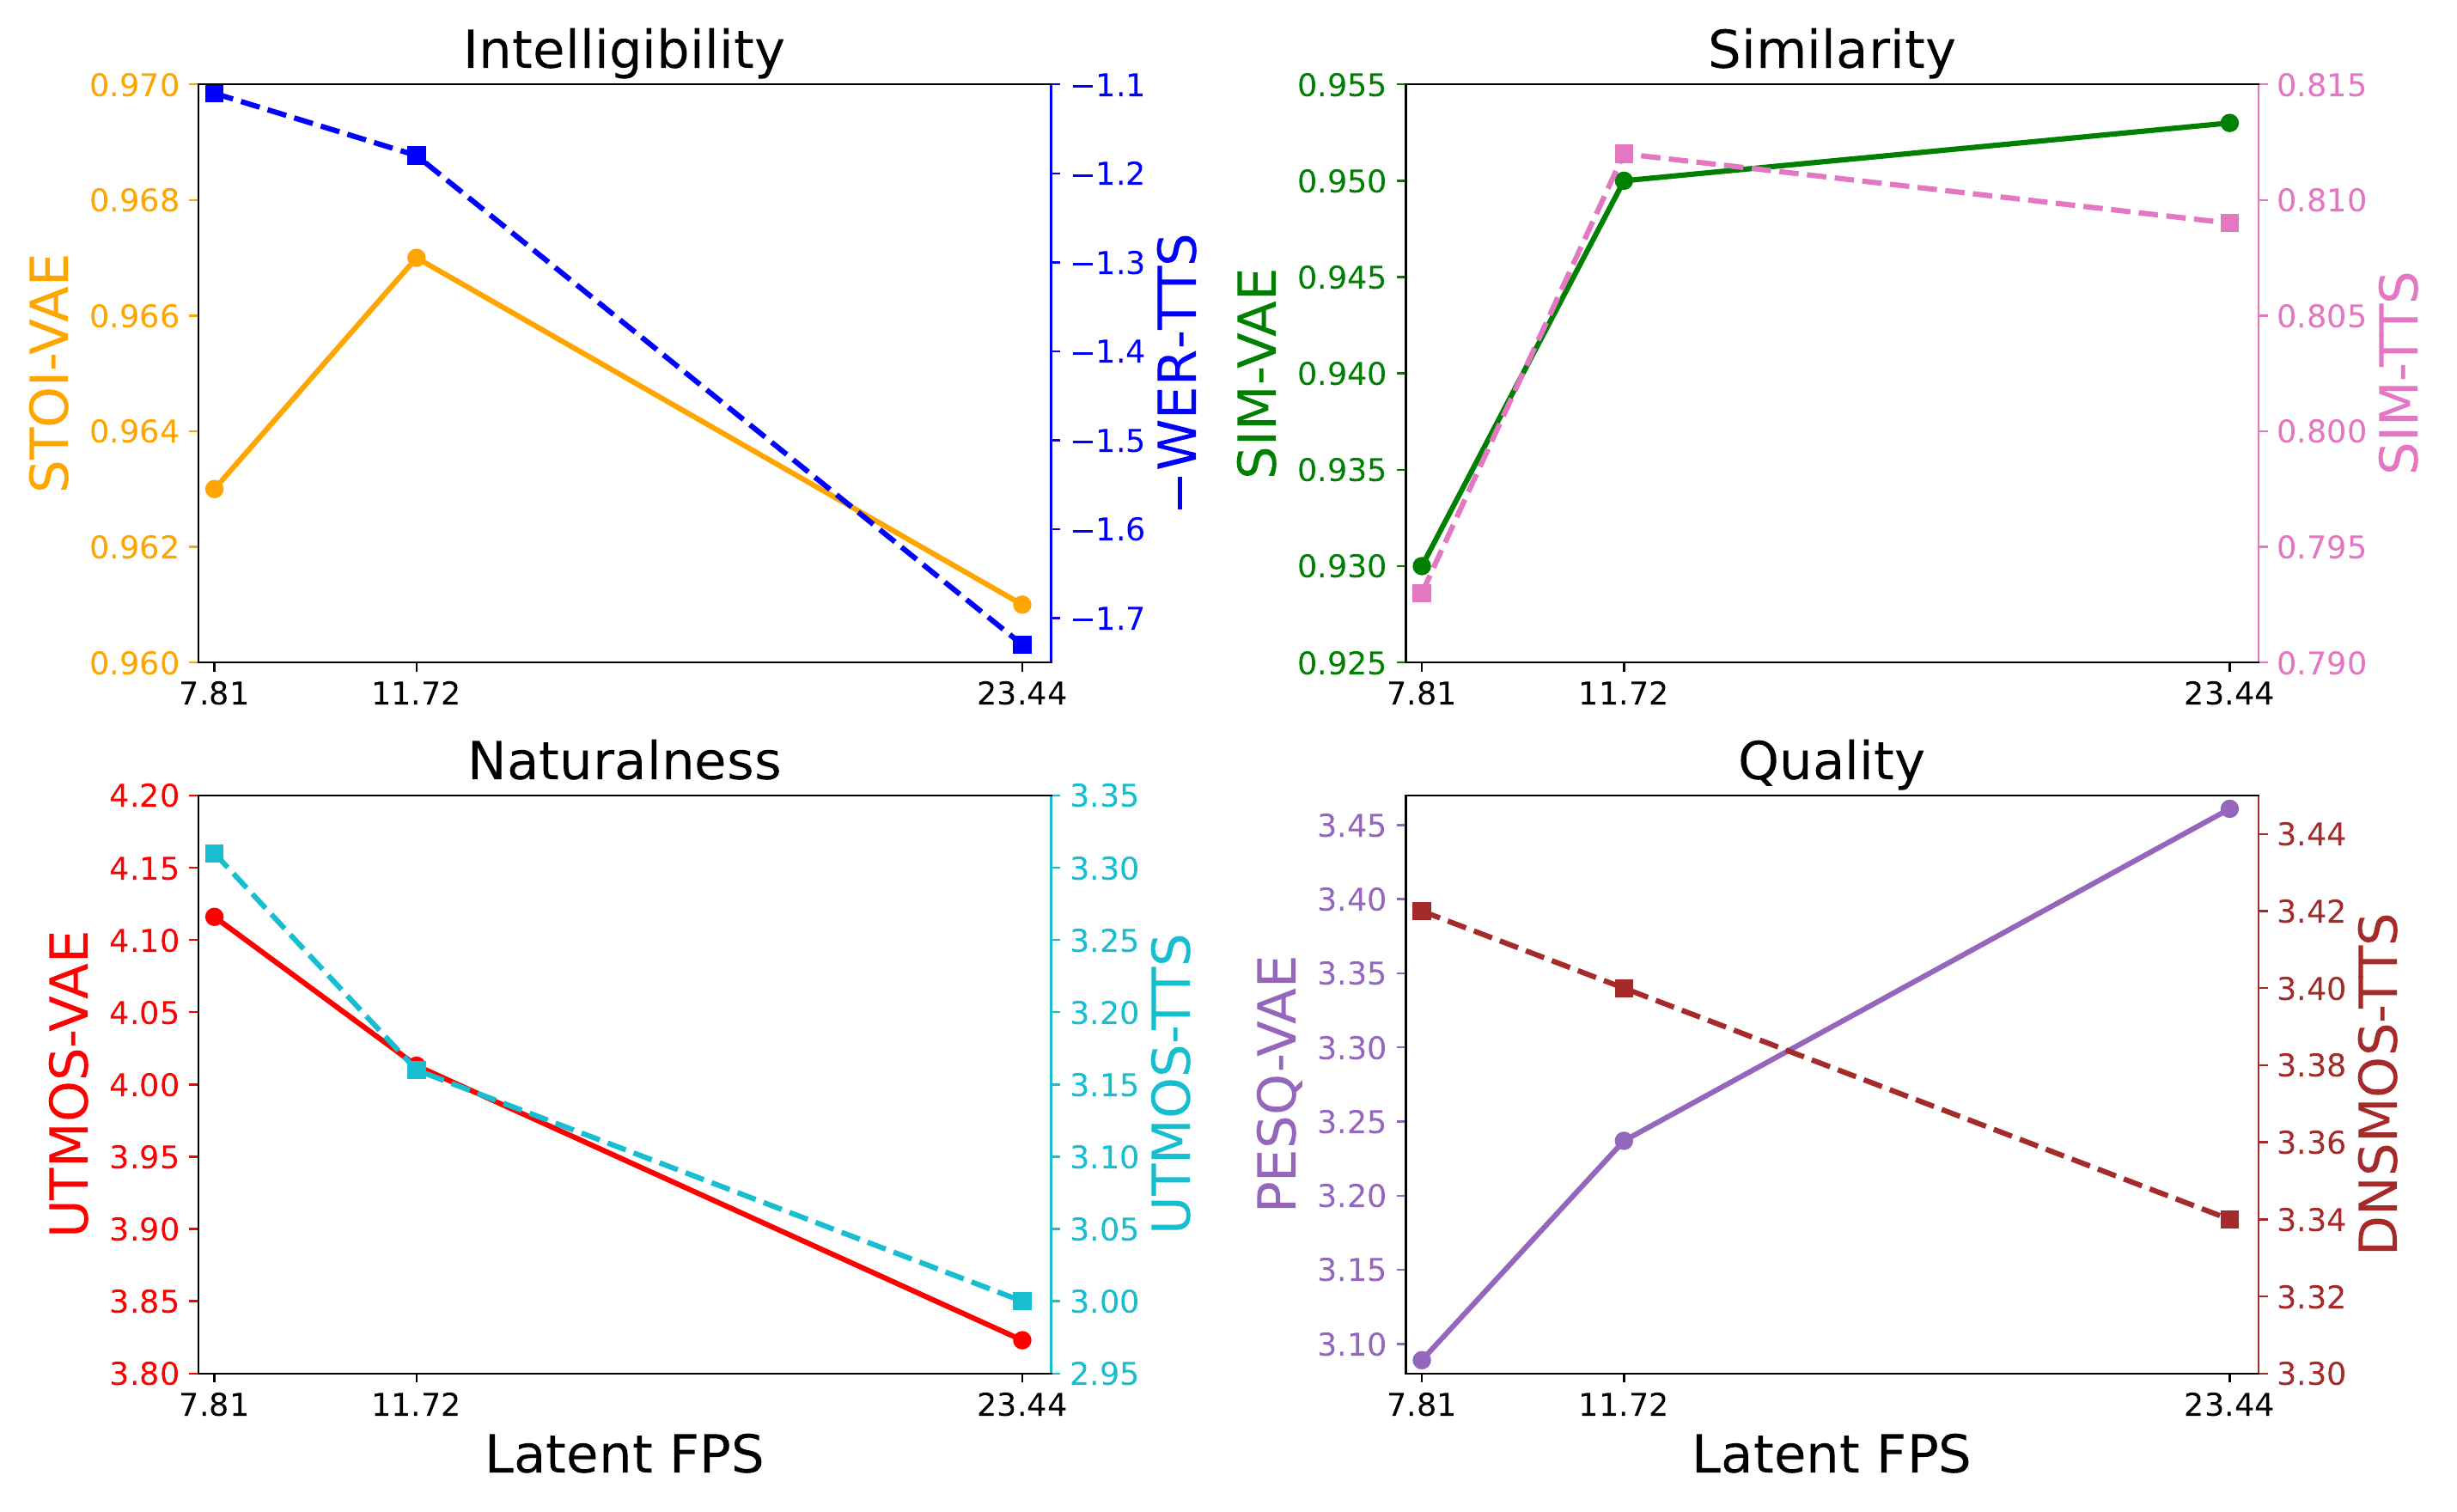
يُحسب متوسط أعمدة SIM الرسمية ZH وEN وZH-Hard، مع إدراج الصفوف المكتملة فقط. وتبقى الطبيعية وWER سؤالين منفصلين.
| النموذج | متوسط SIM للشرائح الثلاث | تدقيق متبقٍ |
|---|---|---|
| LongCat-AudioDiT 3.5B | نحو 80.0 | WER والطبيعية وزمن الاستجابة |
| Qwen3-TTS | نحو 74.5 | تصميم الصوت مقابل الاستنساخ |
| VoxCPM | نحو 74.4 | تماسك المقاطع الطويلة وRTF |
احتفظ بالمخرجات بدون مرجع وبالمشروطة بالمرجع للجملة نفسها. افحص الأسماء والأرقام ومواضع الوقف قبل لون الصوت واللكنة والنغم. فالاستماع إلى التشابه وحده قد يخفي كلمات ساقطة أو ضجيجًا منسوخًا.
المرجع المفيد قصير ونظيف ولمتحدث واحد. فالأصوات المتعددة والصدى القوي والموسيقى تمزج الهوية بالبيئة؛ وتكشف العينات المتكررة للنص نفسه التباين في التشابه والنغم والنطق.
يقيس تشابه المتحدث قرب التضمينات في فضاء التمثيل. فهو لا يثبت الهوية ولا يمنح إذنًا باستخدام صوت ما. الأداة مخصصة للمواد المرجعية التي يحق للمستخدم معالجتها.
يحدّد المستودع العام وبطاقة النموذج 3.5B معًا المواد المنشورة. وتبقى أرقام التشابه مرتبطة بمجموعات الاختبار المسماة ولا تغني عن فحوص مستقلة للنطق متعدد اللغات وثبات المقاطع الطويلة والطبيعية المُدرَكة.
ترجع أسماء النماذج والأرقام والقيود إلى الأوراق أو المستودعات أو بطاقات النماذج أدناه.