モデル
LongCat-AudioDiT 3.5B: スピーカーの状態をオーディオ拡散トランスに書き込みます
論文を集中的に読む / ゼロサンプル音声のクローン作成

論文を集中的に読む / ゼロサンプル音声のクローン作成
© 2026 TelkNet。無断転載を禁じます。
論文解説 / ゼロショット音声クローニング
LongCat-AudioDiT 3.5Bはテキスト音声変換とゼロショットクローニングを対象とする。目的のテキスト、話者参照、韻律の手がかりが、音響潜在表現を生成する拡散Transformerの内部で出会う。公開されている類似度の数値が答えているのは、自然さ、単語誤り率、多言語アクセントよりも狭い問いだ。
順過程はクリーンな音響潜在変数 x₀ を x_t へと損なっていく。テキストと話者情報 c を条件として、ネットワークはノイズまたは速度を予測する:
L=E ||ε−εθ(x_t,t,c)||²
公開された品質パスは32回の関数評価を使う。無条件の合成ではCFGを用い、参照ベースのクローニングでは強いガイダンス下での過飽和を抑えるため、プロジェクトのAPG手法に従う。
多くのゼロショットシステムは、離散的な音響単位を一つずつ生成する。これに対してLongCatは拡散Transformerで連続的な音響軌道を復元し、UMT5がテキスト特徴を、参照が話者性と韻律を供給する。この転換により、誤差の蓄積はトークン列の順序から、反復的なデノイジングとガイダンスへと移る。
公式のSeedテーブルには3つの話者類似度スプリットがあり、3.5Bの値は平均で約80.0となる。これらの行は名前のある同じテーブル内でのみ比較でき、MOS、単語誤り率、言語間アクセント、長文の一貫性の代わりにはならない。声が似ていても、名前を読み間違えることはある。
使えるプロンプトは短く、クリーンで、話者が一人のものだ。複数の話者、音楽、強いリバーブは、環境を話者性に混ぜてしまう。声の類似度は合成の性質であり、本人確認の信号でも、他人になりすます許可でもない。
ゼロショットクローニングでは、自己回帰的な離散音声トークンがよく使われてきた。モデルが音響単位を一つずつ予測し、参照が話者条件を供給する方式だ。LongCat-AudioDiT 3.5Bはこれと異なり、拡散Transformerで連続的な音響潜在変数を復元し、テキストにはUMT5を、音色と韻律には参照を使う。
利点もコストも、大域的なデノイジングに由来する。文の構造を軌道全体にわたって修正できる一方、32回の関数評価はレイテンシを増やす。APGとCFGは音色の飽和、発音の安定性、コピーされる背景雑音にも影響する。単一のガイダンス数値では語れない代物だ。

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tステップtの音響潜在変数c_textテキスト条件c_spk参照から得た話者条件この一般的な条件付き拡散の表記は、テキスト条件と話者条件がデノイザに同時に入ることを示すものであり、リポジトリの数式を行単位で写したものではない。32回の関数評価が潜在変数を繰り返し更新する。
話者類似度と内容の正しさは別の軸だ。ノイズの多いプロンプトは部屋の音を声の条件に変えてしまうことがあり、類似度が高くても、名前、数字、間が正しいことの証明にはならない。
論文、コード、重みは LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights からたどれる。
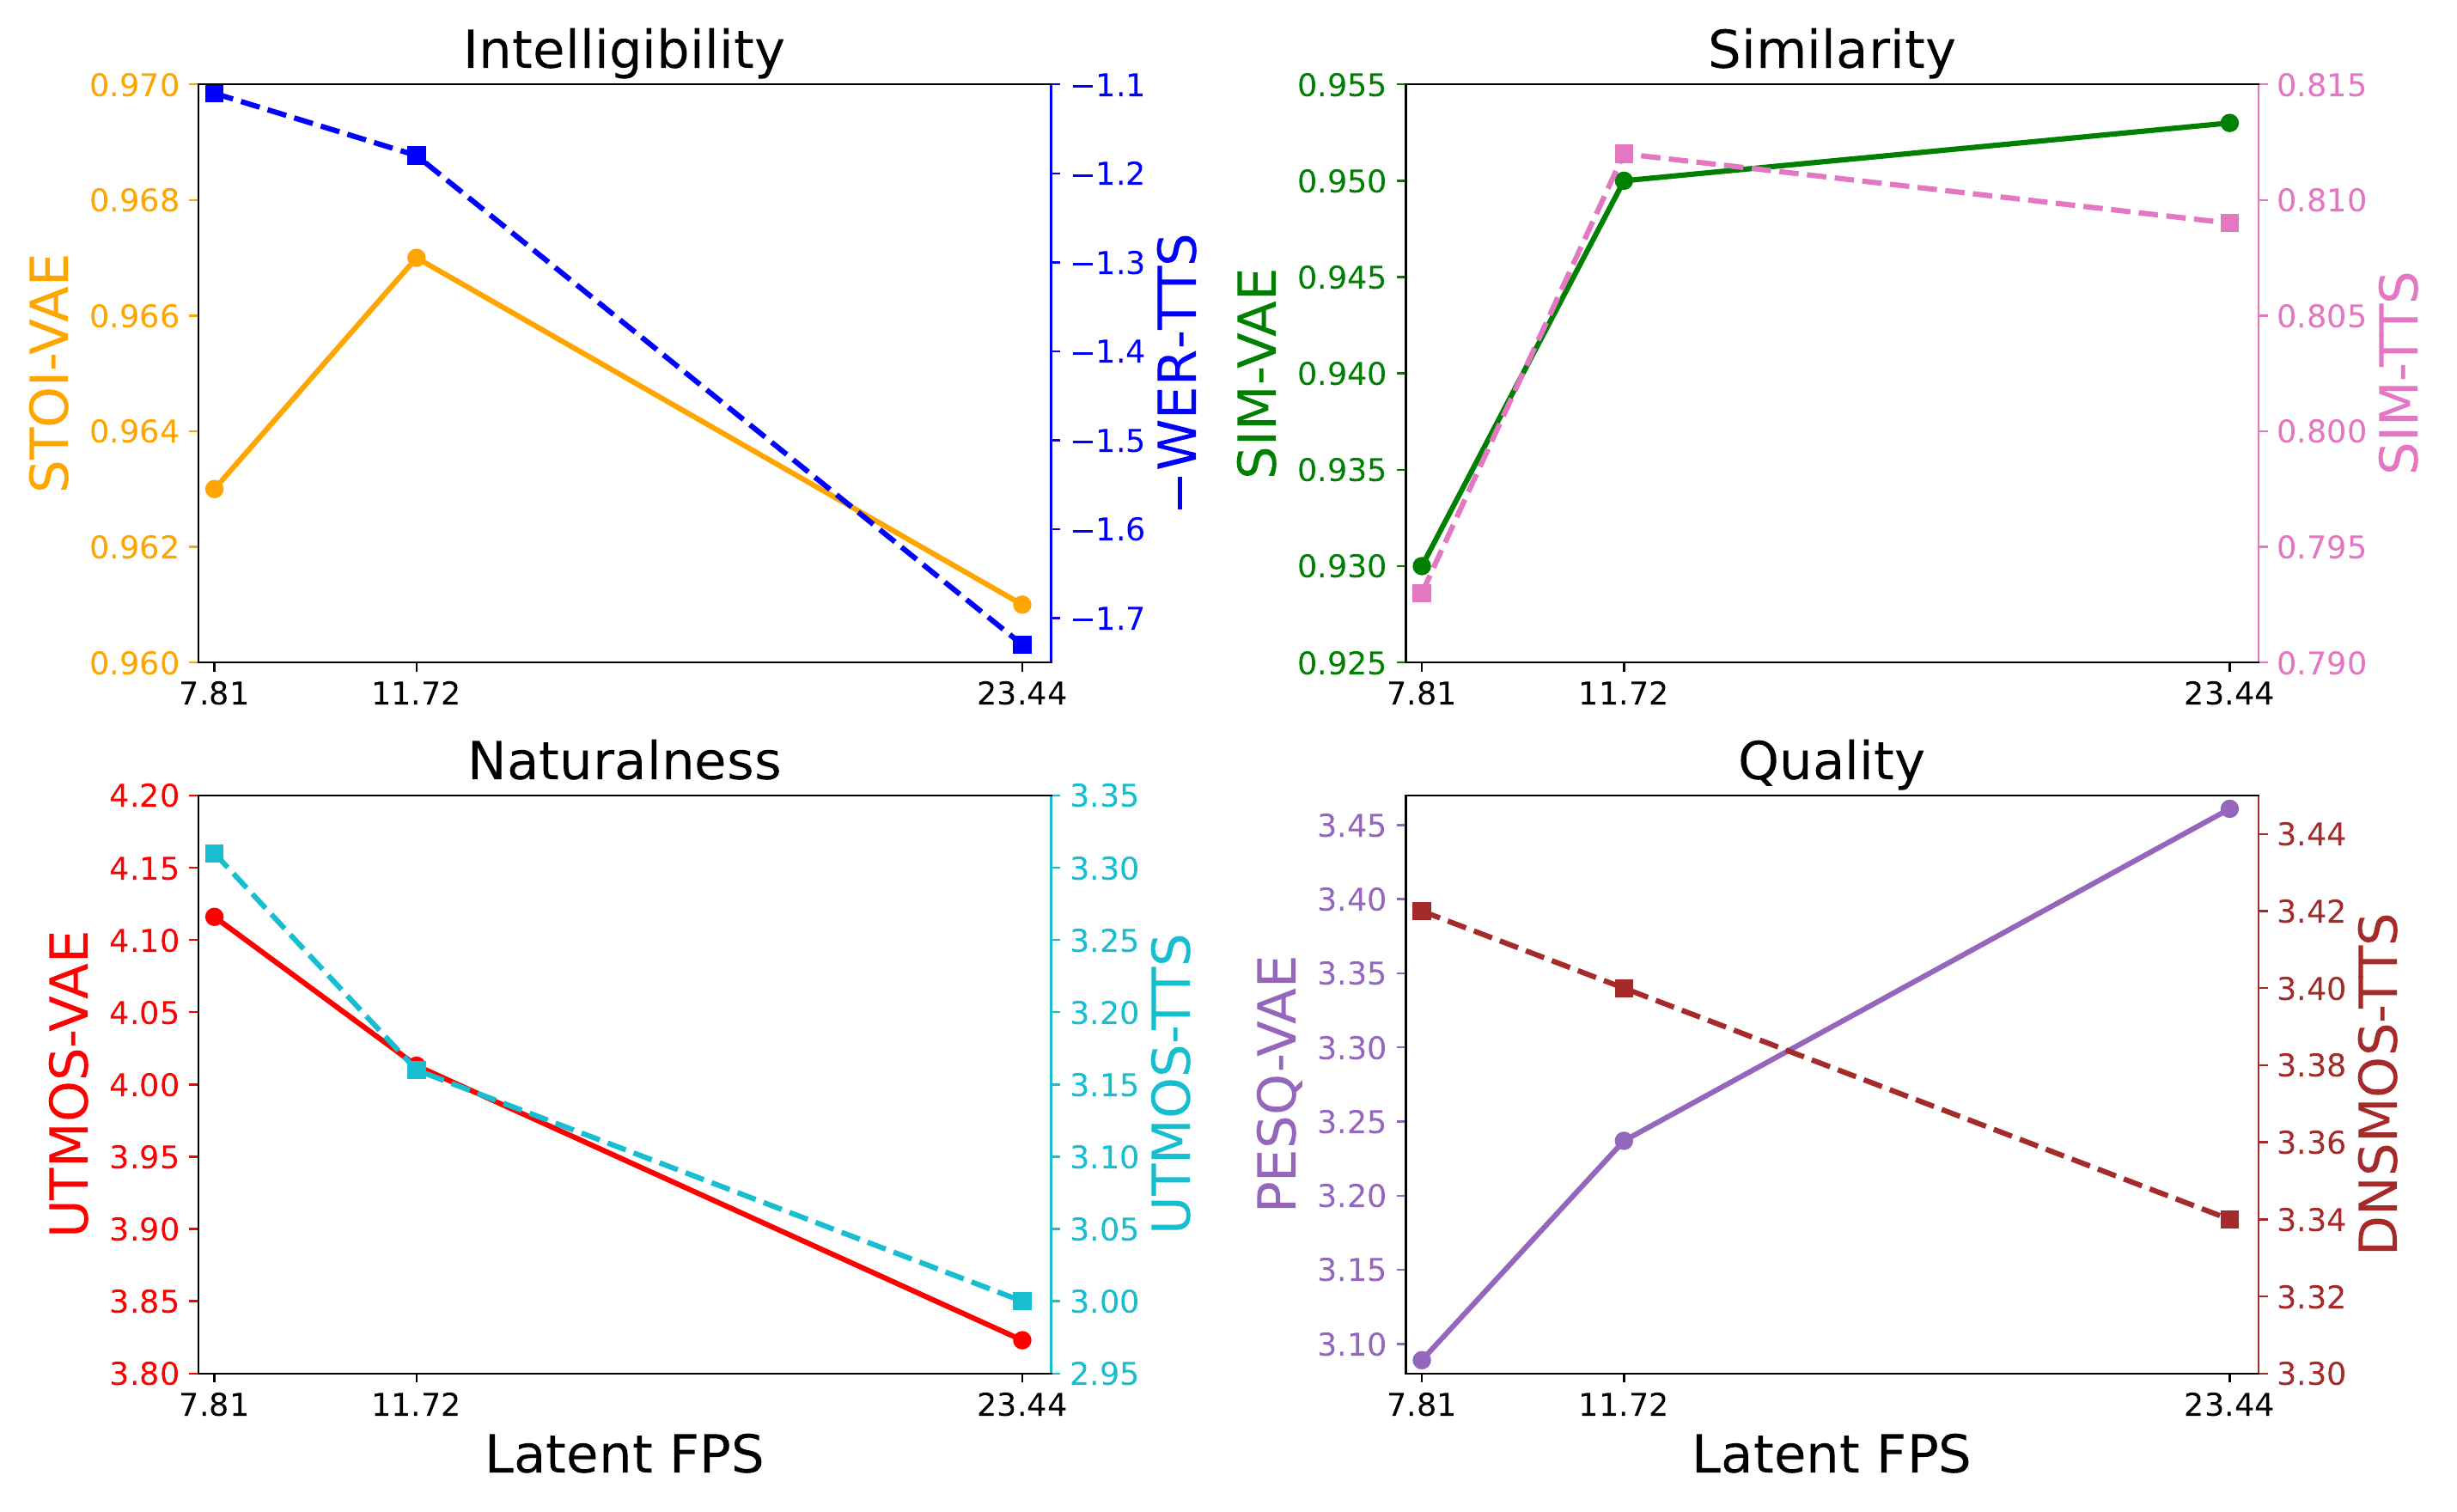
公式のZH、EN、ZH-HardのSIM列を平均し、完全な行のみを採用している。自然さとWERは引き続き別の問いだ。
| モデル | 3スプリット平均SIM | 引き続き監査対象 |
|---|---|---|
| LongCat-AudioDiT 3.5B | 約80.0 | WER、自然さ、レイテンシ |
| Qwen3-TTS | 約74.5 | 音声デザイン対クローニング |
| VoxCPM | 約74.4 | 長文の一貫性とRTF |
同じ文について、参照なしと参照条件付きの両方の出力を残しておく。音色、アクセント、韻律の前に、名前、数字、間を確認する。似ているかだけを聴いていると、欠落した単語やコピーされたノイズを見逃す。
使える参照は短く、クリーンで、話者が一人のものだ。複数の声、強いリバーブ、音楽は話者性と環境を混ぜ合わせる。同じテキストで繰り返しサンプルを生成すれば、類似度、韻律、発音のばらつきが見えてくる。
話者類似度は埋め込みの近さを測るものだ。本人であることの証明にも、声を使う許可にもならない。このツールは、利用者が処理する権利を持つ参照素材のためのものだ。
公開リポジトリと3.5Bモデルカードが、リリース済みの資料を示している。類似度の数値は指定されたテストセットに結びついており、多言語発音、長文の安定性、知覚される自然さの個別確認の代わりにはならない。
モデル名、数値、限界は、以下の論文、リポジトリ、モデルカードに遡る。