Model
LongCat-AudioDiT 3.5B: Zapisz warunki głośników w transformatorze dyfuzyjnym audio
Intensywne czytanie artykułu / Klonowanie głosu z próbką zerową

Intensywne czytanie artykułu / Klonowanie głosu z próbką zerową
© 2026 TelkNet. Wszelkie prawa zastrzeżone.
LEKTURA PUBLIKACJI / KLONOWANIE GŁOSU ZERO-SHOT
LongCat-AudioDiT 3.5B celuje w syntezę mowy z tekstu i klonowanie głosu zero-shot. Docelowy tekst, nagranie referencyjne mówcy i wskazówki prozodyczne spotykają się w dyfuzyjnym transformerze, który generuje latenty akustyczne. Opublikowane wyniki podobieństwa odpowiadają na węższe pytanie niż naturalność, wskaźnik błędnych słów czy wielojęzyczny akcent.
Proces w przód zniekształca czysty latent akustyczny x₀ do postaci x_t. Uwarunkowana tekstem i informacją o mówcy c sieć przewiduje szum lub prędkość:
L=E ||ε−εθ(x_t,t,c)||²
Opublikowana ścieżka jakości korzysta z 32 ewaluacji funkcji. Synteza bezwarunkowa stosuje CFG, a klonowanie z referencją podąża za autorską metodą APG projektu, która ogranicza przesycenie przy silnym naprowadzaniu.
Wiele systemów zero-shot generuje dyskretne jednostki akustyczne jedna po drugiej. LongCat zamiast tego odtwarza ciągłą trajektorię akustyczną dyfuzyjnym transformerem: UMT5 dostarcza cech tekstu, a referencja tożsamość i prozodię. Ta zmiana przenosi akumulację błędów z kolejności tokenów w stronę iteracyjnego odszumiania i naprowadzania.
Oficjalna tabela Seed podaje trzy podziały podobieństwa mówcy, których wartości dla 3.5B wynoszą średnio około 80.0. Te wiersze można porównywać tylko w obrębie wskazanej tabeli; nie zastępują MOS, wskaźnika błędnych słów, akcentu międzyjęzykowego ani spójności długich nagrań. Głos może brzmieć podobnie, a mimo to przekręcić nazwisko.
Użyteczna podpowiedź jest krótka, czysta i zawiera jednego mówcę. Kilku mówców, muzyka i silny pogłos mieszają otoczenie z tożsamością. Podobieństwo głosu to właściwość syntezy, a nie sygnał weryfikacji tożsamości ani pozwolenie na podszywanie się pod inną osobę.
Klonowanie zero-shot często opierało się na autoregresyjnych, dyskretnych tokenach audio: model przewiduje jednostki akustyczne jedna po drugiej, a referencja dostarcza warunkowania mówcy. LongCat-AudioDiT 3.5B zamiast tego odtwarza ciągły latent akustyczny dyfuzyjnym transformerem, używając UMT5 do tekstu, a referencji do barwy głosu i prozodii.
Korzyść i koszt wynikają z globalnego odszumiania. Strukturę zdania można poprawiać wzdłuż całej trajektorii, lecz 32 ewaluacje funkcji zwiększają opóźnienie. APG i CFG zmieniają też nasycenie barwy, stabilność wymowy i kopiowany szum tła — to coś więcej niż pojedyncza liczba naprowadzania.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatent akustyczny w kroku tc_textwarunek tekstowyc_spkwarunek mówcy z referencjiTen ogólny zapis dyfuzji warunkowej pokazuje, że warunki tekstu i mówcy trafiają do odszumiacza razem; nie jest to równanie przepisane z repozytorium linia po linii. Trzydzieści dwie ewaluacje funkcji wielokrotnie aktualizują latent.
Podobieństwo mówcy i poprawność treści to osobne osie. Zaszumiona podpowiedź może zamienić dźwięki pomieszczenia w warunek głosu, a wysokie podobieństwo nie dowodzi poprawności nazwisk, liczb ani pauz.
Pracę, kod i wagi można śledzić przez LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
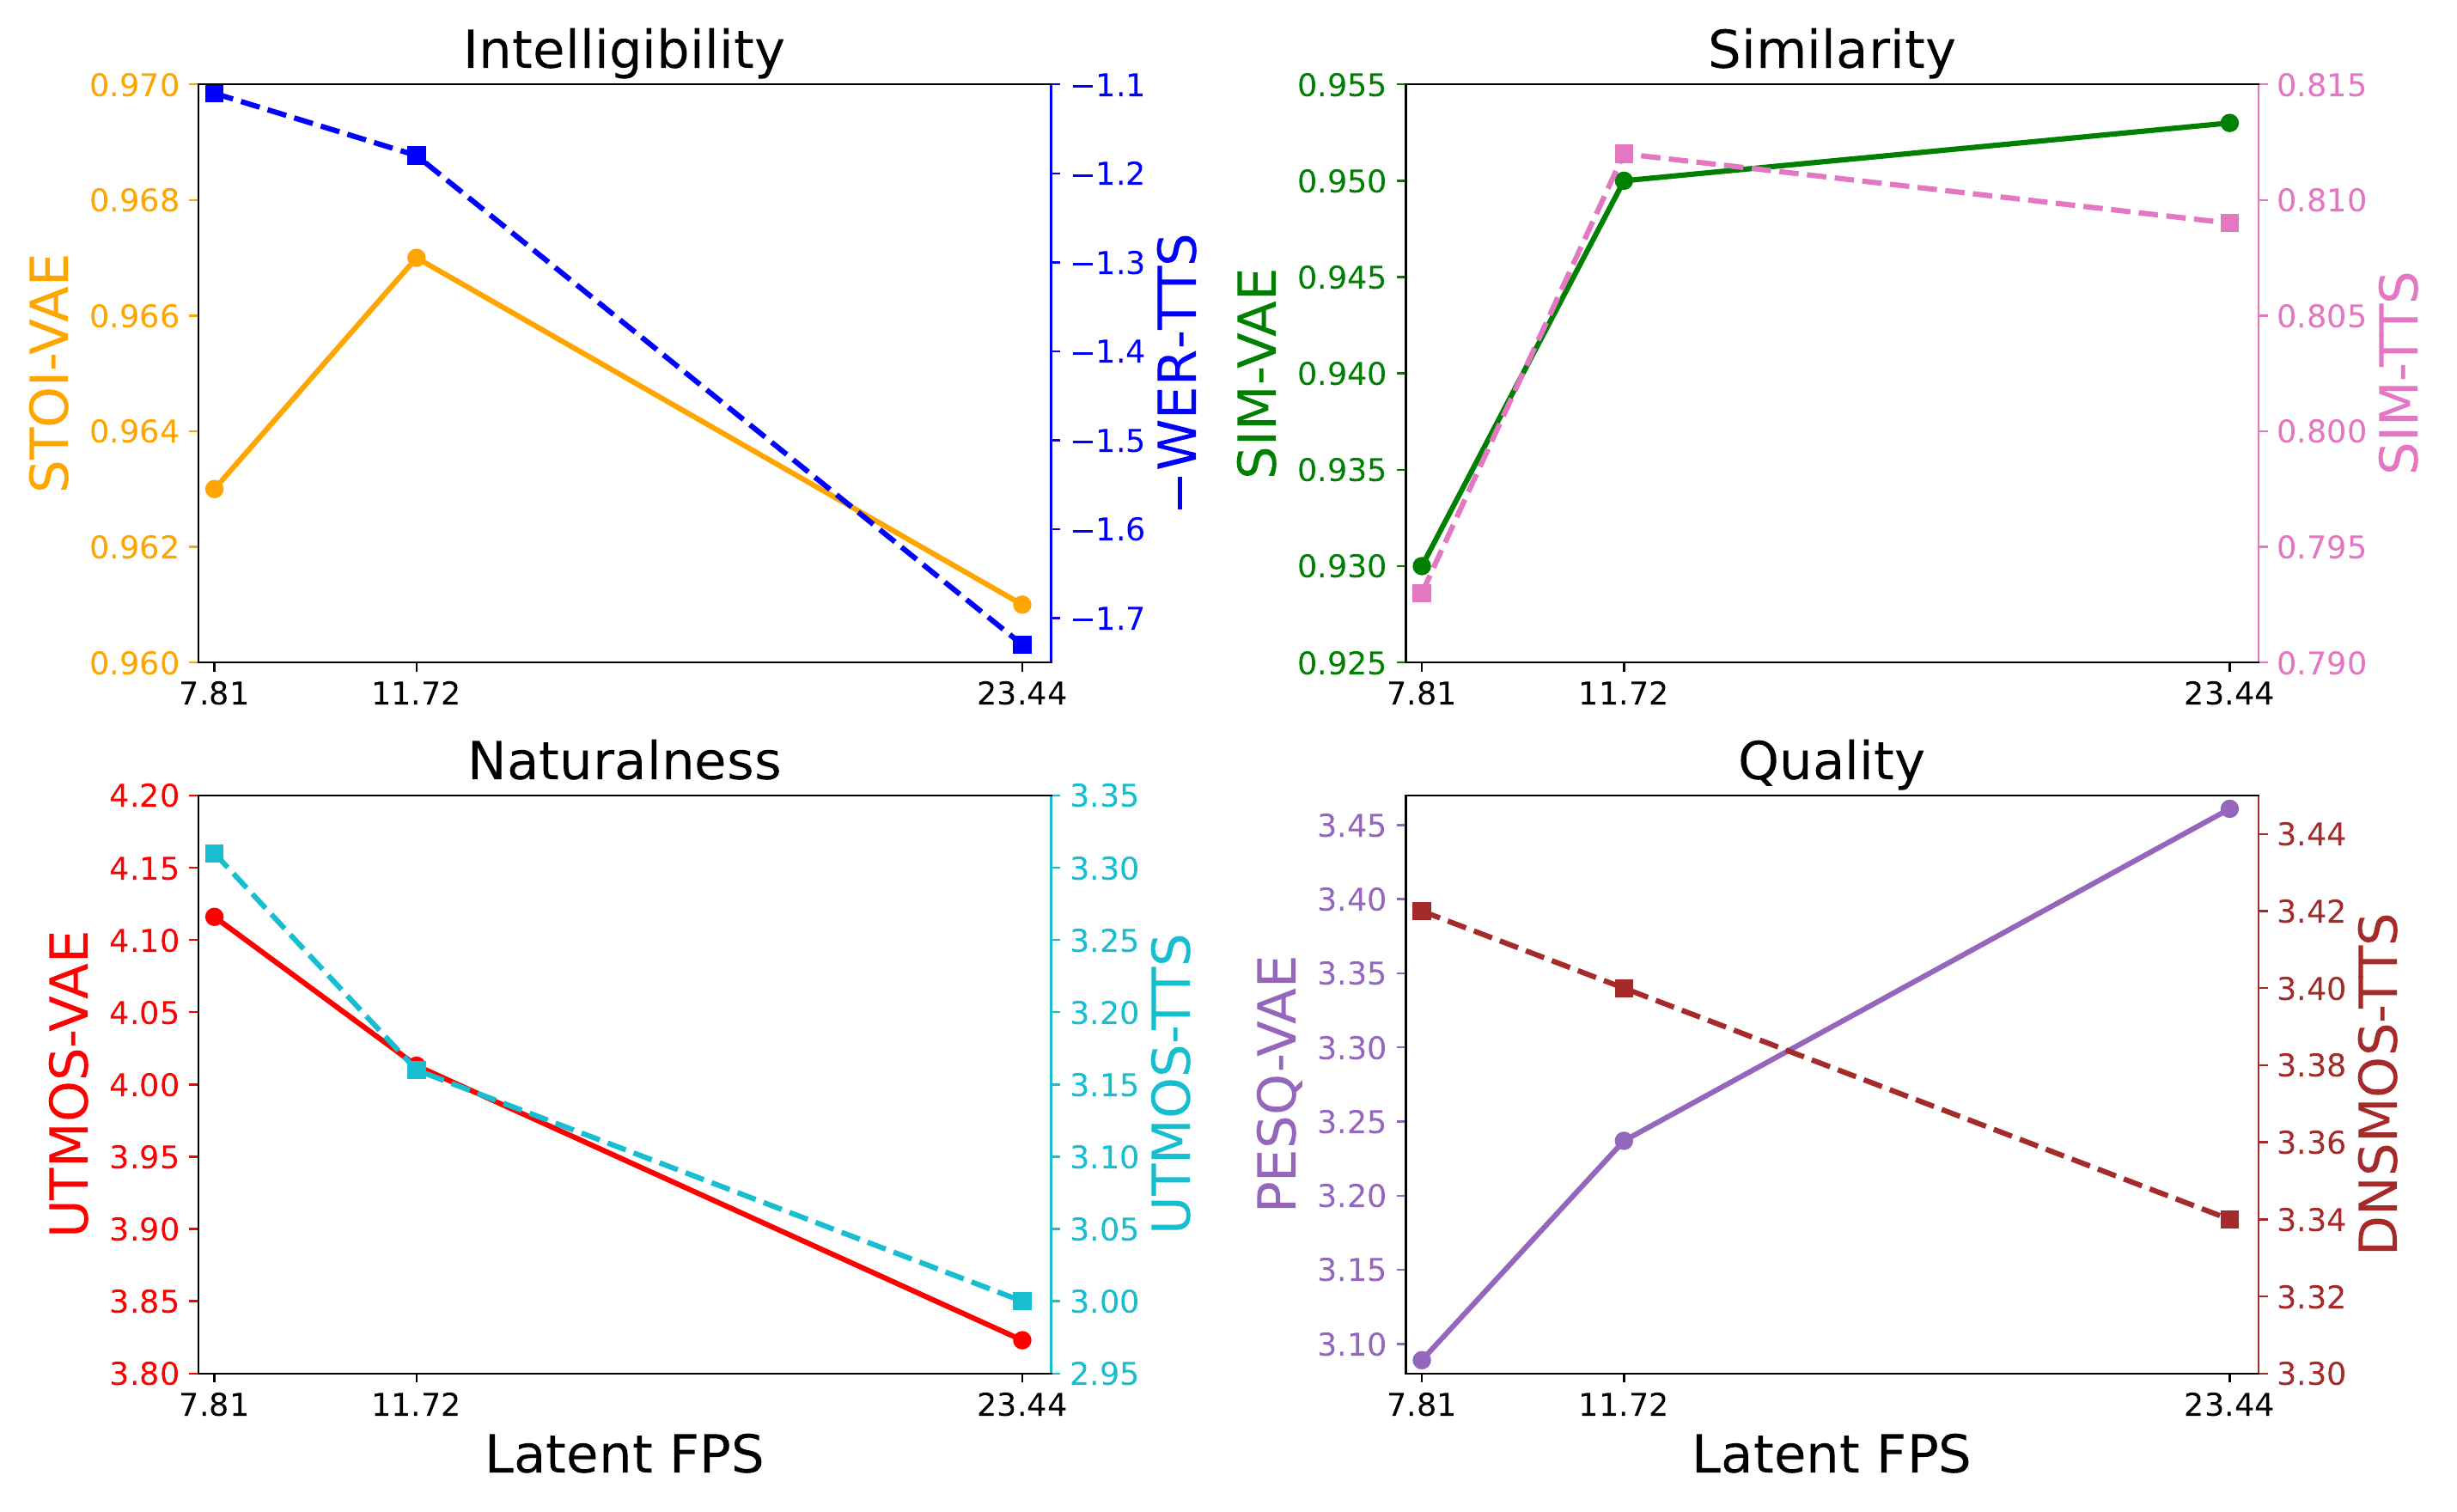
Średnia obejmuje oficjalne kolumny SIM ZH, EN i ZH-Hard oraz wyłącznie kompletne wiersze. Naturalność i WER pozostają odrębnymi pytaniami.
| Model | Średnia SIM z trzech podziałów | Nadal sprawdzać |
|---|---|---|
| LongCat-AudioDiT 3.5B | około 80.0 | WER, naturalność i opóźnienie |
| Qwen3-TTS | około 74.5 | projektowanie głosu a klonowanie |
| VoxCPM | około 74.4 | spójność długich nagrań i RTF |
Dla tego samego zdania zachowaj zarówno wynik bez referencji, jak i uwarunkowany referencją. Nazwiska, liczby i pauzy sprawdzaj przed barwą, akcentem i prozodią. Słuchanie wyłącznie pod kątem podobieństwa może ukryć brakujące słowa albo skopiowany szum.
Użyteczna referencja jest krótka, czysta i jednoosobowa. Kilka głosów, silny pogłos i muzyka mieszają tożsamość z otoczeniem; powtórzone próbki tego samego tekstu ujawniają zmienność podobieństwa, prozodii i wymowy.
Podobieństwo mówcy mierzy bliskość osadzeń. Nie dowodzi tożsamości ani nie daje pozwolenia na użycie głosu. Narzędzie służy do materiału referencyjnego, który użytkownik ma prawo przetwarzać.
Publiczne repozytorium i karta modelu 3.5B wspólnie określają opublikowane materiały. Wyniki podobieństwa pozostają związane ze wskazanymi zbiorami testowymi i nie zastępują osobnych kontroli wymowy wielojęzycznej, stabilności długich nagrań i odbieranej naturalności.
Nazwy modeli, liczby i ograniczenia można prześledzić w poniższych publikacjach, repozytoriach lub kartach modeli.