Модель
LongCat-AudioDiT 3.5B: запись условий динамика в преобразователь диффузии звука
Интенсивное чтение статьи / Клонирование голоса с нулевой выборкой

Интенсивное чтение статьи / Клонирование голоса с нулевой выборкой
РАЗБОР СТАТЬИ / ZERO-SHOT КЛОНИРОВАНИЕ ГОЛОСА
LongCat-AudioDiT 3.5B нацелена на синтез речи по тексту и zero-shot клонирование. Целевой текст, голосовой референс диктора и просодические подсказки встречаются внутри диффузионного трансформера, генерирующего акустические латенты. Опубликованные цифры сходства отвечают на более узкий вопрос, чем естественность, доля словарных ошибок или многоязычный акцент.
Прямой процесс зашумляет чистый акустический латент x₀ до x_t. При условии на текст и информацию о дикторе c сеть предсказывает шум или скорость:
L=E ||ε−εθ(x_t,t,c)||²
Опубликованный качественный режим использует 32 вычисления функции. Безусловный синтез использует CFG, а клонирование по референсу следует методу APG из проекта, чтобы снизить перенасыщение при сильном наведении.
Многие zero-shot системы генерируют дискретные акустические единицы по одной за раз. LongCat вместо этого восстанавливает непрерывную акустическую траекторию диффузионным трансформером: UMT5 поставляет текстовые признаки, а референс — индивидуальность голоса и просодию. Такой переход переносит накопление ошибок с порядка токенов на итеративное шумоподавление и наведение.
Официальная таблица Seed приводит три разбиения по сходству с диктором, значения 3.5B в которых в среднем составляют около 80.0. Эти строки сопоставимы только внутри названной таблицы; они не заменяют MOS, долю словарных ошибок, межъязыковой акцент или согласованность на длинных фрагментах. Голос может звучать похоже и при этом неверно прочитывать имя.
Полезный референс короткий, чистый и с одним диктором. Несколько говорящих, музыка и сильная реверберация смешивают окружение с индивидуальностью голоса. Сходство голосов — свойство синтеза, а не сигнал проверки личности и не разрешение выдавать себя за другого человека.
Zero-shot клонирование часто опиралось на авторегрессионные дискретные аудиотокены: модель предсказывает акустические единицы по одной, а референс задаёт условие на диктора. LongCat-AudioDiT 3.5B вместо этого восстанавливает непрерывный акустический латент диффузионным трансформером, используя UMT5 для текста и референс для тембра и просодии.
Выигрыш и цена следуют из глобального шумоподавления. Структуру предложения можно пересматривать по всей траектории, но 32 вычисления функции увеличивают задержку. APG и CFG также меняют насыщенность тембра, устойчивость произношения и скопированный фоновый шум; это больше, чем одно число наведения.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tакустический латент на шаге tc_textтекстовое условиеc_spkусловие на диктора из референсаЭта общая запись условной диффузии показывает, как текстовое условие и условие на диктора вместе входят в денойзер; она не претендует на построчное соответствие уравнению из репозитория. Тридцать два вычисления функции многократно обновляют латент.
Сходство с диктором и правильность содержания — разные оси. Шумный референс может превратить звук комнаты в голосовое условие, а высокое сходство не доказывает правильность имён, чисел или пауз.
Статью, код и веса можно найти по ссылкам LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
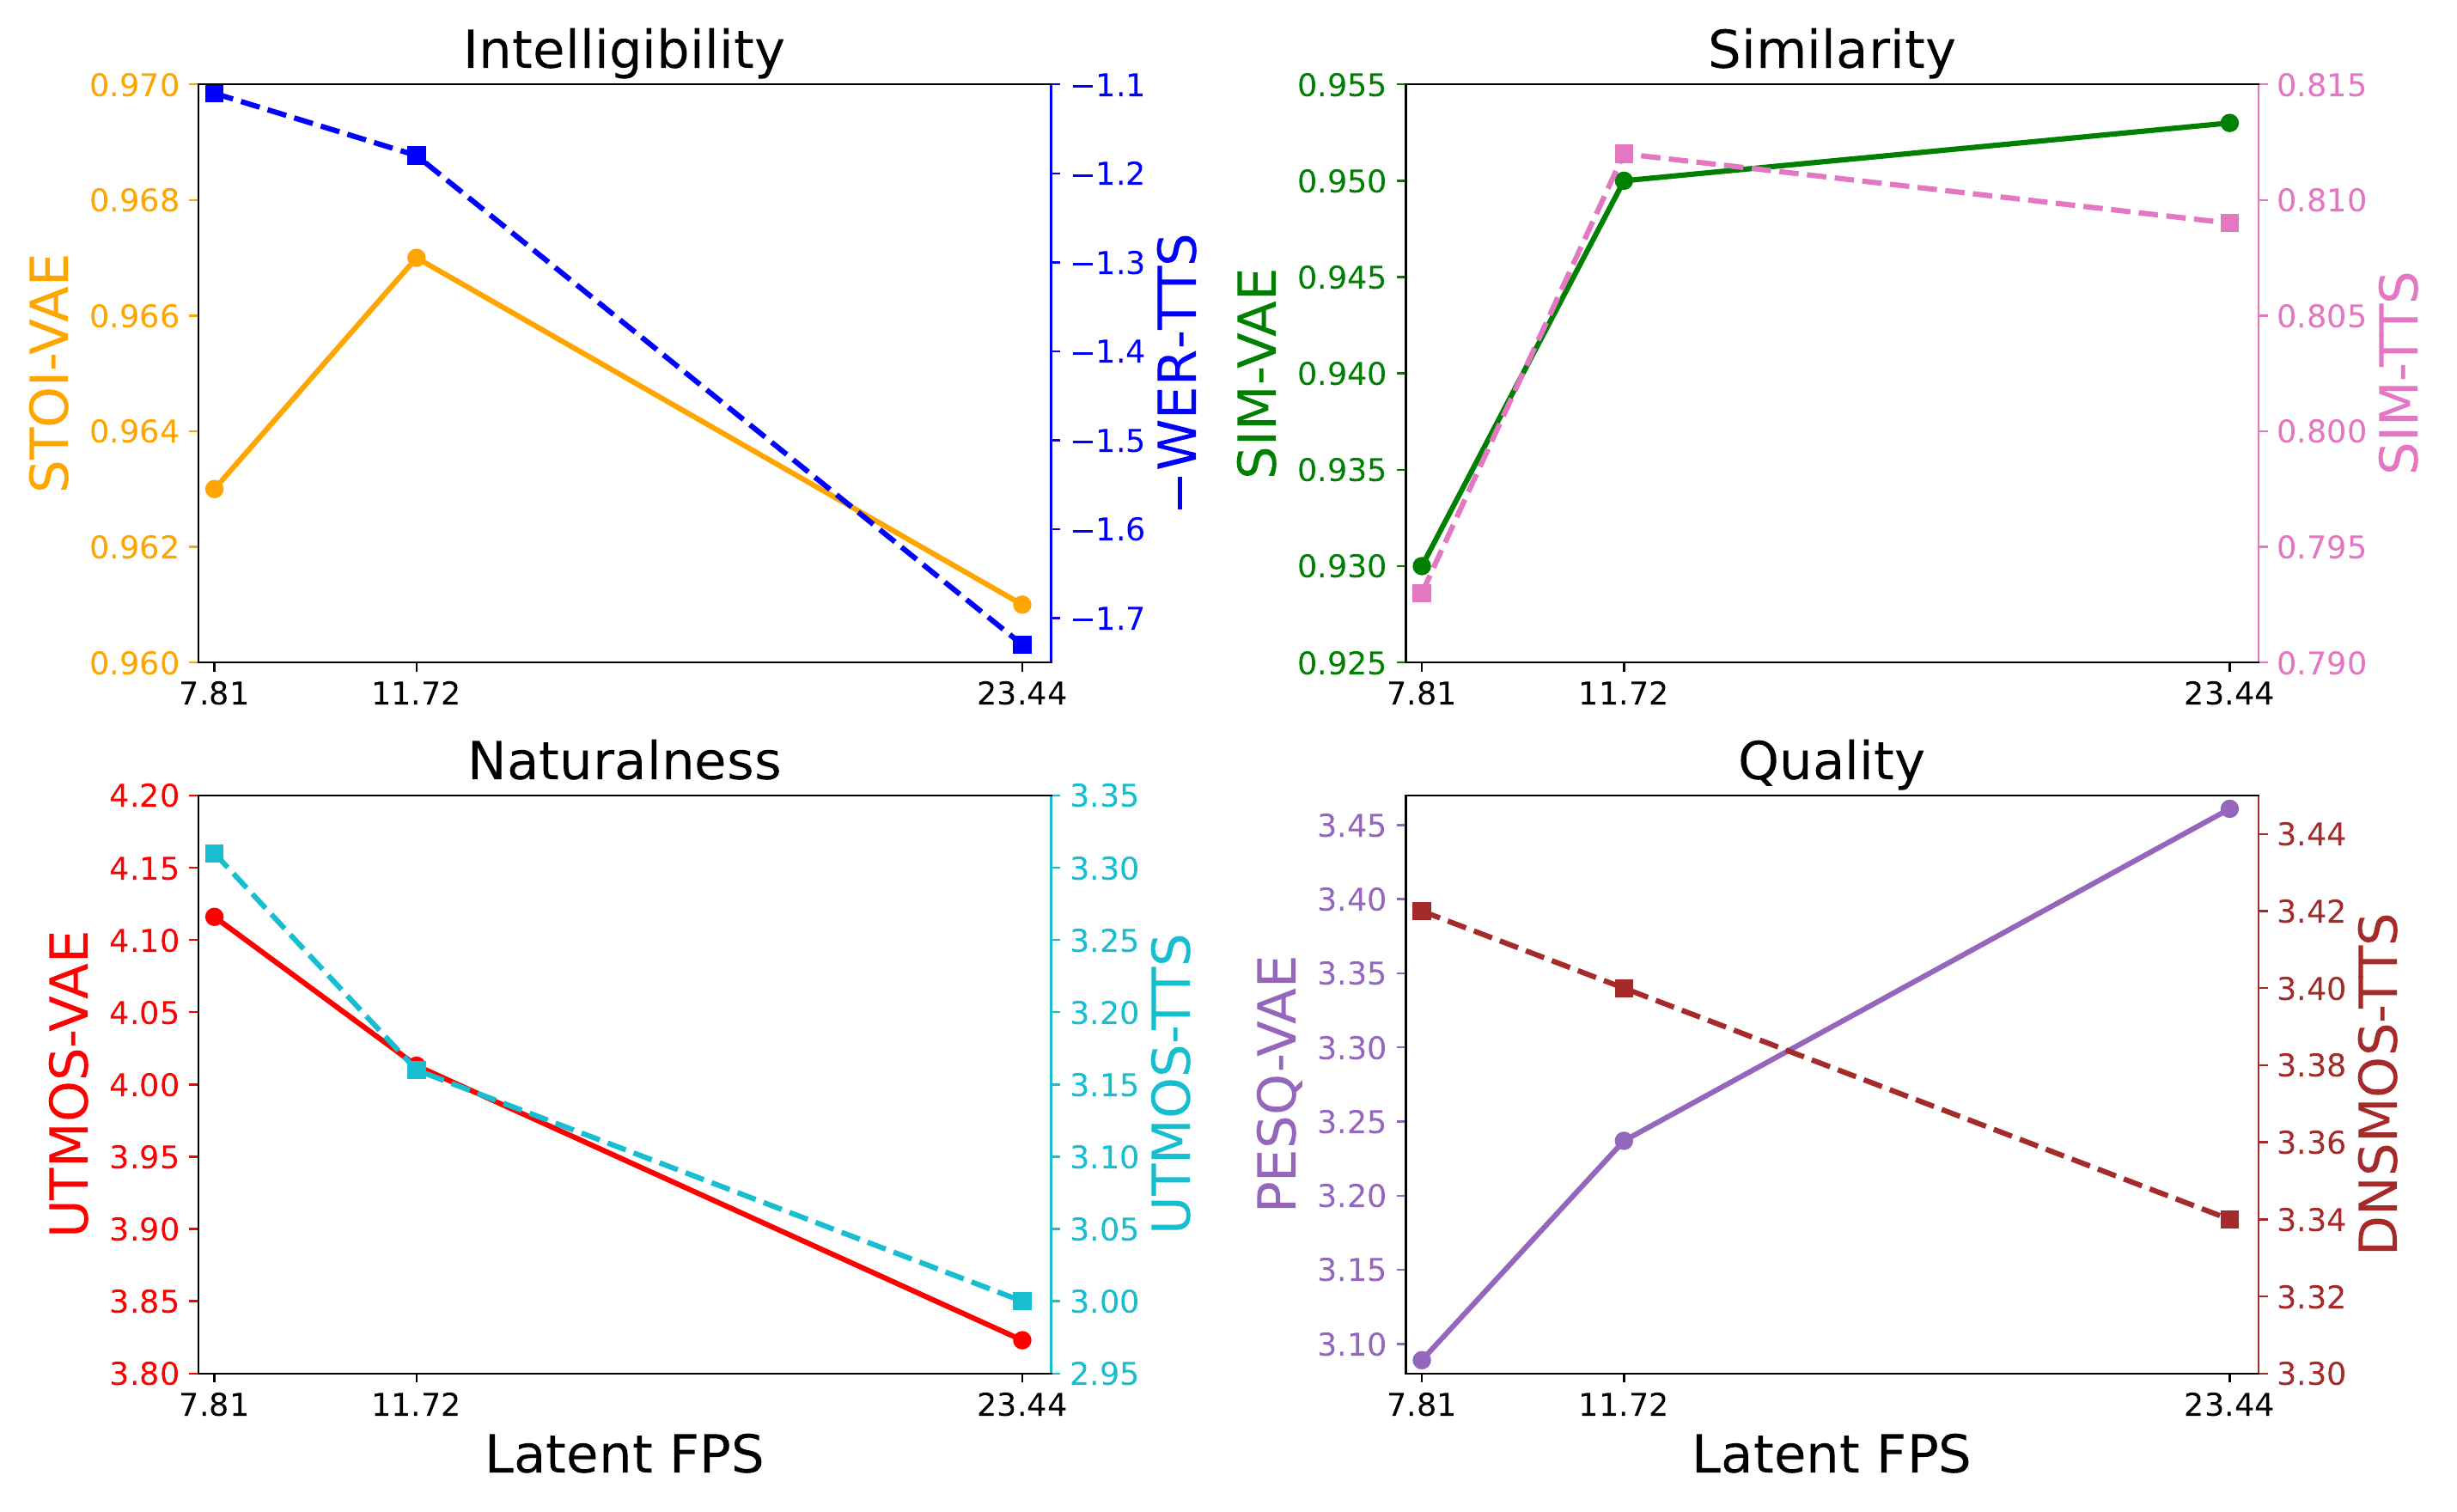
Ниже усреднены официальные столбцы ZH, EN и ZH-Hard SIM и включены только полные строки. Естественность и WER остаются отдельными вопросами.
| Модель | Средний SIM по трём разбиениям | Ещё проверить |
|---|---|---|
| LongCat-AudioDiT 3.5B | около 80.0 | WER, естественность и задержка |
| Qwen3-TTS | около 74.5 | дизайн голоса против клонирования |
| VoxCPM | около 74.4 | согласованность на длинных фрагментах и RTF |
Сохраняйте для одного и того же предложения результат без референса и результат с условием на референс. Проверяйте имена, числа и паузы раньше тембра, акцента и просодии. Если слушать только сходство, можно пропустить потерянные слова или скопированный шум.
Полезный референс короткий, чистый и с одним диктором. Несколько голосов, сильная реверберация и музыка смешивают индивидуальность с окружением; повторные прогоны одного текста показывают разброс по сходству, просодии и произношению.
Сходство дикторов измеряет близость эмбеддингов. Оно не доказывает личность и не даёт разрешения использовать голос. Инструмент предназначен для материала, который пользователь вправе обрабатывать.
Публичный репозиторий и карточка модели 3.5B вместе определяют опубликованные материалы. Цифры сходства привязаны к названным тестовым наборам и не заменяют отдельные проверки многоязычного произношения, устойчивости на длинных фрагментах и воспринимаемой естественности.
Названия моделей, числа и ограничения прослеживаются к статьям, репозиториям или карточкам моделей ниже.