Modèle
LongCat-AudioDiT 3.5B : Écrire les conditions des enceintes dans le transformateur de diffusion audio
Lecture intensive de l'article / Clonage vocal sans échantillon

Lecture intensive de l'article / Clonage vocal sans échantillon
LECTURE D'ARTICLE / CLONAGE VOCAL ZERO-SHOT
LongCat-AudioDiT 3.5B vise la synthèse vocale et le clonage zero-shot. Texte cible, référence de locuteur et indices prosodiques se rencontrent dans un transformer de diffusion qui génère des latents acoustiques. Ses chiffres de similarité publiés répondent à une question plus étroite que le naturel, le taux d'erreur de mots ou l'accent multilingue.
Un processus direct corrompt un latent acoustique propre x₀ en x_t. Conditionné par le texte et l'information de locuteur c, le réseau prédit le bruit ou la vélocité :
L=E ||ε−εθ(x_t,t,c)||²
Le chemin qualité publié utilise 32 évaluations de fonction. La synthèse non conditionnée recourt à CFG, tandis que le clonage par référence suit la méthode APG du projet pour réduire la sur-saturation sous guidage fort.
De nombreux systèmes zero-shot génèrent des unités acoustiques discrètes une à une. LongCat restaure plutôt une trajectoire acoustique continue avec un transformer de diffusion, tandis qu'UMT5 fournit les caractéristiques du texte et que la référence apporte identité et prosodie. Ce changement déplace l'accumulation d'erreurs de l'ordre des tokens vers le débruitage itératif et le guidage.
Le tableau officiel Seed rapporte trois splits de similarité de locuteur dont les valeurs 3.5B avoisinent 80.0 en moyenne. Ces lignes ne sont comparables qu'au sein du tableau nommé ; elles ne remplacent ni le MOS, ni le taux d'erreur de mots, ni l'accent inter-langues, ni la cohérence sur longue durée. Une voix peut sembler similaire tout en écorchant un nom.
Une référence utile est courte, propre et mono-locuteur. Plusieurs locuteurs, de la musique et une forte réverbération mélangent environnement et identité. La similarité vocale est une propriété de synthèse, pas un signal de vérification d'identité ni une permission d'usurper une personne.
Le clonage zero-shot s'est souvent appuyé sur des tokens audio discrets autorégressifs : un modèle prédit les unités acoustiques une à une pendant qu'une référence fournit le conditionnement du locuteur. LongCat-AudioDiT 3.5B restaure au contraire un latent acoustique continu avec un transformer de diffusion, en utilisant UMT5 pour le texte et la référence pour le timbre et la prosodie.
Bénéfice et coût découlent tous deux du débruitage global. La structure de la phrase peut être révisée le long de la trajectoire, mais 32 évaluations de fonction augmentent la latence. APG et CFG modifient aussi la saturation du timbre, la stabilité de la prononciation et le bruit de fond copié ; ils sont plus qu'un seul chiffre de guidage.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatent acoustique à l'étape tc_textcondition de textec_spkcondition de locuteur issue de la référenceCette notation générique de diffusion conditionnelle montre les conditions de texte et de locuteur entrer ensemble dans le débruiteur ; elle n'est pas présentée comme une équation ligne à ligne du dépôt. Trente-deux évaluations de fonction mettent le latent à jour de manière répétée.
Similarité du locuteur et exactitude du contenu sont deux axes distincts. Une référence bruitée peut transformer le son de la pièce en condition vocale, et une similarité élevée ne prouve ni noms, ni nombres, ni pauses corrects.
L'article, le code et les poids se suivent via Source LongCat-AudioDiT / Poids LongCat-AudioDiT 3.5B.
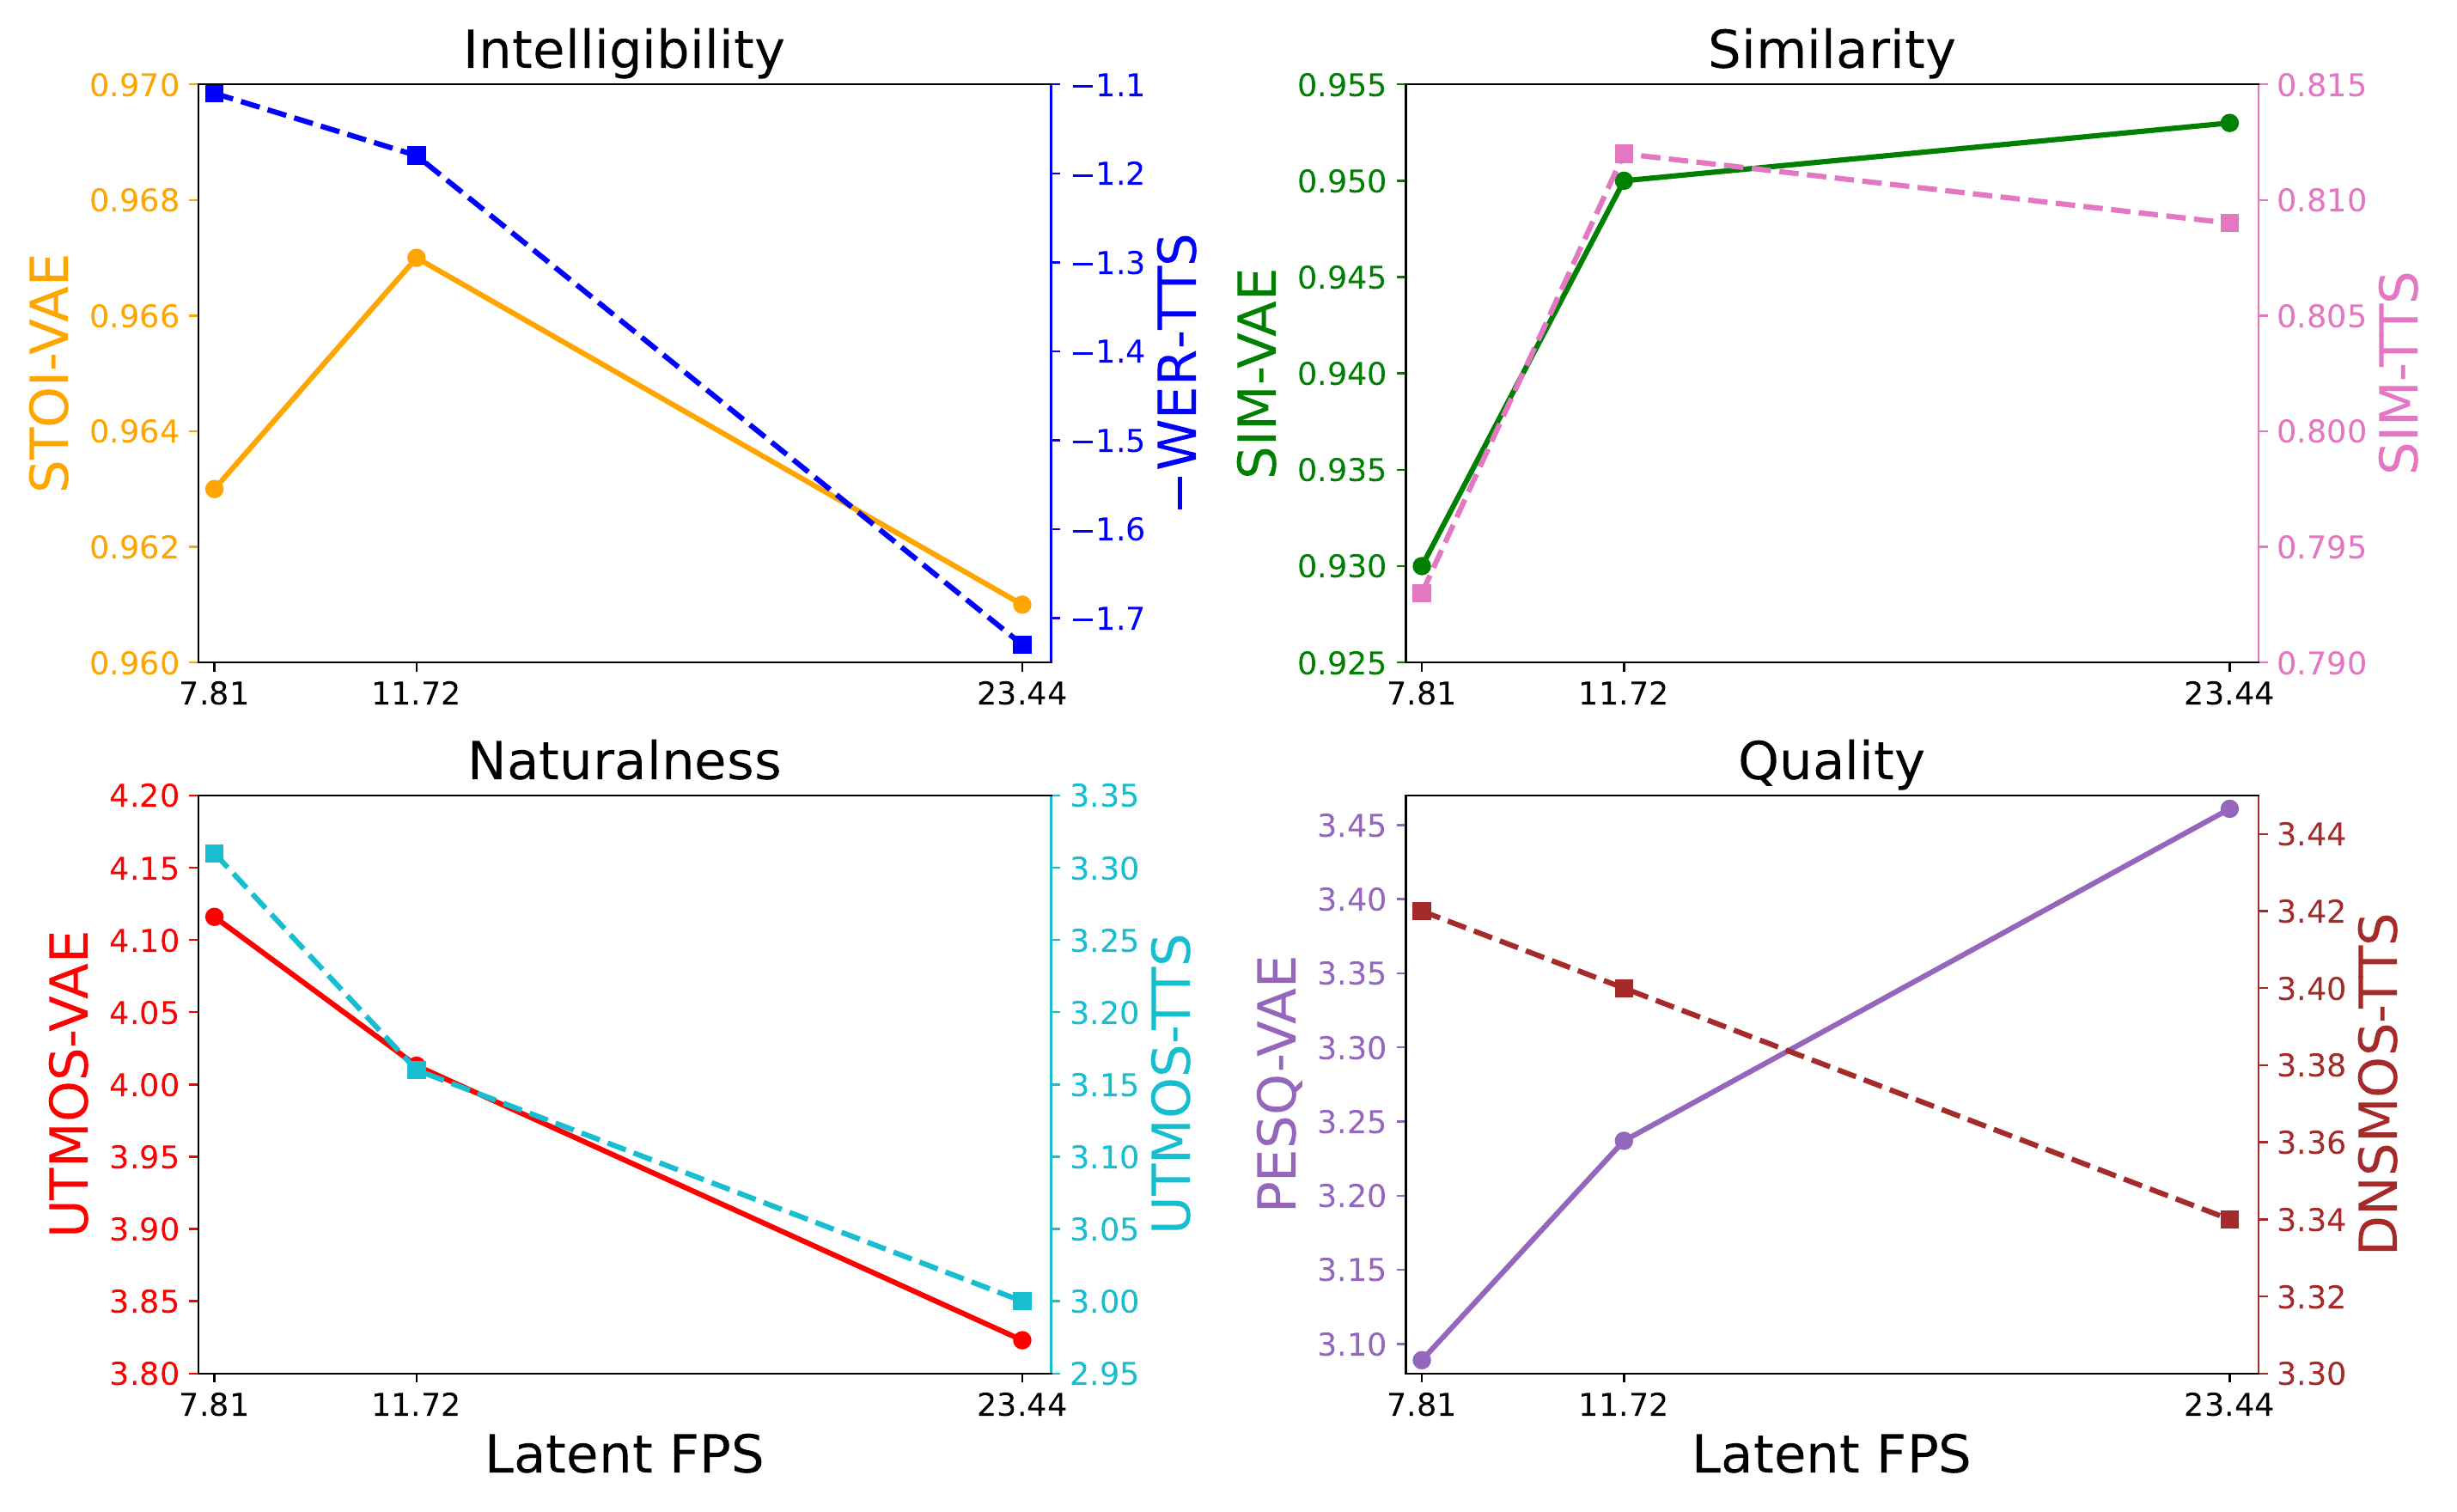
Les colonnes officielles ZH, EN et ZH-Hard SIM sont moyennées et seules les lignes complètes sont retenues. Naturel et WER restent des questions distinctes.
| Modèle | SIM moyen sur les trois splits | Reste à auditer |
|---|---|---|
| LongCat-AudioDiT 3.5B | environ 80.0 | WER, naturel et latence |
| Qwen3-TTS | environ 74.5 | conception de voix vs clonage |
| VoxCPM | environ 74.4 | cohérence longue durée et RTF |
Conservez la sortie sans référence et la sortie conditionnée par référence pour une même phrase. Vérifiez noms, nombres et pauses avant timbre, accent et prosodie. Une écoute centrée sur la seule ressemblance peut masquer des mots manquants ou un bruit copié.
Une référence utile est courte, propre et à un seul locuteur. Plusieurs voix, une forte réverbération et de la musique confondent identité et environnement ; des échantillons répétés du même texte révèlent la variance de la similarité, de la prosodie et de la prononciation.
La similarité de locuteur mesure une proximité d'embeddings. Elle ne prouve pas une identité et n'accorde pas la permission d'utiliser une voix. L'outil est destiné aux références que l'utilisateur est autorisé à traiter.
Le dépôt public et la fiche du modèle 3.5B établissent ensemble les éléments publiés. Les chiffres de similarité restent liés à leurs jeux de test nommés et ne remplacent pas des contrôles séparés de la prononciation multilingue, de la stabilité sur longue durée et du naturel perçu.
Les noms de modèles, les chiffres et les limites se rattachent aux publications, dépôts ou fiches de modèles ci-dessous.