Modell
LongCat-AudioDiT 3.5B: Lautsprecherbedingungen in den Audiodiffusionstransformer schreiben
Intensives Lesen des Artikels / Klonen von Stimmen ohne Samples

Intensives Lesen des Artikels / Klonen von Stimmen ohne Samples
PAPER-LEKTÜRE / ZERO-SHOT-STIMMKLONEN
LongCat-AudioDiT 3.5B zielt auf Text-to-Speech und Zero-Shot-Klonen. Zieltext, eine Sprecherreferenz und prosodische Hinweise treffen in einem Diffusion-Transformer zusammen, der akustische Latents erzeugt. Die veröffentlichten Ähnlichkeitswerte beantworten eine engere Frage als Natürlichkeit, Wortfehlerrate oder mehrsprachiger Akzent.
Ein Vorwärtsprozess stört ein sauberes akustisches Latent x₀ zu x_t. Konditioniert auf Text- und Sprecherinformationen c sagt das Netz Rauschen oder Geschwindigkeit voraus:
L=E ||ε−εθ(x_t,t,c)||²
Der veröffentlichte Qualitätspfad nutzt 32 Funktionsauswertungen. Unkonditionierte Synthese setzt auf CFG, während referenzbasiertes Klonen der APG-Methode des Projekts folgt, um Übersättigung unter starker Guidance zu reduzieren.
Viele Zero-Shot-Systeme erzeugen diskrete akustische Einheiten eine nach der anderen. LongCat stellt stattdessen eine kontinuierliche akustische Trajektorie mit einem Diffusion-Transformer wieder her; UMT5 liefert die Textmerkmale, die Referenz Identität und Prosodie. Der Wechsel verlagert die Fehlerakkumulation von der Token-Reihenfolge hin zu iterativem Denoising und Guidance.
Die offizielle Seed-Tabelle weist drei Sprecherähnlichkeits-Splits aus, deren 3.5B-Werte im Mittel etwa 80.0 erreichen. Diese Zeilen lassen sich nur innerhalb der genannten Tabelle vergleichen; sie ersetzen weder MOS noch Wortfehlerrate, sprachübergreifenden Akzent oder Konsistenz auf Langstrecken. Eine Stimme kann ähnlich klingen und einen Namen trotzdem falsch lesen.
Eine brauchbare Referenz ist kurz, sauber und einstimmig. Mehrere Sprecher, Musik und starker Hall vermischen Umgebung mit Identität. Stimmähnlichkeit ist eine Syntheseeigenschaft, kein Signal zur Identitätsprüfung und keine Erlaubnis, eine Person nachzuahmen.
Zero-Shot-Klonen hat häufig auf autoregressive, diskrete Audio-Tokens gesetzt: Ein Modell sagt akustische Einheiten nacheinander voraus, während eine Referenz die Sprecherkonditionierung liefert. LongCat-AudioDiT 3.5B stellt stattdessen ein kontinuierliches akustisches Latent mit einem Diffusion-Transformer wieder her — UMT5 für den Text, die Referenz für Klangfarbe und Prosodie.
Nutzen und Kosten folgen beide aus dem globalen Denoising. Die Satzstruktur lässt sich über die gesamte Trajektorie revidieren, doch 32 Funktionsauswertungen erhöhen die Latenz. APG und CFG verändern zudem die Sättigung der Klangfarbe, die Aussprachestabilität und mitkopierte Hintergrundgeräusche; sie sind mehr als eine einzelne Guidance-Zahl.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_takustisches Latent in Schritt tc_textTextbedingungc_spkSprecherbedingung aus der ReferenzDiese generische Notation konditionaler Diffusion zeigt, wie Text- und Sprecherbedingung gemeinsam in den Denoiser einfließen; sie versteht sich nicht als zeilengetreue Gleichung aus dem Repository. 32 Funktionsauswertungen aktualisieren das Latent wiederholt.
Sprecherähnlichkeit und inhaltliche Korrektheit sind getrennte Achsen. Eine verrauschte Referenz kann Raumklang zur Stimmbedingung machen, und hohe Ähnlichkeit beweist weder korrekte Namen noch Zahlen oder Pausen.
Paper, Code und Gewichte lassen sich über LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights nachverfolgen.
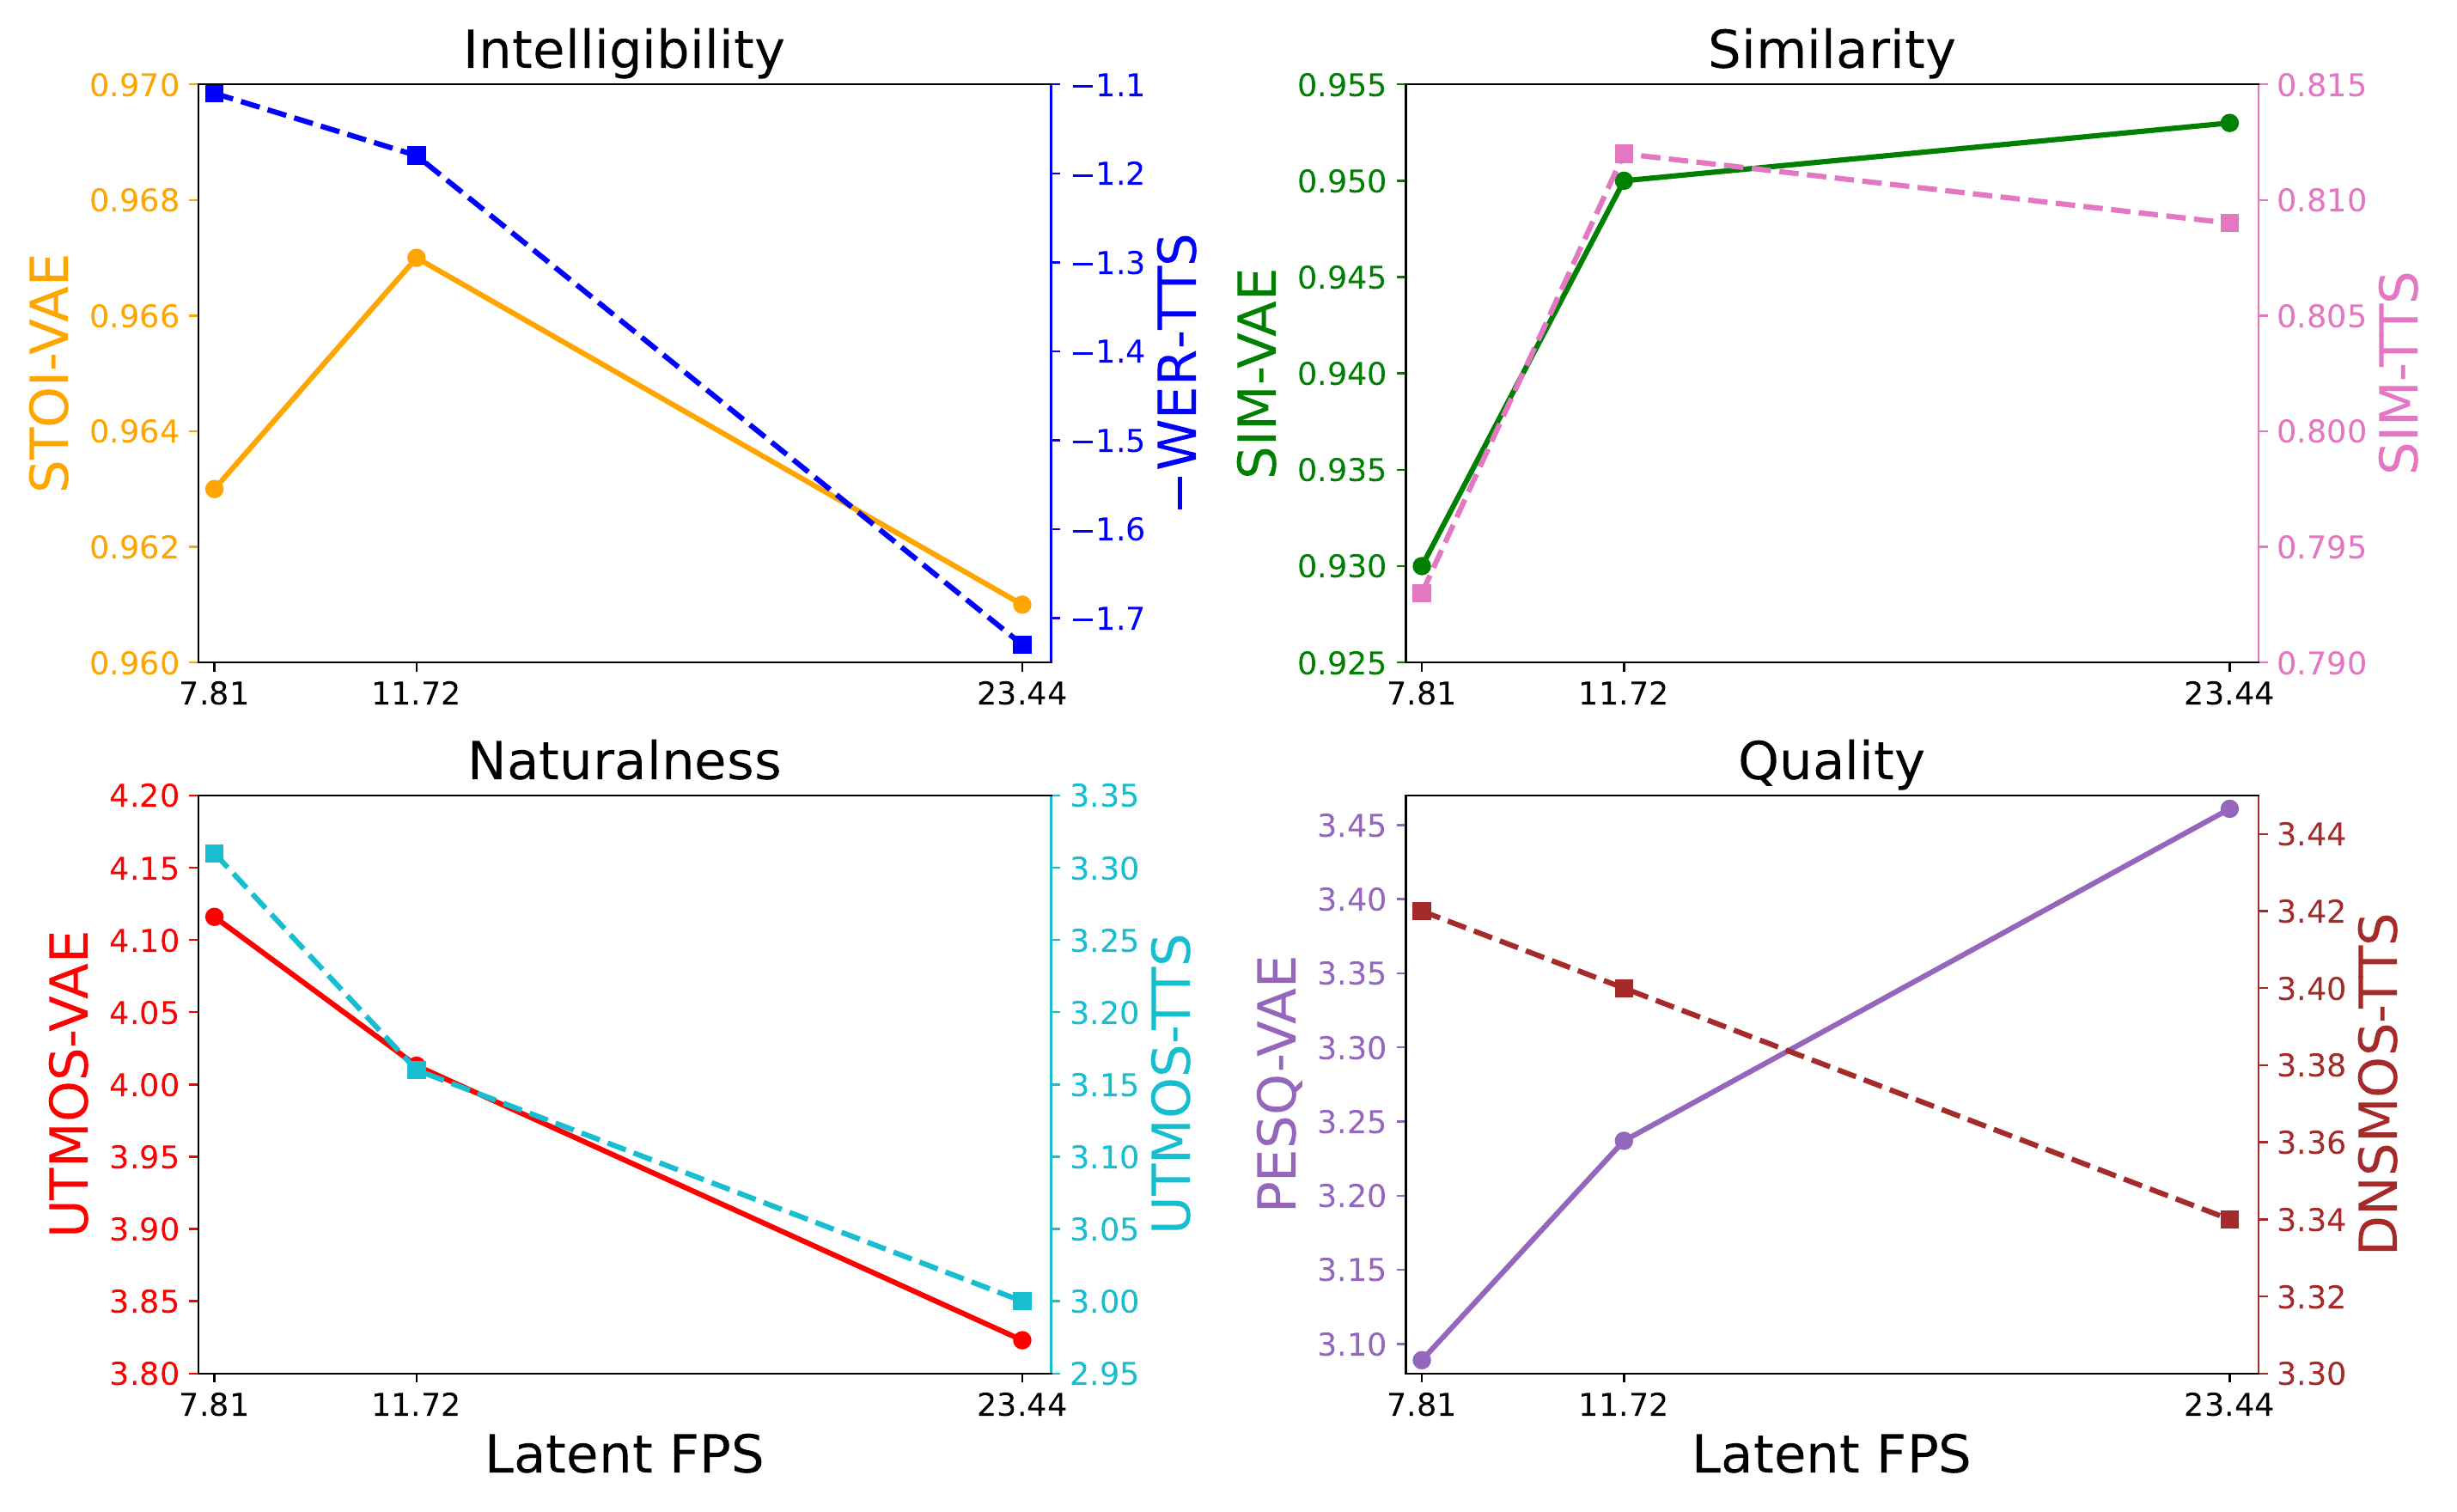
Gemittelt werden die offiziellen SIM-Spalten ZH, EN und ZH-Hard; einbezogen werden nur vollständige Zeilen. Natürlichkeit und WER bleiben eigenständige Fragen.
| Modell | SIM-Mittel über drei Splits | Noch zu prüfen |
|---|---|---|
| LongCat-AudioDiT 3.5B | etwa 80.0 | WER, Natürlichkeit und Latenz |
| Qwen3-TTS | etwa 74.5 | Stimmdesign versus Klonen |
| VoxCPM | etwa 74.4 | Langform-Kohärenz und RTF |
Zum selben Satz sollten sowohl die Ausgabe ohne Referenz als auch die referenzkonditionierte vorliegen. Namen, Zahlen und Pausen kommen vor Klangfarbe, Akzent und Prosodie an die Reihe. Wer nur auf die Ähnlichkeit hört, übersieht leicht fehlende Wörter oder mitkopierte Störgeräusche.
Eine brauchbare Referenz ist kurz, sauber und einstimmig. Mehrere Stimmen, starker Hall und Musik verschmelzen Identität mit Umgebung; wiederholte Proben desselben Textes machen die Varianz bei Ähnlichkeit, Prosodie und Aussprache sichtbar.
Sprecherähnlichkeit misst die Nähe von Embeddings. Sie beweist weder Identität noch erteilt sie die Erlaubnis, eine Stimme zu nutzen. Das Werkzeug richtet sich an Referenzmaterial, das der Nutzer verarbeiten darf.
Das öffentliche Repository und die Model Card zu 3.5B legen gemeinsam fest, welche Materialien veröffentlicht sind. Die Ähnlichkeitswerte bleiben an ihre benannten Testsets gebunden und ersetzen keine gesonderten Prüfungen mehrsprachiger Aussprache, Langform-Stabilität und wahrgenommener Natürlichkeit.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die untenstehenden Paper, Repositories oder Model Cards zurückführen.