Μοντέλο
LongCat-AudioDiT 3.5B: Εγγραφή συνθηκών ηχείων στον μετασχηματιστή διάχυσης ήχου
Εντατική ανάγνωση της εργασίας / Κλωνοποίηση φωνής μηδενικού δείγματος

Εντατική ανάγνωση της εργασίας / Κλωνοποίηση φωνής μηδενικού δείγματος
© 2026 TelkNet. Ολα τα δικαιώματα διατηρούνται.
ΑΝΑΓΝΩΣΗ ΔΗΜΟΣΙΕΥΣΗΣ / ZERO-SHOT ΚΛΩΝΟΠΟΙΗΣΗ ΦΩΝΗΣ
Το LongCat-AudioDiT 3.5B στοχεύει στη σύνθεση ομιλίας από κείμενο και σε zero-shot κλωνοποίηση. Το κείμενο-στόχος, ένα ηχητικό δείγμα αναφοράς του ομιλητή και προσωδιακές ενδείξεις συναντώνται μέσα σε έναν μετασχηματιστή διάχυσης που παράγει ακουστικά λανθάνοντα. Οι δημοσιευμένοι αριθμοί ομοιότητας απαντούν σε στενότερο ερώτημα από τη φυσικότητα, το ποσοστό σφαλμάτων λέξεων ή την προφορά σε πολλές γλώσσες.
Μια προς τα εμπρός διαδικασία αλλοιώνει ένα καθαρό ακουστικό λανθάνον x₀ σε x_t. Με συνθήκη το κείμενο και τις πληροφορίες ομιλητή c, το δίκτυο προβλέπει θόρυβο ή ταχύτητα:
L=E ||ε−εθ(x_t,t,c)||²
Η κυκλοφορημένη διαδρομή ποιότητας χρησιμοποιεί 32 αξιολογήσεις συνάρτησης. Η σύνθεση χωρίς συνθήκη αξιοποιεί CFG, ενώ η κλωνοποίηση με αναφορά ακολουθεί τη μέθοδο APG του έργου για να περιορίζεται ο υπερκορεσμός υπό ισχυρή καθοδήγηση.
Πολλά zero-shot συστήματα παράγουν διακριτές ακουστικές μονάδες μία προς μία. Το LongCat αντιθέτως αποκαθιστά μια συνεχή ακουστική τροχιά με έναν μετασχηματιστή διάχυσης, ενώ το UMT5 προσφέρει τα χαρακτηριστικά κειμένου και η αναφορά την ταυτότητα και την προσωδία. Η αλλαγή μετατοπίζει τη συσσώρευση σφαλμάτων από τη σειρά των tokens προς την επαναληπτική αποθορυβοποίηση και την καθοδήγηση.
Ο επίσημος πίνακας Seed καταγράφει τρεις διαχωρισμούς ομοιότητας ομιλητή, των οποίων οι τιμές για το 3.5B καταλήγουν σε μέσο όρο γύρω στο 80.0. Οι γραμμές αυτές συγκρίνονται μόνο εντός του συγκεκριμένου πίνακα· δεν αντικαθιστούν το MOS, το ποσοστό σφαλμάτων λέξεων, την προφορά μεταξύ γλωσσών ή τη συνοχή σε μακρά αποσπάσματα. Μια φωνή μπορεί να ακούγεται όμοια και ταυτόχρονα να διαβάζει λάθος ένα όνομα.
Ένα χρήσιμο δείγμα-προτροπή είναι σύντομο, καθαρό και με έναν μόνο ομιλητή. Πολλοί ομιλητές, μουσική και έντονη αντήχηση αναμειγνύουν το περιβάλλον με την ταυτότητα της φωνής. Η ομοιότητα φωνής είναι ιδιότητα της σύνθεσης, όχι σήμα επαλήθευσης ταυτότητας ούτε άδεια να μιμηθεί κανείς ένα πρόσωπο.
Η zero-shot κλωνοποίηση συχνά στηριζόταν σε αυτοπαλίδρομα διακριτά tokens ήχου: ένα μοντέλο προβλέπει ακουστικές μονάδες διαδοχικά, ενώ ένα δείγμα αναφοράς παρέχει τη συνθήκη του ομιλητή. Το LongCat-AudioDiT 3.5B αντιθέτως αποκαθιστά ένα συνεχές ακουστικό λανθάνον με μετασχηματιστή διάχυσης, χρησιμοποιώντας το UMT5 για το κείμενο και την αναφορά για τον ηχόχρωμα και την προσωδία.
Το όφελος και το κόστος πηγάζουν και τα δύο από την καθολική αποθορυβοποίηση. Η δομή της πρότασης μπορεί να αναθεωρηθεί σε όλη την τροχιά, αλλά οι 32 αξιολογήσεις συνάρτησης αυξάνουν την καθυστέρηση. Τα APG και CFG μεταβάλλουν επίσης τον κορεσμό του ηχόχρωμα, τη σταθερότητα της προφοράς και τον αντιγραφόμενο θόρυβο του υποβάθρου· είναι κάτι περισσότερο από έναν μεμονωμένο αριθμό καθοδήγησης.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tακουστικό λανθάνον στο βήμα tc_textσυνθήκη κειμένουc_spkσυνθήκη ομιλητή από την αναφοράΑυτός ο γενικός συμβολισμός συνθετικής διάχυσης δείχνει τις συνθήκες κειμένου και ομιλητή να εισέρχονται μαζί στον αποθορυβοποιητή· δεν παρουσιάζεται ως εξίσωση του αποθετηρίου γραμμή προς γραμμή. Τριάντα δύο αξιολογήσεις συνάρτησης ενημερώνουν επαναληπτικά το λανθάνον.
Η ομοιότητα ομιλητή και η ορθότητα του περιεχομένου αποτελούν ξεχωριστούς άξονες. Ένα θορυβώδες δείγμα-προτροπή μπορεί να μετατρέψει τον ήχο του δωματίου σε συνθήκη φωνής, και η υψηλή ομοιότητα δεν αποδεικνύει σωστά ονόματα, αριθμούς ή παύσεις.
Η δημοσίευση, ο κώδικας και τα βάρη παρακολουθούνται μέσω LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
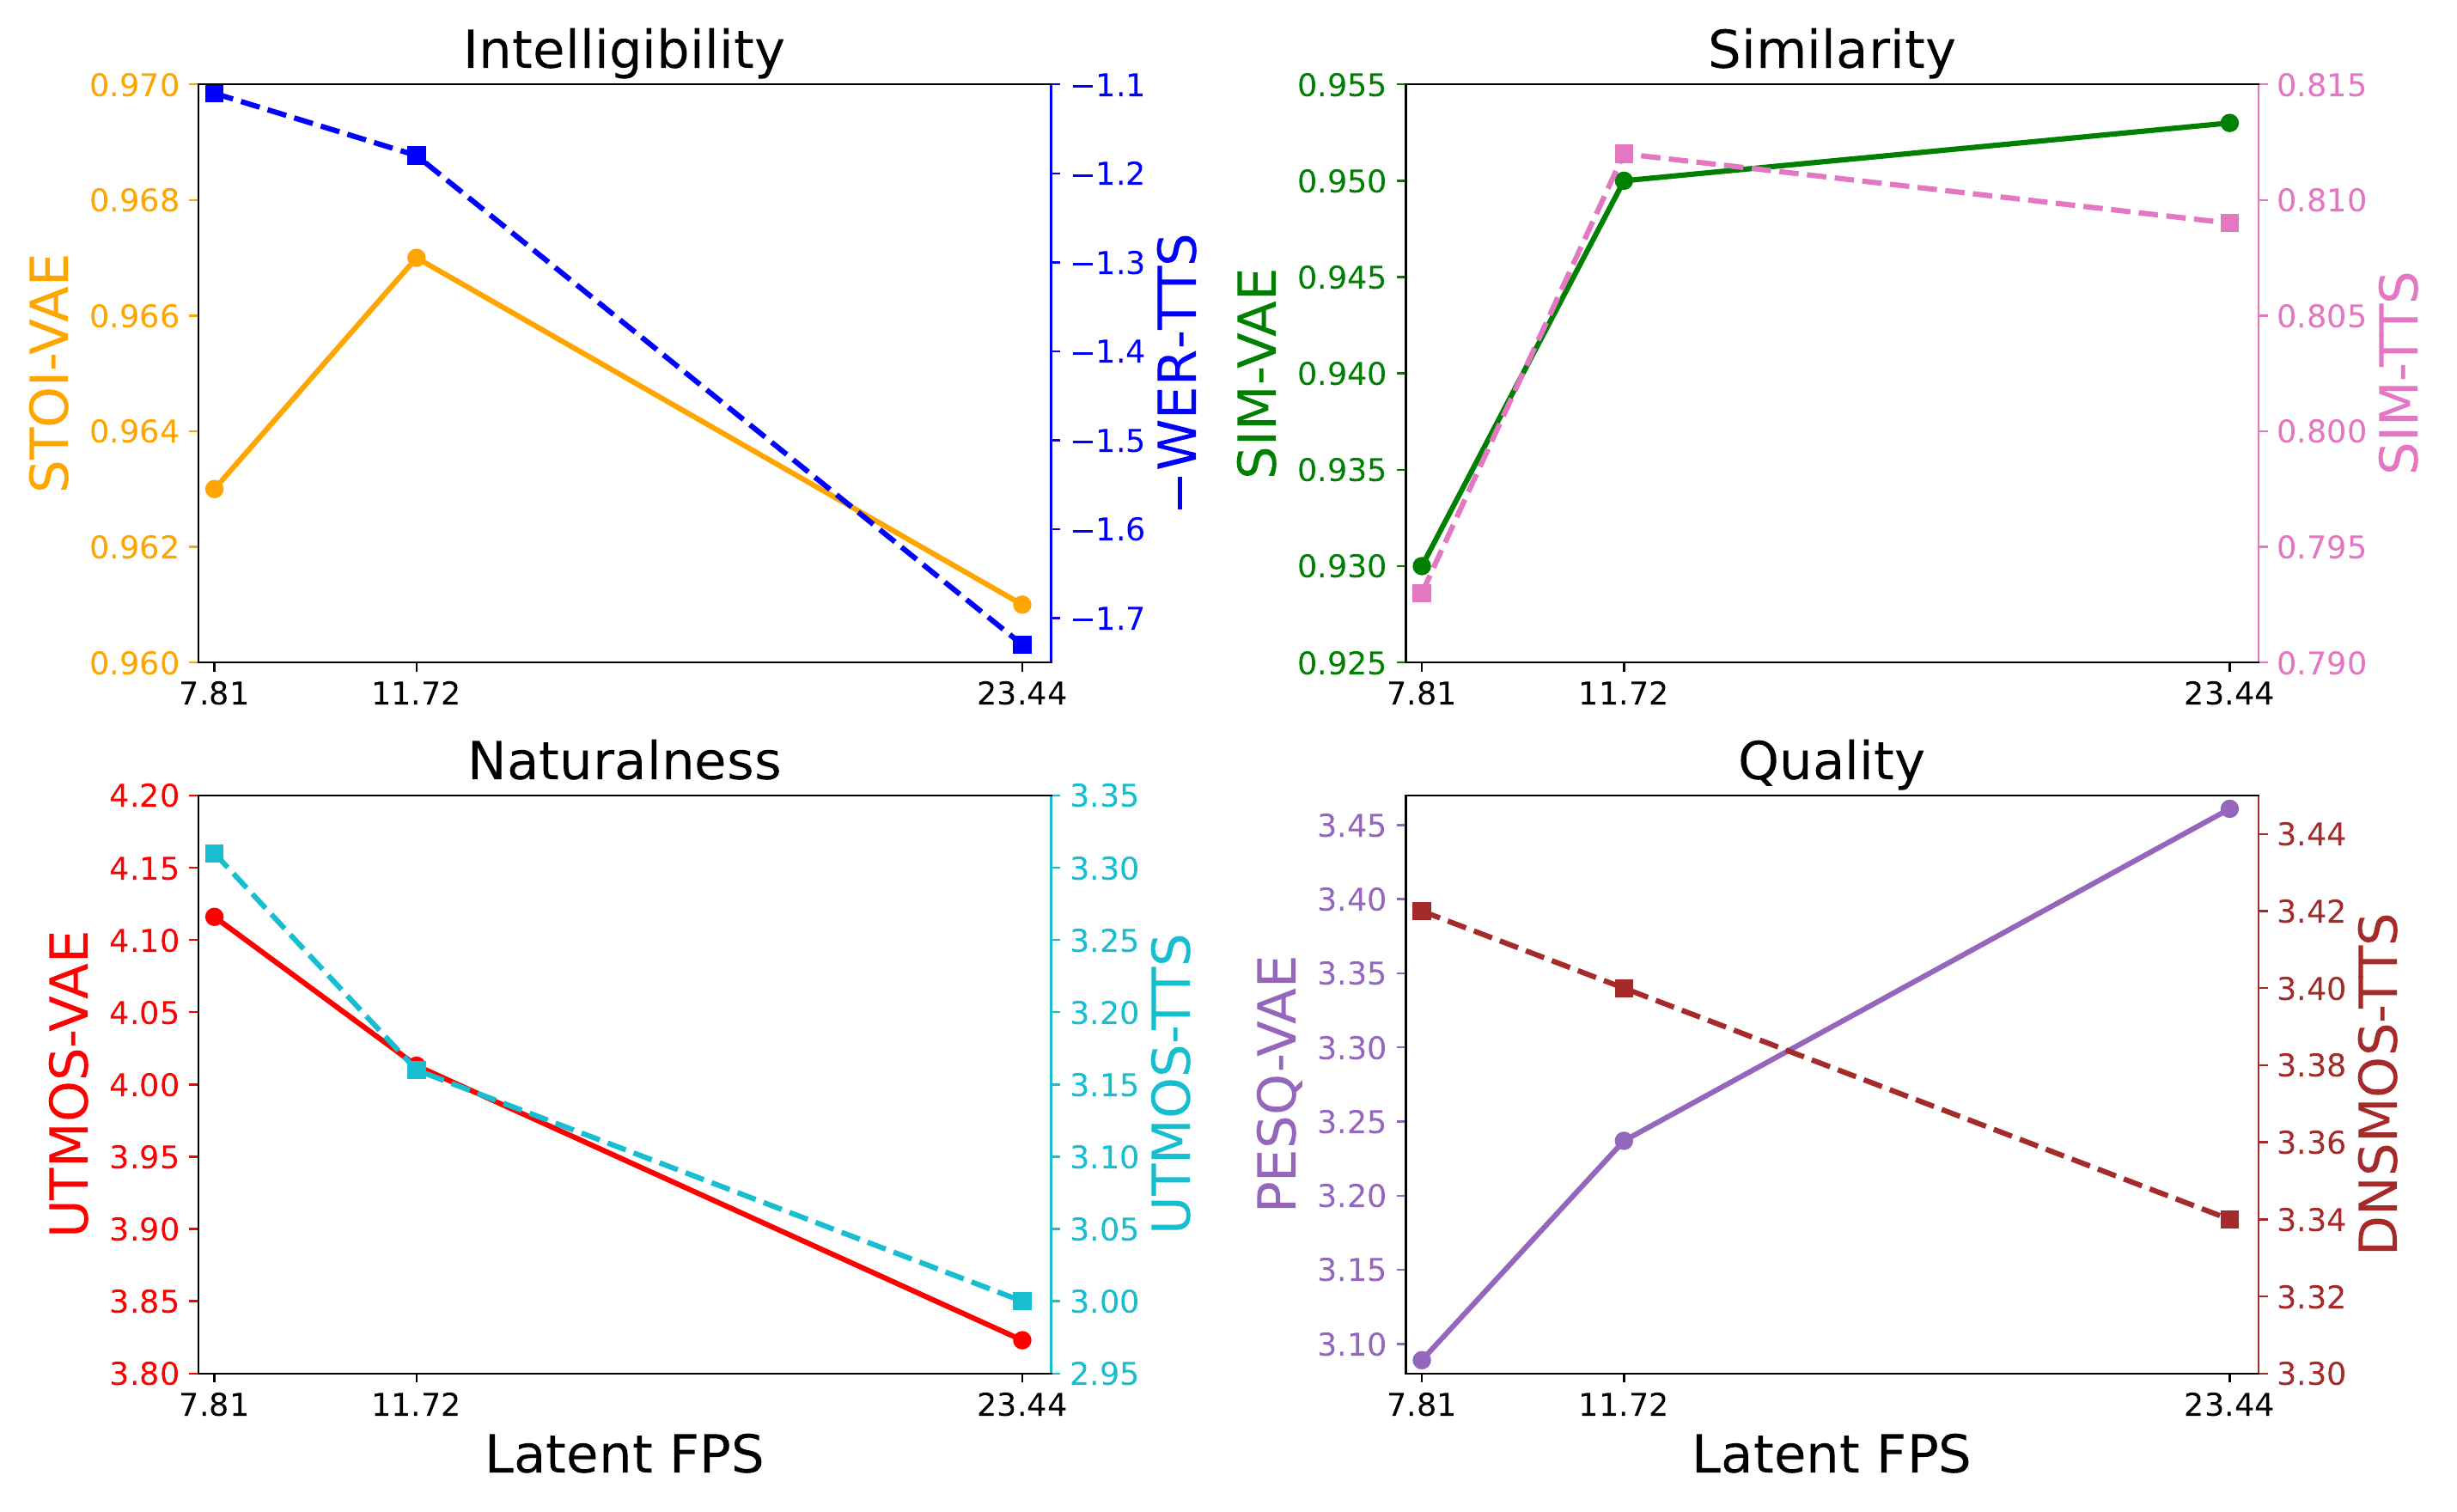
Οι επίσημες στήλες SIM ZH, EN και ZH-Hard μεσοσταθμίζονται εδώ και συμπεριλαμβάνονται μόνο πλήρεις γραμμές. Η φυσικότητα και το WER παραμένουν ξεχωριστά ερωτήματα.
| Μοντέλο | Μέση SIM τριών διαχωρισμών | Ακόμη υπό έλεγχο |
|---|---|---|
| LongCat-AudioDiT 3.5B | περίπου 80.0 | WER, φυσικότητα και καθυστέρηση |
| Qwen3-TTS | περίπου 74.5 | σχεδιασμός φωνής έναντι κλωνοποίησης |
| VoxCPM | περίπου 74.4 | συνοχή μακράς μορφής και RTF |
Κρατήστε τόσο την έξοδο χωρίς αναφορά όσο και αυτήν με συνθήκη αναφοράς για την ίδια πρόταση. Ελέγξτε ονόματα, αριθμούς και παύσεις πριν από τον ηχόχρωμα, την προφορά και την προσωδία. Η ακρόαση μόνο για ομοιότητα μπορεί να κρύψει λέξεις που λείπουν ή αντιγραμμένο θόρυβο.
Μια χρήσιμη αναφορά είναι σύντομη, καθαρή και μονοφωνική. Πολλές φωνές, έντονη αντήχηση και μουσική αναμιγνύουν την ταυτότητα με το περιβάλλον· επαναλαμβανόμενα δείγματα του ίδιου κειμένου αποκαλύπτουν διακύμανση σε ομοιότητα, προσωδία και προφορά.
Η ομοιότητα ομιλητή μετρά την εγγύτητα embeddings. Ούτε αποδεικνύει ταυτότητα ούτε παραχωρεί άδεια χρήσης μιας φωνής. Το εργαλείο προορίζεται για υλικό αναφοράς που ο χρήστης δικαιούται να επεξεργάζεται.
Το δημόσιο αποθετήριο και η κάρτα μοντέλου του 3.5B μαζί καθορίζουν τα κυκλοφορημένα υλικά. Οι αριθμοί ομοιότητας παραμένουν δεσμευμένοι στα συγκεκριμένα σύνολα δοκιμών και δεν αντικαθιστούν ξεχωριστούς ελέγχους προφοράς σε πολλές γλώσσες, σταθερότητας μακράς μορφής και αντιληπτής φυσικότητας.
Τα ονόματα μοντέλων, οι αριθμοί και οι περιορισμοί ανάγονται στις δημοσιεύσεις, τα αποθετήρια ή τις κάρτες μοντέλων που ακολουθούν.