Modelo
LongCat-AudioDiT 3.5B: escribir las condiciones del altavoz en el transformador de difusión de audio
Lectura intensiva del artículo / Clonación de voz de muestra cero

Lectura intensiva del artículo / Clonación de voz de muestra cero
LECTURA DE PAPER / CLONACIÓN DE VOZ ZERO-SHOT
LongCat-AudioDiT 3.5B apunta a la síntesis texto a voz y a la clonación zero-shot. El texto de destino, una referencia de hablante y las pistas prosódicas confluyen en un transformador de difusión que genera latentes acústicos. Sus cifras de similitud publicadas responden a una pregunta más estrecha que la naturalidad, la tasa de error de palabra o el acento multilingüe.
Un proceso directo corrompe un latente acústico limpio x₀ hasta convertirlo en x_t. Condicionada por el texto y la información del hablante c, la red predice el ruido o la velocidad:
L=E ||ε−εθ(x_t,t,c)||²
La ruta de calidad publicada usa 32 evaluaciones de función. La síntesis no condicionada recurre a CFG, mientras que la clonación con referencia sigue el método APG del proyecto para reducir la sobresaturación bajo una guía fuerte.
Muchos sistemas zero-shot generan unidades acústicas discretas una a una. LongCat, en cambio, restaura una trayectoria acústica continua con un transformador de difusión, mientras UMT5 aporta los rasgos de texto y la referencia aporta identidad y prosodia. El cambio desplaza la acumulación de errores del orden de los tokens hacia la reducción iterativa de ruido y la guía.
La tabla oficial de Seed recoge tres divisiones de similitud de hablante cuyos valores de 3.5B promedian unos 80.0. Esas filas solo pueden compararse dentro de la tabla citada; no sustituyen al MOS, a la tasa de error de palabra, al acento entre idiomas ni a la consistencia en formato largo. Una voz puede sonar parecida y aun así leer mal un nombre.
Una referencia útil es corta, limpia y de un solo hablante. Varios hablantes, música o una reverberación fuerte mezclan el entorno con la identidad. La similitud de voz es una propiedad de la síntesis, no una señal de verificación de identidad ni un permiso para suplantar a una persona.
La clonación zero-shot se ha apoyado a menudo en tokens de audio discretos autorregresivos: un modelo predice unidades acústicas una a una mientras una referencia aporta el condicionamiento del hablante. LongCat-AudioDiT 3.5B, en cambio, restaura un latente acústico continuo con un transformador de difusión, usando UMT5 para el texto y la referencia para el timbre y la prosodia.
El beneficio y el coste derivan de la reducción global de ruido. La estructura de la frase puede revisarse a lo largo de la trayectoria, pero las 32 evaluaciones de función aumentan la latencia. APG y CFG también modifican la saturación del timbre, la estabilidad de la pronunciación y el ruido de fondo copiado; son más que una única cifra de guía.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatente acústico en el paso tc_textcondición de textoc_spkcondición de hablante tomada de la referenciaEsta notación genérica de difusión condicional muestra las condiciones de texto y de hablante entrando juntas en el denoiser; no se presenta como una ecuación literal del repositorio. Treinta y dos evaluaciones de función actualizan el latente una y otra vez.
La similitud de hablante y la corrección del contenido son ejes distintos. Una referencia ruidosa puede convertir el sonido de la sala en una condición de voz, y una similitud alta no demuestra nombres, números o pausas correctos.
El artículo, el código y los pesos pueden consultarse en LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
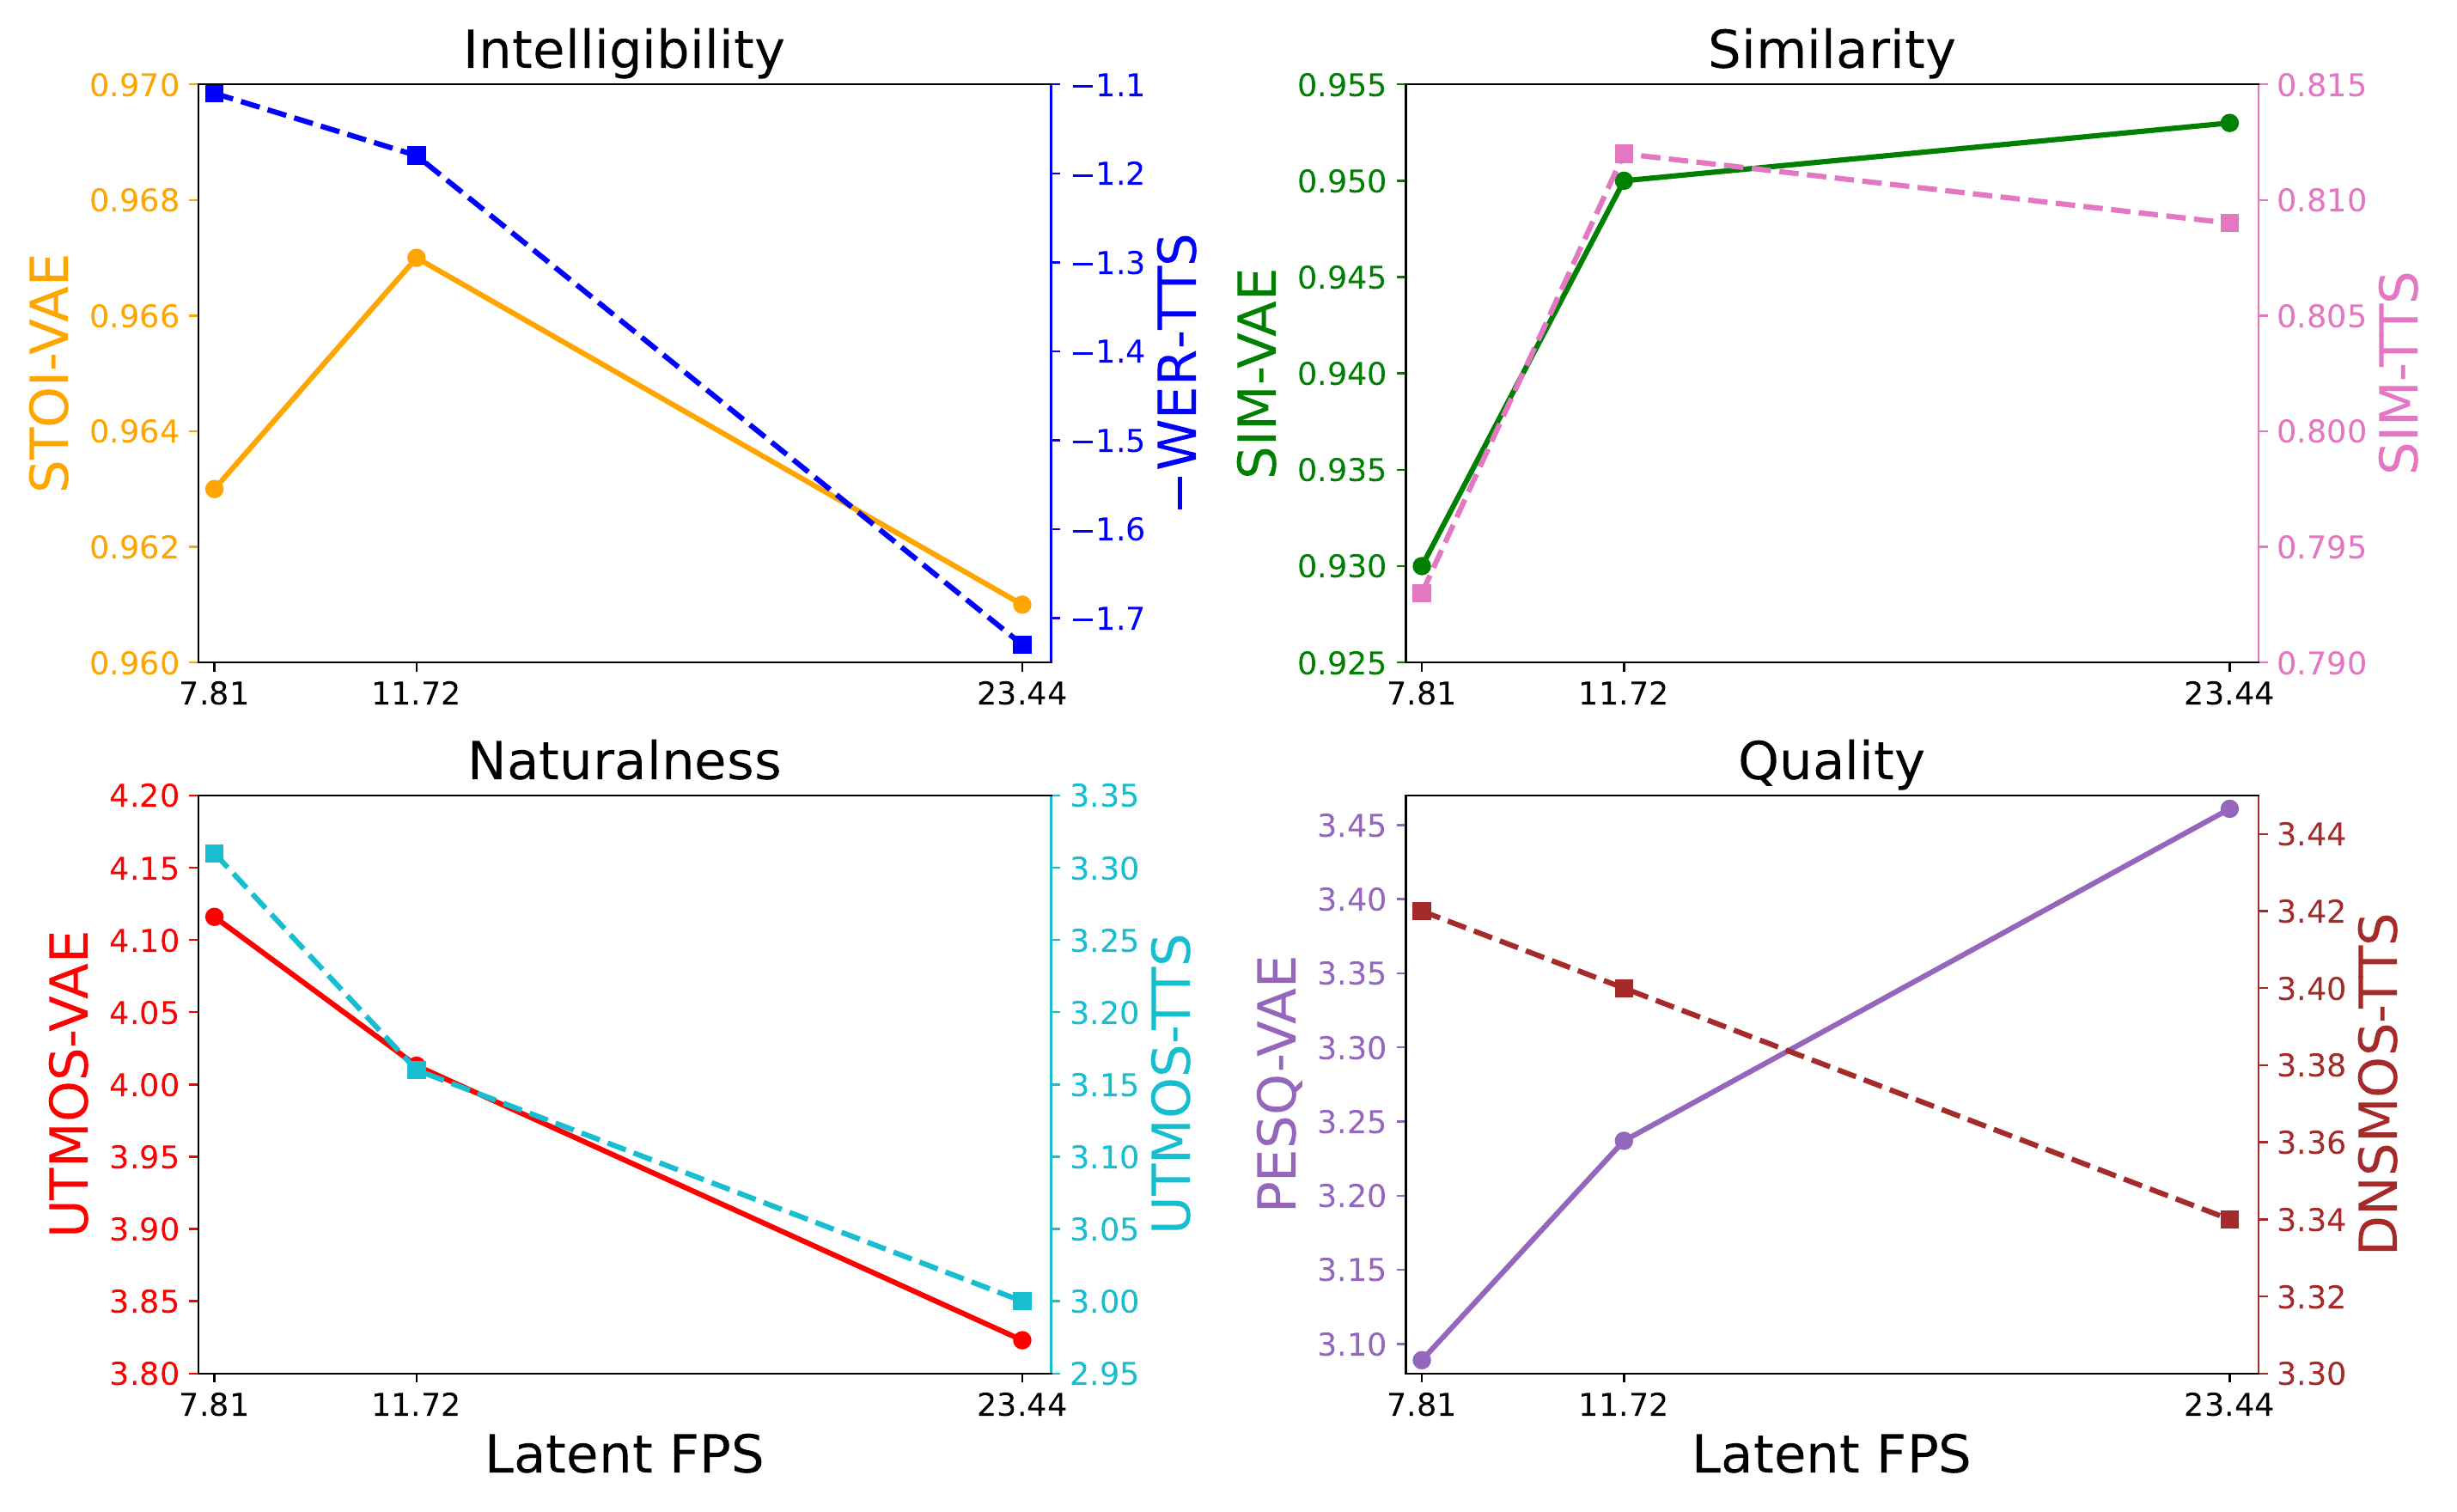
Se promedian las columnas oficiales SIM de ZH, EN y ZH-Hard y solo se incluyen filas completas. La naturalidad y el WER siguen siendo cuestiones aparte.
| Modelo | SIM medio de las tres divisiones | Aún por auditar |
|---|---|---|
| LongCat-AudioDiT 3.5B | unos 80.0 | WER, naturalidad y latencia |
| Qwen3-TTS | unos 74.5 | diseño de voz frente a clonación |
| VoxCPM | unos 74.4 | coherencia en formato largo y RTF |
Conviene conservar la salida sin referencia y la condicionada por referencia para la misma frase. Revisar nombres, números y pausas antes que timbre, acento y prosodia. Escuchar solo el parecido puede ocultar palabras ausentes o ruido copiado.
Una referencia útil es corta, limpia y de un solo hablante. Varias voces, una reverberación fuerte y música mezclan la identidad con el entorno; las muestras repetidas del mismo texto revelan la varianza en similitud, prosodia y pronunciación.
La similitud de hablante mide proximidad de embeddings. Ni prueba la identidad ni concede permiso para usar una voz. La herramienta está pensada para material de referencia que el usuario tiene derecho a procesar.
El repositorio público y la ficha del modelo 3.5B definen en conjunto los materiales publicados. Las cifras de similitud permanecen ligadas a sus conjuntos de prueba nombrados y no sustituyen comprobaciones separadas de pronunciación multilingüe, estabilidad en formato largo y naturalidad percibida.
Los nombres de modelos, las cifras y las limitaciones se remiten a los artículos, repositorios o fichas de modelo siguientes.