Mô hình
LongCat-AudioDiT 3.5B: Ghi điều kiện loa vào khuếch tán âm thanh
Đọc báo chuyên sâu / Nhân bản giọng nói không mẫu

Đọc báo chuyên sâu / Nhân bản giọng nói không mẫu
ĐỌC BÀI BÁO / NHÂN BẢN GIỌNG NÓI ZERO-SHOT
LongCat-AudioDiT 3.5B hướng tới tổng hợp văn bản thành giọng nói và nhân bản zero-shot. Văn bản đích, mẫu giọng tham chiếu và các dấu hiệu ngữ điệu gặp nhau bên trong một transformer khuếch tán tạo ra latent âm học. Các con số tương đồng đã công bố chỉ trả lời một câu hỏi hẹp hơn nhiều so với độ tự nhiên, lỗi từ hay trọng âm đa ngôn ngữ.
Một tiến trình thuận làm nhiễu latent âm học sạch x₀ thành x_t. Với điều kiện là thông tin văn bản và người nói c, mạng dự đoán nhiễu hoặc vận tốc:
L=E ||ε−εθ(x_t,t,c)||²
Đường xử lý chất lượng đã phát hành dùng 32 lần đánh giá hàm. Tổng hợp không điều kiện dùng CFG, còn nhân bản dựa trên tham chiếu đi theo phương pháp APG của dự án để giảm quá bão hòa khi dẫn hướng mạnh.
Nhiều hệ thống zero-shot sinh từng đơn vị âm học rời rạc một. LongCat thay vào đó khôi phục một quỹ đạo âm học liên tục bằng transformer khuếch tán, trong khi UMT5 cung cấp đặc trưng văn bản và mẫu tham chiếu cung cấp bản sắc cùng ngữ điệu. Thay đổi này chuyển việc tích lũy lỗi từ thứ tự token sang quá trình khử nhiễu lặp và dẫn hướng.
Bảng Seed chính thức báo cáo ba nhóm đo độ tương đồng người nói, trong đó các giá trị của bản 3.5B trung bình khoảng 80.0. Những hàng đó chỉ có thể so sánh trong phạm vi bảng đã nêu; chúng không thay thế MOS, lỗi từ, trọng âm chéo ngôn ngữ hay độ nhất quán khi đọc dài. Một giọng nói có thể nghe giống nhưng vẫn đọc sai tên riêng.
Một mẫu nhắc hữu ích cần ngắn, sạch và chỉ có một người nói. Nhiều người nói, nhạc nền và tiếng vang mạnh sẽ trộn lẫn môi trường với bản sắc giọng. Độ tương đồng giọng là thuộc tính của việc tổng hợp, không phải tín hiệu xác minh danh tính cũng không phải sự cho phép giả mạo ai đó.
Nhân bản zero-shot từ lâu thường dùng các token âm thanh rời rạc tự hồi quy: mô hình dự đoán từng đơn vị âm học một trong khi mẫu tham chiếu cung cấp điều kiện người nói. LongCat-AudioDiT 3.5B thay vào đó khôi phục một latent âm học liên tục bằng transformer khuếch tán, dùng UMT5 cho văn bản và dùng mẫu tham chiếu cho âm sắc cùng ngữ điệu.
Lợi ích và chi phí đều bắt nguồn từ việc khử nhiễu toàn cục. Cấu trúc câu có thể được chỉnh sửa dọc quỹ đạo, nhưng 32 lần đánh giá hàm làm tăng độ trễ. APG và CFG cũng làm thay đổi độ bão hòa âm sắc, độ ổn định phát âm và nhiễu nền bị sao chép; chúng không chỉ là một con số dẫn hướng đơn lẻ.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatent âm học tại bước tc_textđiều kiện văn bảnc_spkđiều kiện người nói từ mẫu tham chiếuKý hiệu khuếch tán có điều kiện tổng quát này cho thấy điều kiện văn bản và người nói cùng đi vào bộ khử nhiễu; nó không được trình bày như một phương trình nguyên văn từng dòng trong kho mã. Ba mươi hai lần đánh giá hàm cập nhật latent một cách lặp lại.
Độ tương đồng người nói và độ chính xác nội dung là hai trục tách biệt. Một mẫu nhắc nhiễu có thể biến âm thanh phòng thành điều kiện giọng, và độ tương đồng cao không chứng minh tên riêng, con số hay ngắt nghỉ được đọc đúng.
Bài báo, mã nguồn và trọng số có thể tra theo LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
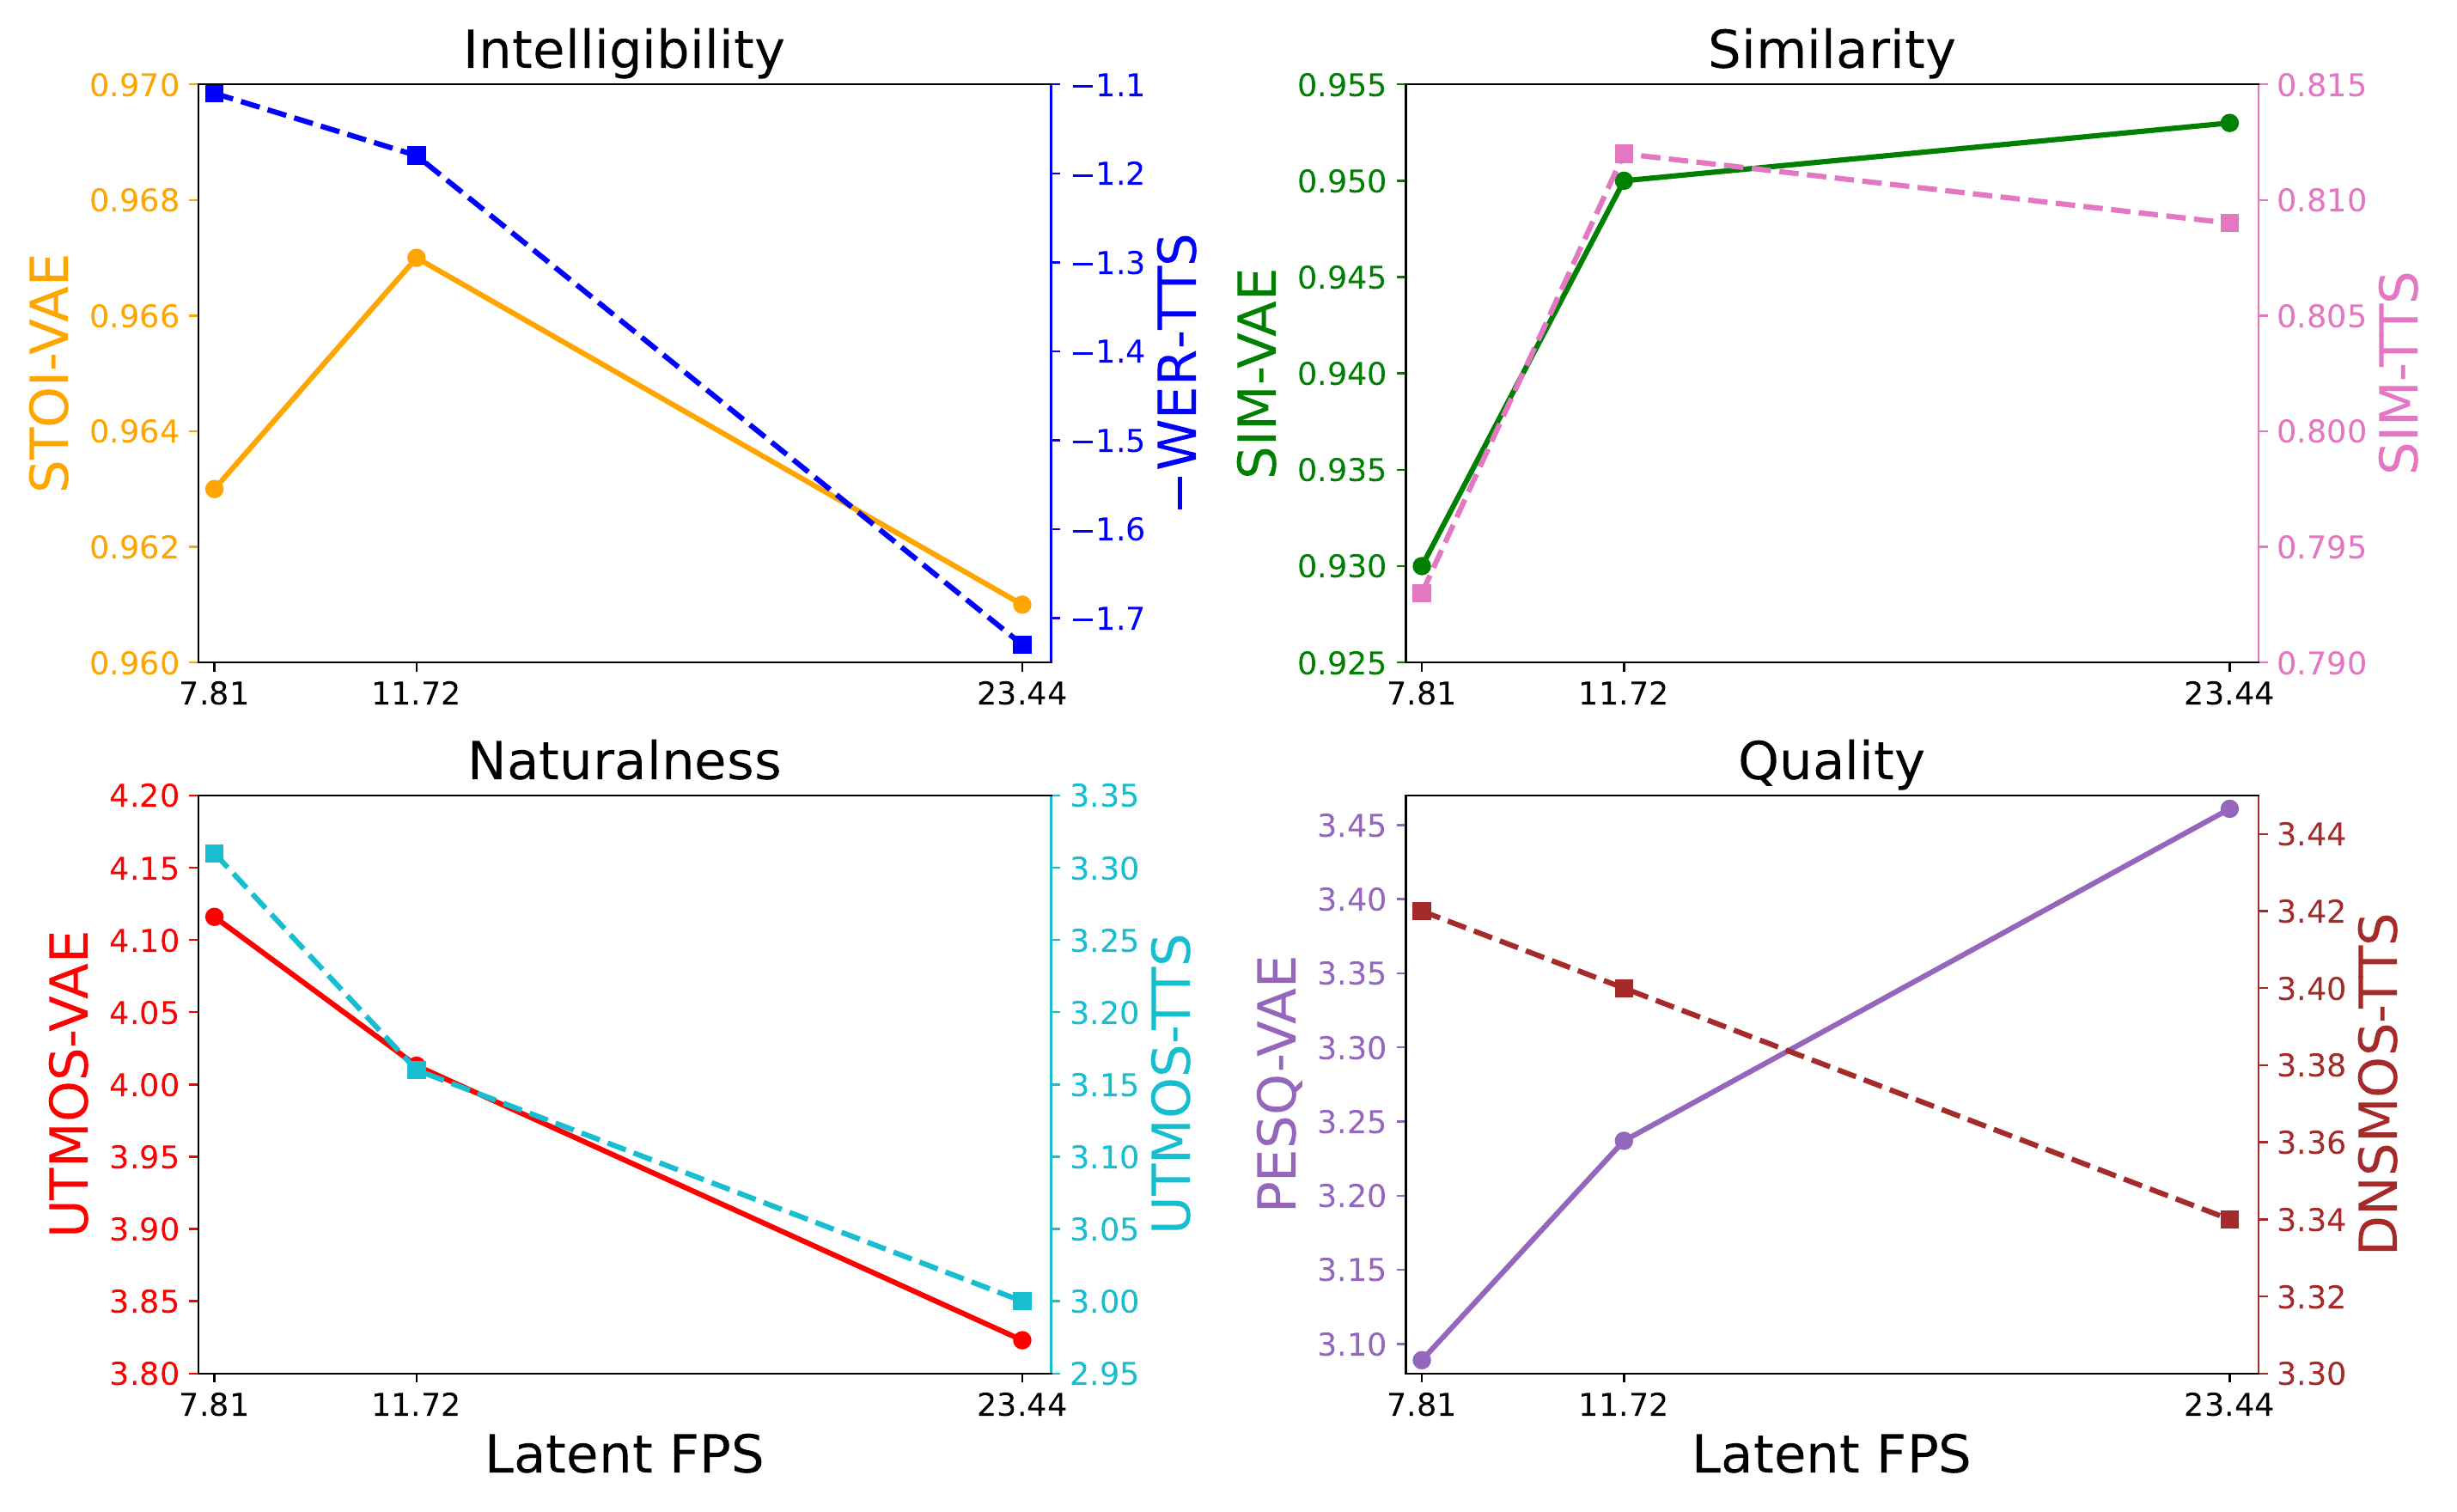
Trang này lấy trung bình các cột SIM chính thức ZH, EN và ZH-Hard, chỉ gồm các hàng đầy đủ. Độ tự nhiên và WER vẫn là những câu hỏi riêng.
| Mô hình | SIM trung bình ba nhóm | Vẫn cần kiểm tra |
|---|---|---|
| LongCat-AudioDiT 3.5B | khoảng 80.0 | WER, độ tự nhiên và độ trễ |
| Qwen3-TTS | khoảng 74.5 | thiết kế giọng so với nhân bản |
| VoxCPM | khoảng 74.4 | độ mạch lạc khi đọc dài và RTF |
Giữ lại cả kết quả không tham chiếu lẫn kết quả có điều kiện tham chiếu cho cùng một câu. Kiểm tra tên riêng, con số và ngắt nghỉ trước âm sắc, trọng âm và ngữ điệu. Chỉ nghe độ giống nhau có thể che giấu từ bị bỏ sót hoặc nhiễu bị sao chép.
Một mẫu tham chiếu hữu ích cần ngắn, sạch và một người nói. Nhiều giọng, tiếng vang mạnh và nhạc nền hòa trộn bản sắc với môi trường; các mẫu lặp lại của cùng một văn bản cho thấy phương sai giữa độ tương đồng, ngữ điệu và phát âm.
Độ tương đồng người nói đo khoảng gần trong không gian embedding. Nó không chứng minh danh tính cũng không cấp quyền sử dụng giọng nói của ai. Công cụ này dành cho tư liệu tham chiếu mà người dùng có quyền xử lý.
Kho mã công khai và thẻ mô hình 3.5B cùng xác lập các tài nguyên đã phát hành. Các con số tương đồng vẫn gắn với những tập kiểm thử đã nêu tên và không thay thế các phép kiểm tra riêng về phát âm đa ngôn ngữ, độ ổn định khi đọc dài và cảm nhận tự nhiên.
Tên mô hình, con số và giới hạn đều truy về các bài báo, kho mã hoặc thẻ mô hình bên dưới.