Modelo
LongCat-AudioDiT 3.5B: Escreva as condições do alto-falante no transformador de difusão de áudio
Leitura intensiva do artigo / Clonagem de voz com amostra zero

Leitura intensiva do artigo / Clonagem de voz com amostra zero
© 2026 TelkNet. Todos os direitos reservados.
LEITURA DE ARTIGO / CLONAGEM DE VOZ ZERO-SHOT
O LongCat-AudioDiT 3.5B mira síntese texto-fala e clonagem zero-shot. Texto de destino, uma referência de falante e pistas prosódicas se encontram dentro de um transformer de difusão que gera latentes acústicos. Seus números publicados de similaridade respondem a uma pergunta mais estreita do que naturalidade, erro de palavras ou sotaque multilíngue.
Um processo direto corrompe um latente acústico limpo x₀ até x_t. Condicionada ao texto e à informação do falante c, a rede prevê ruído ou velocidade:
L=E ||ε−εθ(x_t,t,c)||²
O caminho de qualidade disponibilizado usa 32 avaliações de função. A síntese incondicional usa CFG, enquanto a clonagem baseada em referência segue o método APG do projeto para reduzir a supersaturação sob orientação forte.
Muitos sistemas zero-shot geram unidades acústicas discretas uma a uma. O LongCat, em vez disso, restaura uma trajetória acústica contínua com um transformer de difusão, enquanto o UMT5 fornece as características de texto e a referência fornece identidade e prosódia. A mudança desloca o acúmulo de erro da ordem dos tokens para a remoção iterativa de ruído e a orientação.
A tabela oficial do Seed traz três recortes de similaridade de falante cujos valores do 3.5B têm média de cerca de 80.0. Essas linhas só podem ser comparadas dentro da tabela citada; não substituem MOS, erro de palavras, sotaque entre idiomas ou consistência em formato longo. Uma voz pode soar parecida e ainda assim pronunciar um nome errado.
Um prompt útil é curto, limpo e de um único falante. Vários falantes, música e reverberação forte misturam ambiente com identidade. Similaridade de voz é uma propriedade da síntese, não um sinal de verificação de identidade nem permissão para personificar alguém.
A clonagem zero-shot costuma usar tokens discretos de áudio autoregressivos: um modelo prevê unidades acústicas uma a uma enquanto uma referência fornece o condicionamento do falante. O LongCat-AudioDiT 3.5B, em vez disso, restaura um latente acústico contínuo com um transformer de difusão, usando o UMT5 para o texto e a referência para timbre e prosódia.
Benefício e custo decorrem da remoção global de ruído. A estrutura da frase pode ser revista ao longo da trajetória, mas 32 avaliações de função aumentam a latência. APG e CFG também alteram a saturação do timbre, a estabilidade da pronúncia e o ruído de fundo copiado; são mais do que um único número de orientação.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_tlatente acústico no passo tc_textcondição de textoc_spkcondição do falante a partir da referênciaEsta notação genérica de difusão condicional mostra as condições de texto e de falante entrando juntas na rede de remoção de ruído; não é apresentada como uma equação linha a linha do repositório. Trinta e duas avaliações de função atualizam o latente repetidas vezes.
Similaridade de falante e correção de conteúdo são eixos separados. Um prompt ruidoso pode transformar o som da sala em condição de voz, e similaridade alta não prova nomes, números ou pausas corretos.
O artigo, o código e os pesos podem ser acompanhados em LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
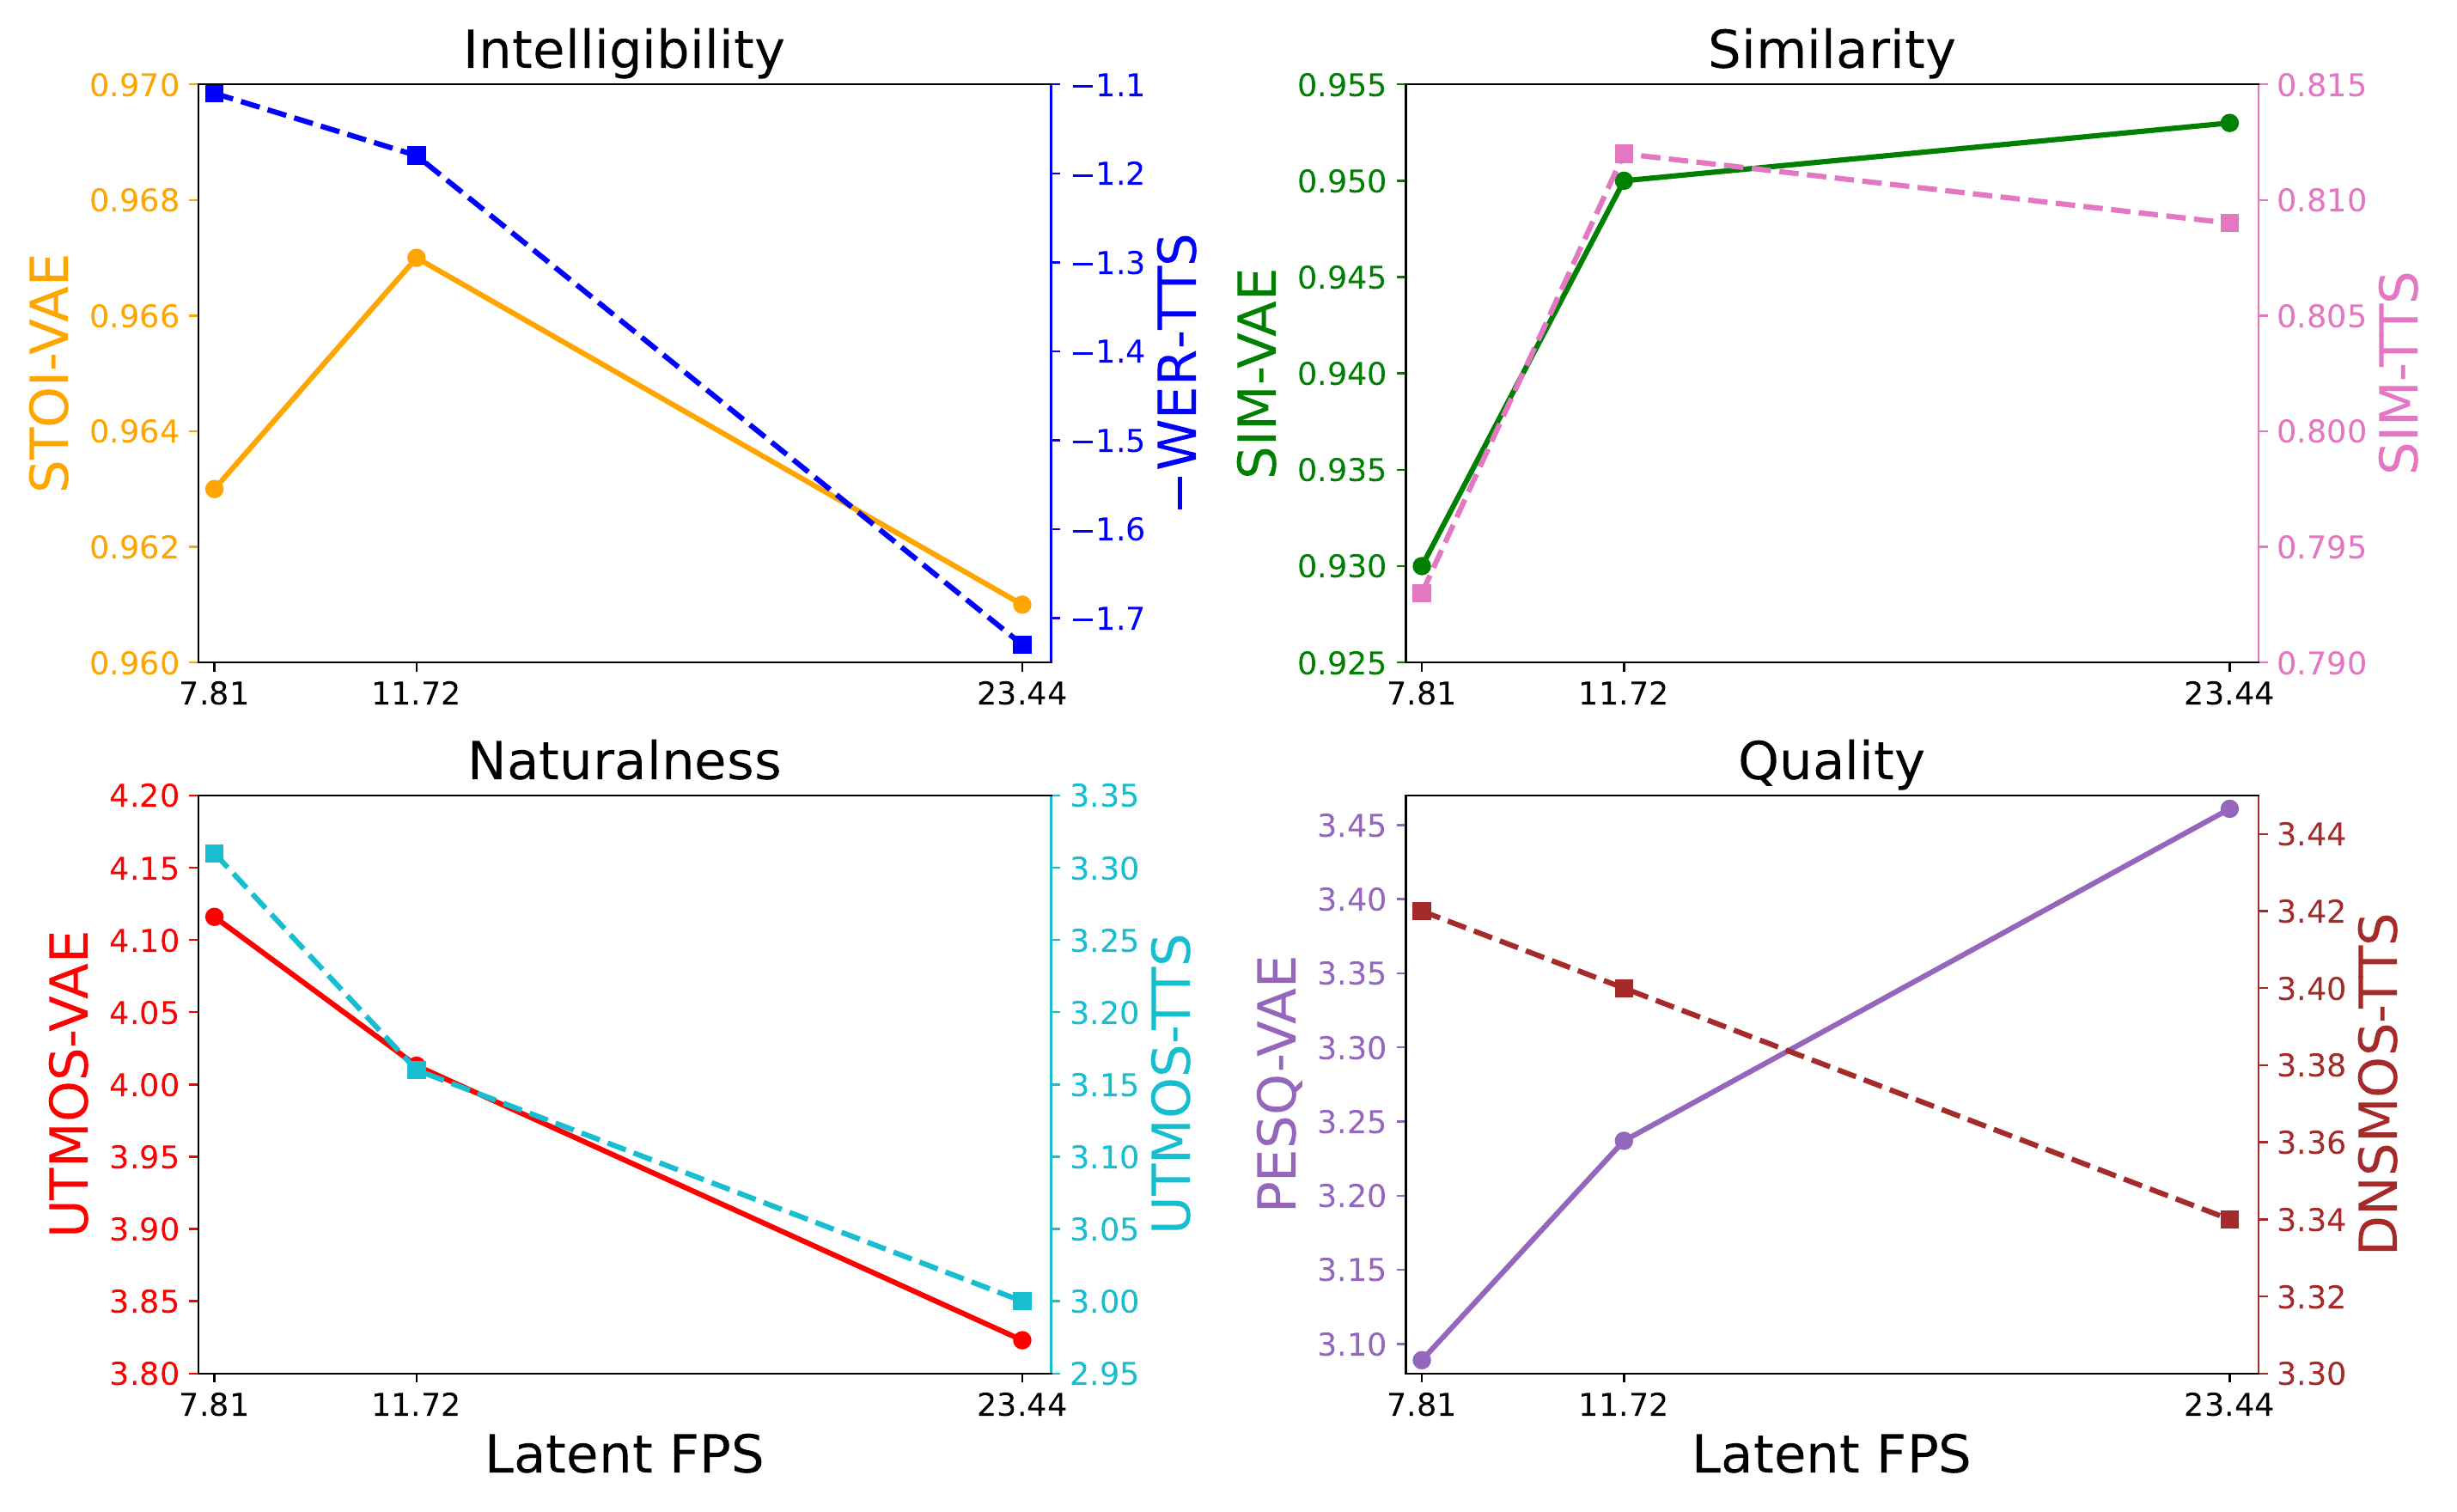
A média usa as colunas oficiais de SIM em ZH, EN e ZH-Hard e considera apenas linhas completas. Naturalidade e WER continuam sendo perguntas à parte.
| Modelo | Média de SIM nos três recortes | Ainda auditar |
|---|---|---|
| LongCat-AudioDiT 3.5B | cerca de 80.0 | WER, naturalidade e latência |
| Qwen3-TTS | cerca de 74.5 | design de voz versus clonagem |
| VoxCPM | cerca de 74.4 | coerência em formato longo e RTF |
Guarde tanto a saída sem referência quanto a condicionada à referência para a mesma frase. Confira nomes, números e pausas antes de timbre, sotaque e prosódia. Ouvir só a semelhança pode esconder palavras que faltam ou ruído copiado.
Uma referência útil é curta, limpa e de um único falante. Várias vozes, reverberação forte e música misturam identidade com ambiente; amostras repetidas do mesmo texto revelam variância em similaridade, prosódia e pronúncia.
A similaridade de falante mede proximidade de embeddings. Não prova identidade nem concede permissão para usar uma voz. A ferramenta serve para material de referência que o usuário tem direito de processar.
O repositório público e o cartão do modelo 3.5B, juntos, estabelecem os materiais disponibilizados. Os números de similaridade permanecem atrelados aos conjuntos de teste citados e não substituem verificações à parte de pronúncia multilíngue, estabilidade em formato longo e naturalidade percebida.
Nomes de modelos, números e limitações remetem aos artigos, repositórios ou cartões de modelo abaixo.