Modell
LongCat-AudioDiT 3.5B: Skriv høyttalerforhold inn i lyddiffusjonstransformator
Intensiv lesing av avisen / Nullprøve stemmekloning

Intensiv lesing av avisen / Nullprøve stemmekloning
ARTIKKELGJENNOMGANG / ZERO-SHOT-STEMMEKLONING
LongCat-AudioDiT 3.5B er rettet mot tekst-til-tale og zero-shot-kloning. Måltekst, en talerreferanse og prosodiske hint møtes inne i en diffusjonstransformer som genererer akustiske latenter. De publiserte likhetstallene svarer på et smalere spørsmål enn naturlighet, ordfeil eller flerspråklig aksent.
En fremoverprosess forvrenger et rent akustisk latent x₀ til x_t. Betinget på tekst og talerinformasjon c forutsier nettverket støy eller hastighet:
L=E ||ε−εθ(x_t,t,c)||²
Den utgitte kvalitetsstien bruker 32 funksjonsevalueringer. Ubetinget syntese bruker CFG, mens referansebasert kloning følger prosjektets APG-metode for å redusere overmetning under sterk styring.
Mange zero-shot-systemer genererer diskrete akustiske enheter én etter én. LongCat gjenoppbygger i stedet en kontinuerlig akustisk bane med en diffusjonstransformer, mens UMT5 leverer teksttrekk og referansen leverer identitet og prosodi. Endringen flytter feilakkumuleringen fra tokenrekkefølge over mot iterativ denoising og styring.
Den offisielle Seed-tabellen rapporterer tre talerlikhets-splitt der 3.5B-verdiene i snitt ligger på om lag 80.0. Disse radene kan bare sammenlignes innenfor den nevnte tabellen; de erstatter ikke MOS, ordfeil, aksent på tvers av språk eller langforms konsistens. En stemme kan høres lik ut samtidig som den leser et navn feil.
En nyttig prompt er kort, ren og med én taler. Flere talere, musikk og kraftig klang blander omgivelser med identitet. Stemmelikhet er en synteseegenskap, ikke et signal for identitetsverifisering eller en tillatelse til å etterligne en person.
Zero-shot-kloning har ofte brukt autoregressive diskrete lydtoken: en modell forutsier akustiske enheter én etter én mens en referanse gir talerbetingelse. LongCat-AudioDiT 3.5B gjenoppbygger i stedet et kontinuerlig akustisk latent med en diffusjonstransformer, der UMT5 står for teksten og referansen for klangfarge og prosodi.
Både gevinsten og kostnaden følger av global denoising. Setningsstrukturen kan revideres langs hele banen, men 32 funksjonsevalueringer øker latenstiden. APG og CFG endrer også klangmetning, uttalestabilitet og kopiert bakgrunnsstøy; de er mer enn ett enkelt styringstall.

L=E ||ε−εθ(z_t,t,c_text,c_spk)||²z_takustisk latent ved steg tc_texttekstbetingelsec_spktalerbetingelse fra referansenDenne generelle notasjonen for betinget diffusjon viser at tekst- og talerbetingelser går inn i denoiseren sammen; den er ikke ment som en linje-for-linje-ligning fra kodebasen. Trettito funksjonsevalueringer oppdaterer latentet gjentatte ganger.
Talerlikhet og innholdskorrekthet er separate akser. En støyete prompt kan gjøre romlyd om til en stemmebetingelse, og høy likhet beviser ikke korrekte navn, tall eller pauser.
Artikkel, kode og vekter kan følges via LongCat-AudioDiT source / LongCat-AudioDiT 3.5B weights.
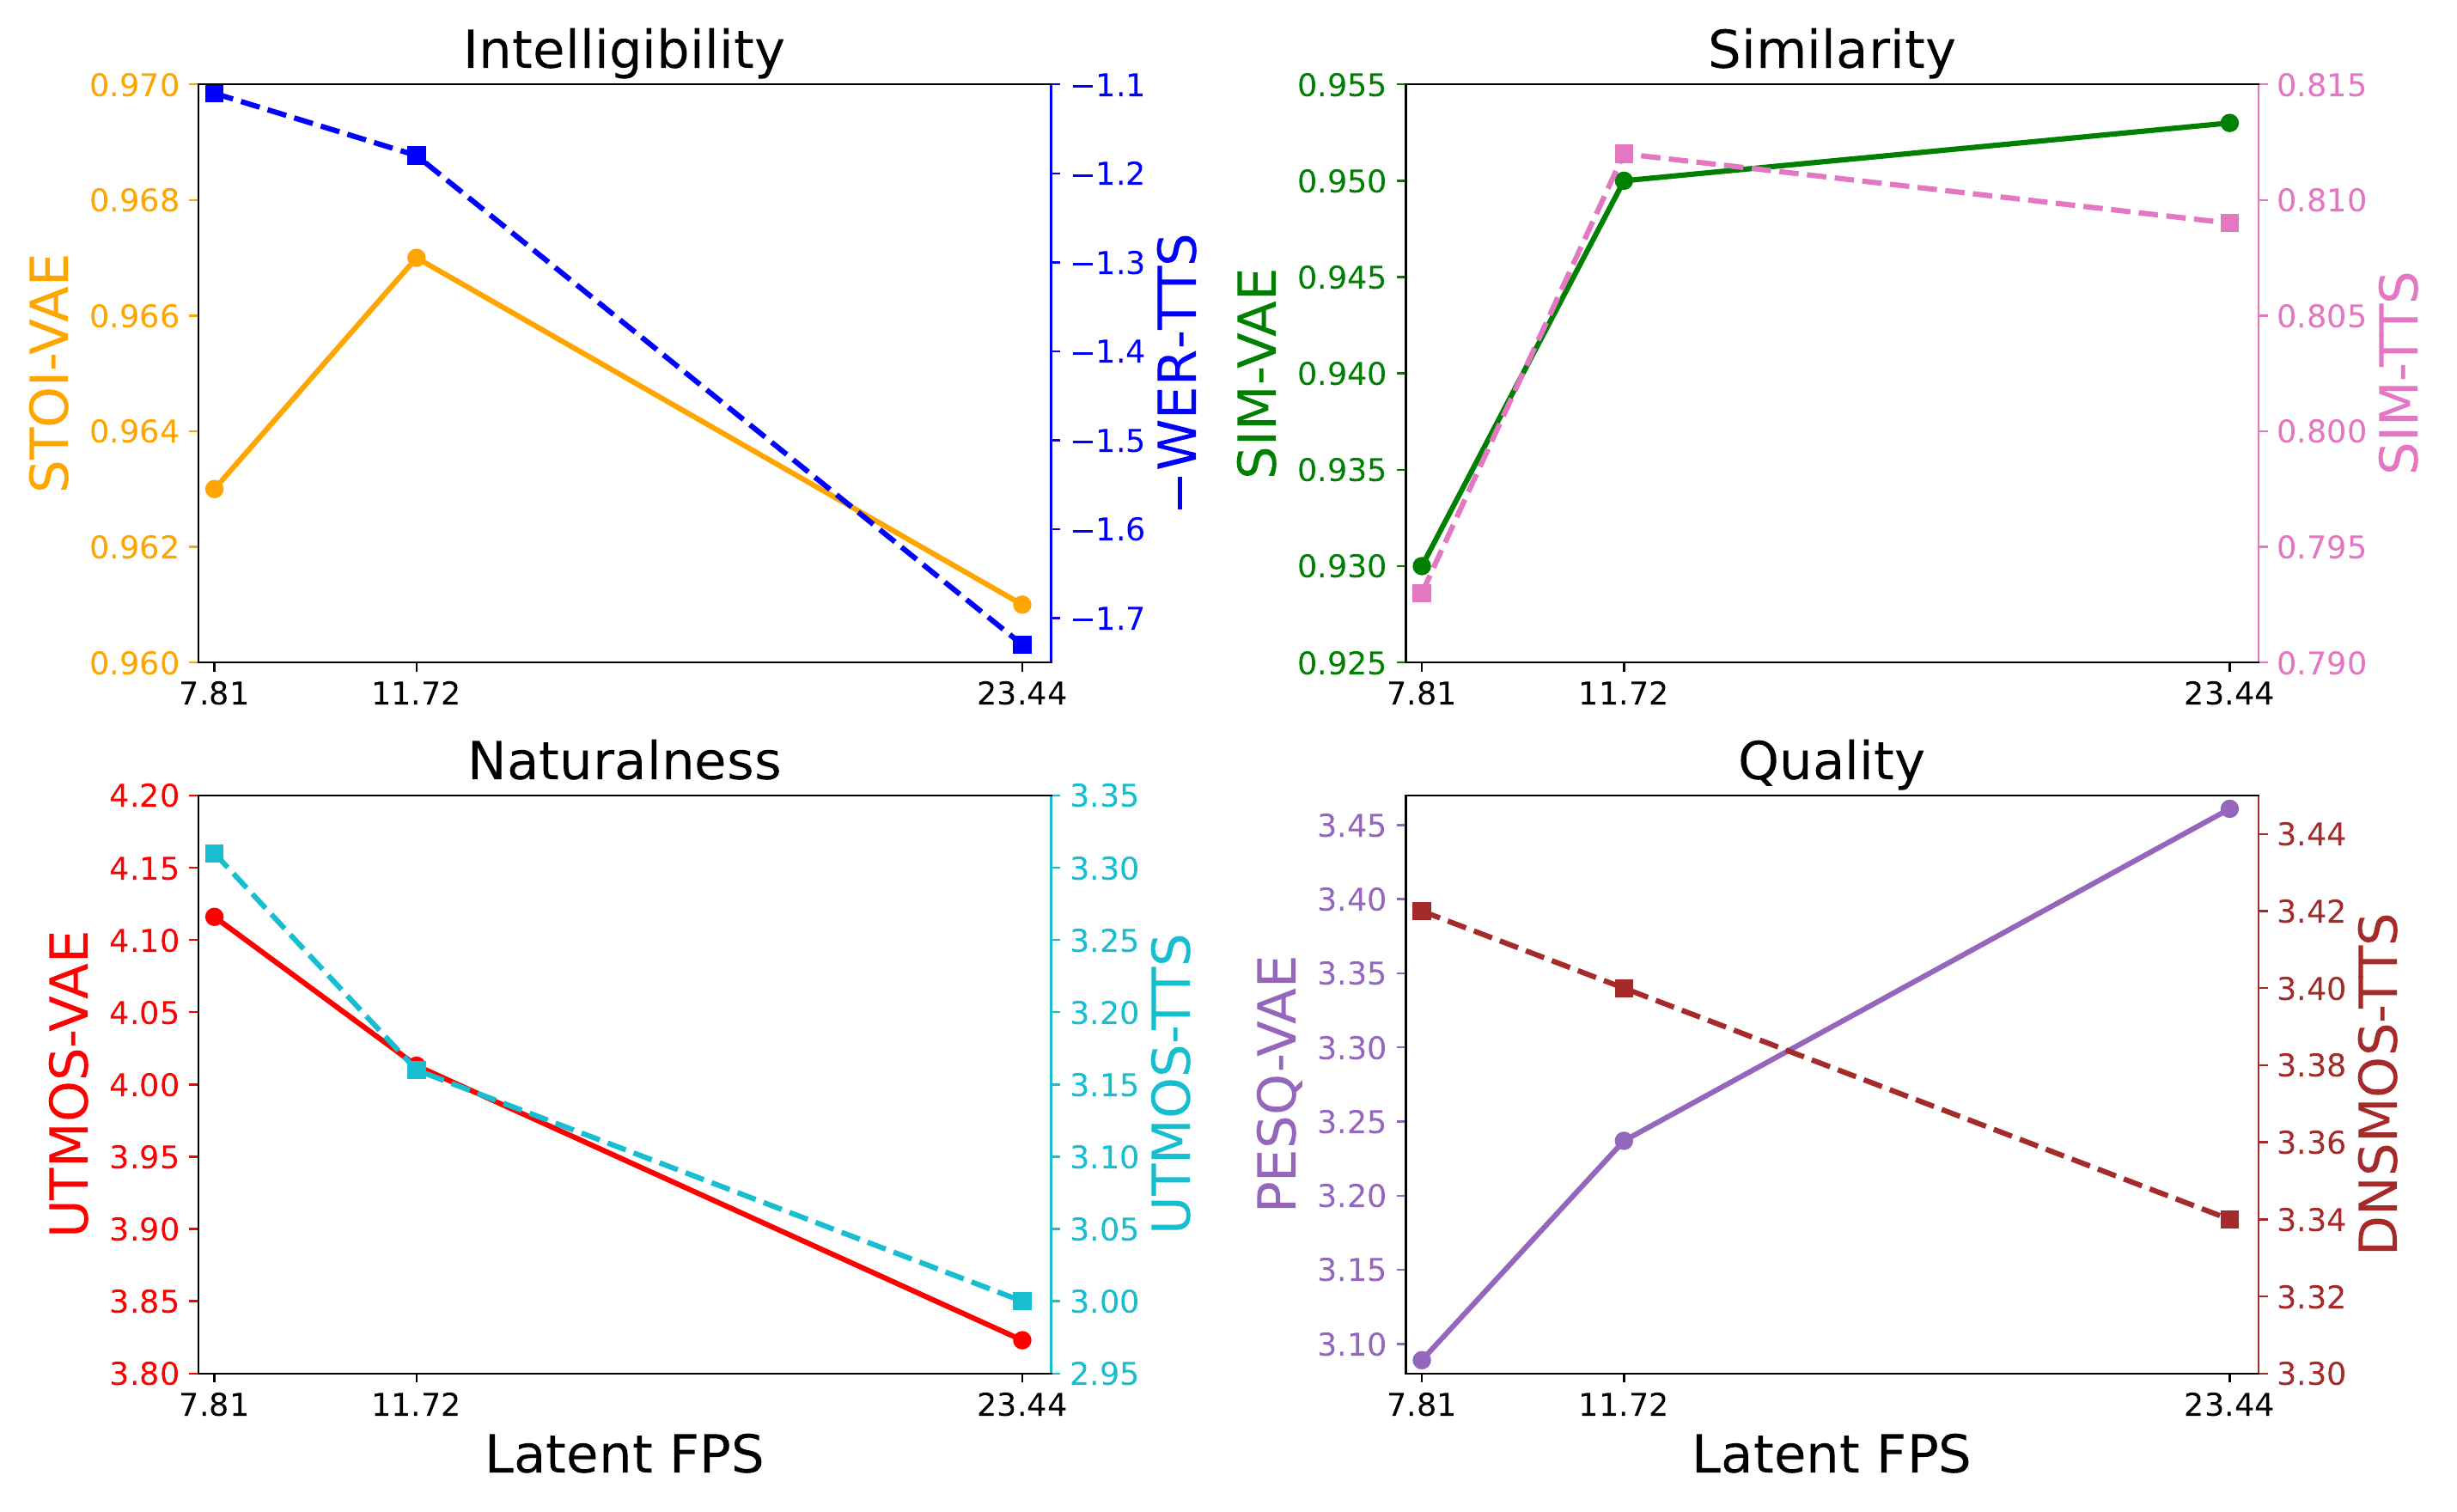
Siden tar snittet av de offisielle ZH-, EN- og ZH-Hard-SIM-kolonnene og tar bare med komplette rader. Naturlighet og WER forblir separate spørsmål.
| Modell | SIM-snitt for tre splitt | Fortsatt å kontrollere |
|---|---|---|
| LongCat-AudioDiT 3.5B | om lag 80.0 | WER, naturlighet og latenstid |
| Qwen3-TTS | om lag 74.5 | stemmedesign versus kloning |
| VoxCPM | om lag 74.4 | langform-koherens og RTF |
Behold både resultat uten referanse og referansebetinget resultat for samme setning. Kontroller navn, tall og pauser før klangfarge, aksent og prosodi. Å bare lytte etter likhet kan skjule manglende ord eller kopiert støy.
En nyttig referanse er kort, ren og med én taler. Flere stemmer, kraftig klang og musikk blander identitet med omgivelser; gjentatte prøver av samme tekst avslører varians i likhet, prosodi og uttale.
Talerlikhet måler nærhet mellom embeddings. Det beviser verken identitet eller gir tillatelse til å bruke en stemme. Verktøyet er ment for referansemateriale brukeren har rett til å behandle.
Det offentlige kodelageret og 3.5B-modellkortet fastslår til sammen hva som er utgitt. Likhetstallene forblir knyttet til sine navngitte testsett og erstatter ikke separate kontroller av flerspråklig uttale, langformstabilitet og opplevd naturlighet.
Modellnavn, tall og begrensninger kan spores til artiklene, kodelagrene eller modellkortene nedenfor.