 모델
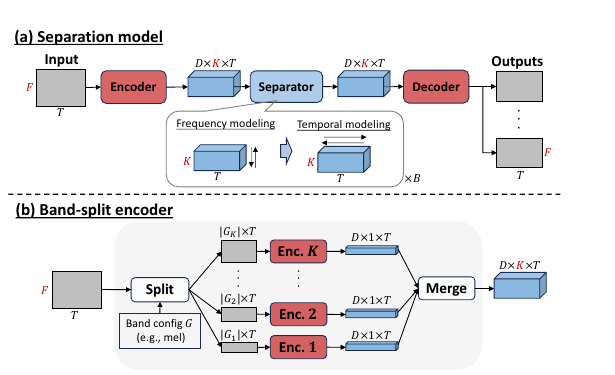
SFC-Locoformer: 11.8dB DnR에 대한 적응형 스펙트럼 압축 및 대화 경계
논문 집중 독해 / 영화와 TV 소리 분리
기사 읽기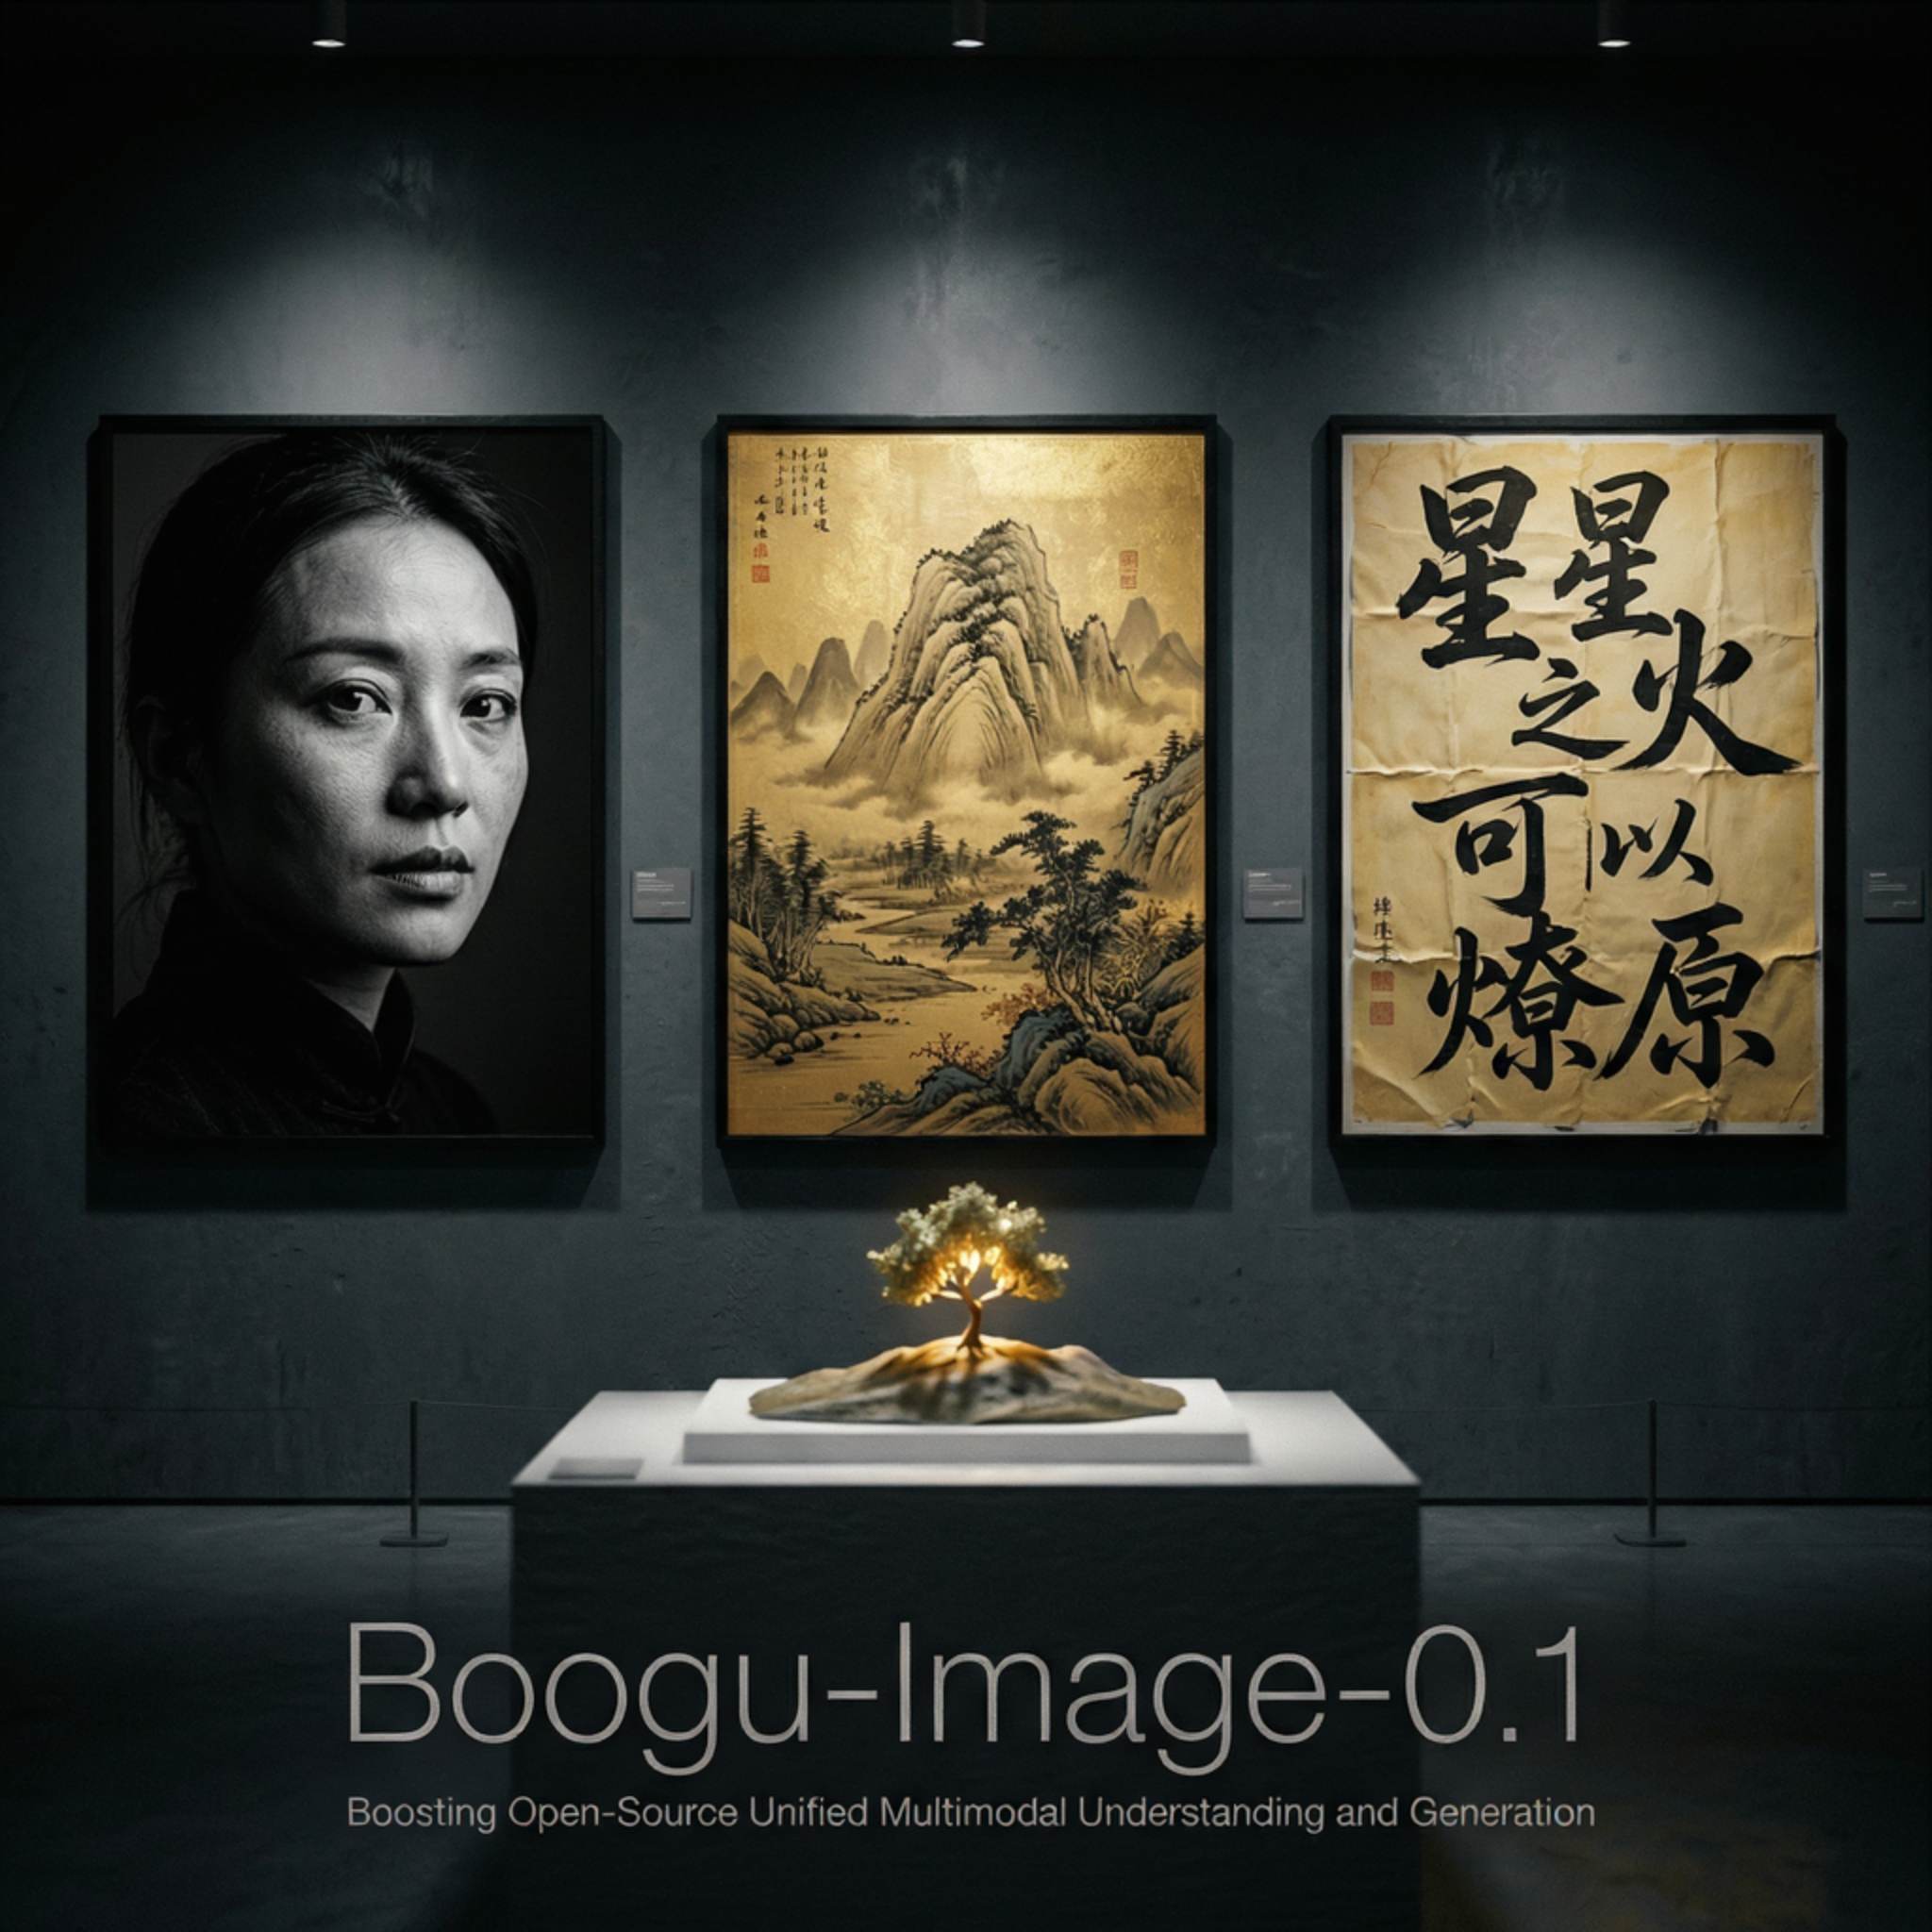 모델
Boogu-Image 0.1: Base, Turbo, Edit의 세 가지 가중치 간의 노동 분할 및 왜곡 위험
모델 해부/이미지 생성 및 편집
기사 읽기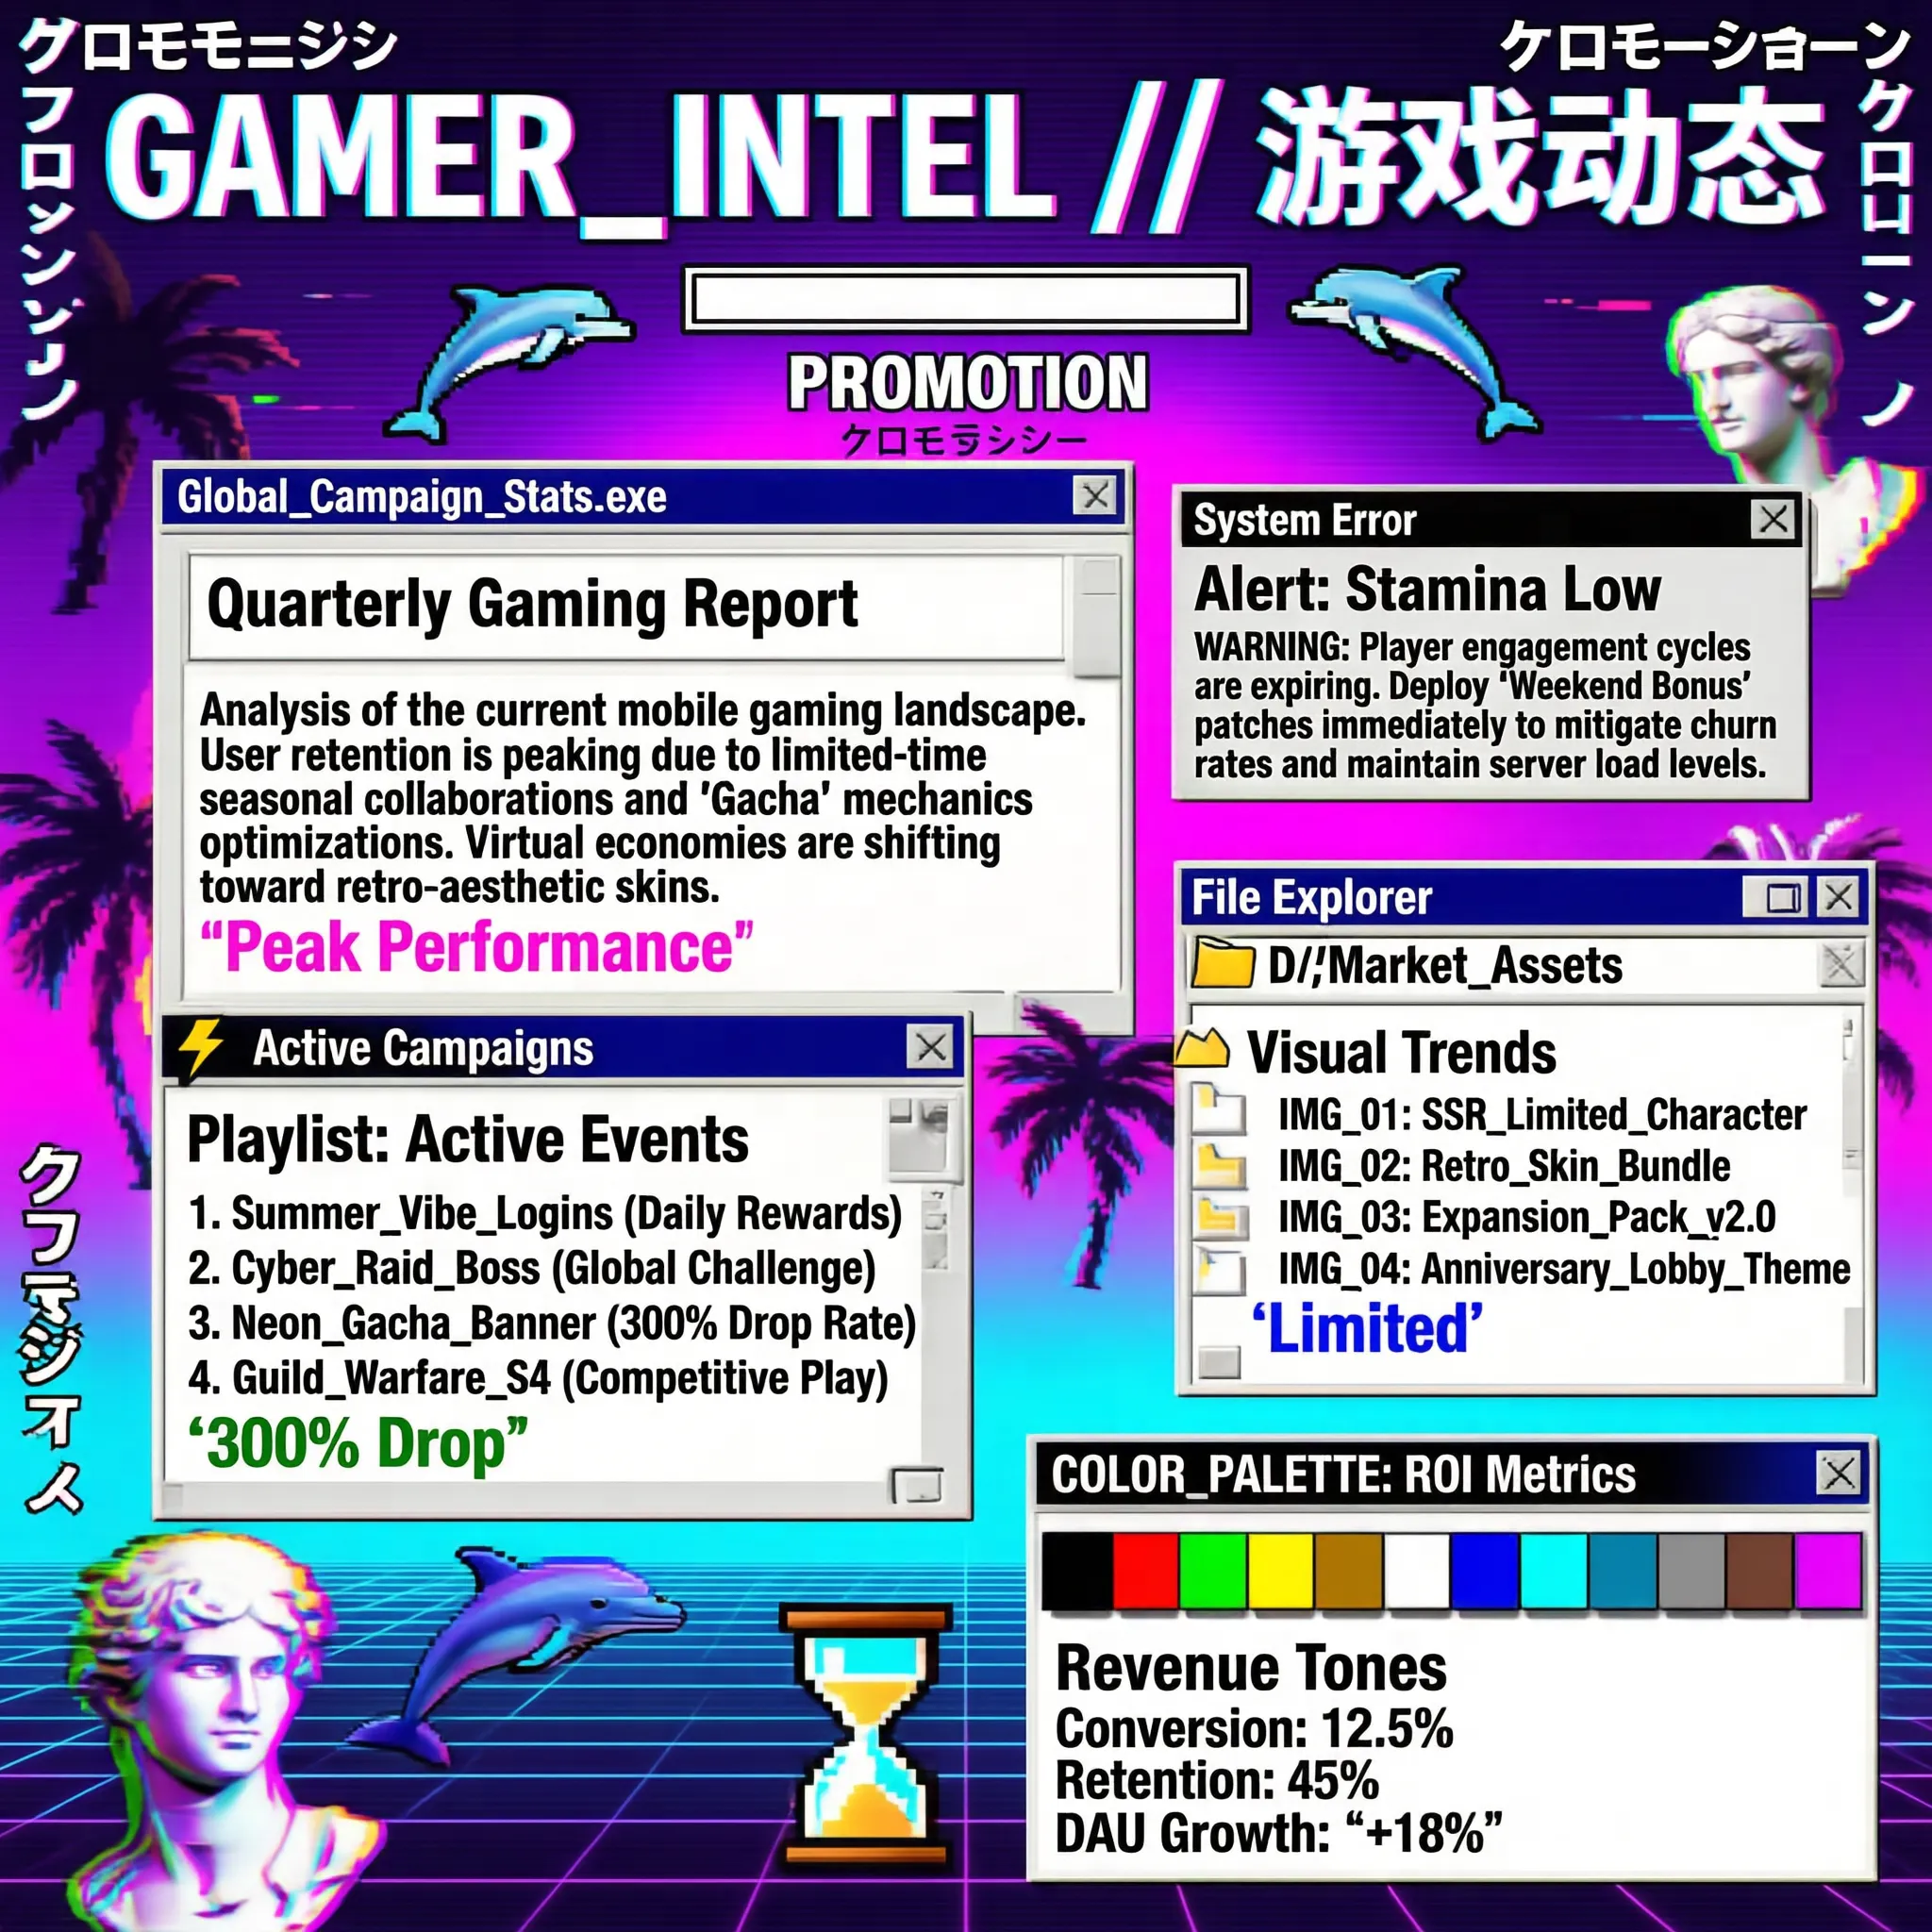 모델
SenseNova-U1 Infographic V2: 50.3점 평가 범위 및 인포그래픽 경계
특수 모델/인포그래픽 생성
기사 읽기 모델
LongCat-AudioDiT 3.5B: 오디오 확산 변환기에 스피커 조건 쓰기
논문 집중 읽기 / 제로 샘플 음성 복제
기사 읽기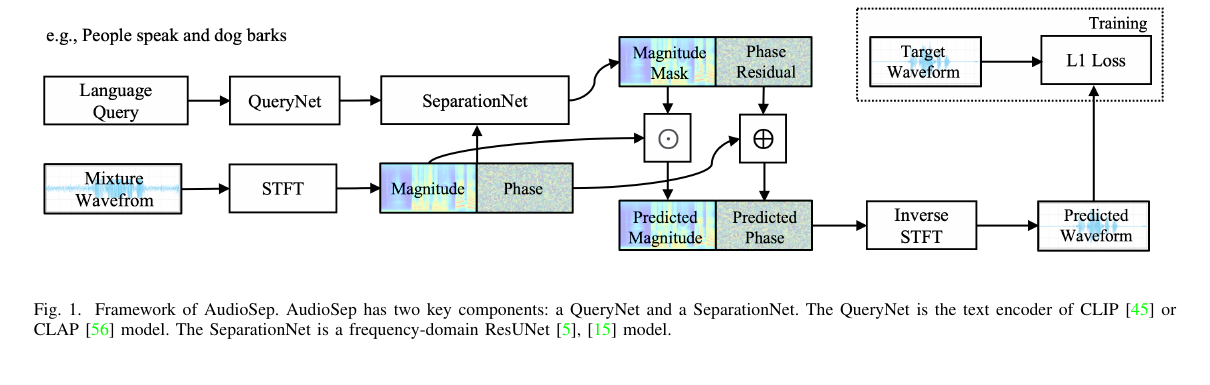 모델
AudioSep-Hive: 텍스트 쿼리로 임의의 사운드를 분리합니다.
소리 분리/기술 노트
기사 읽기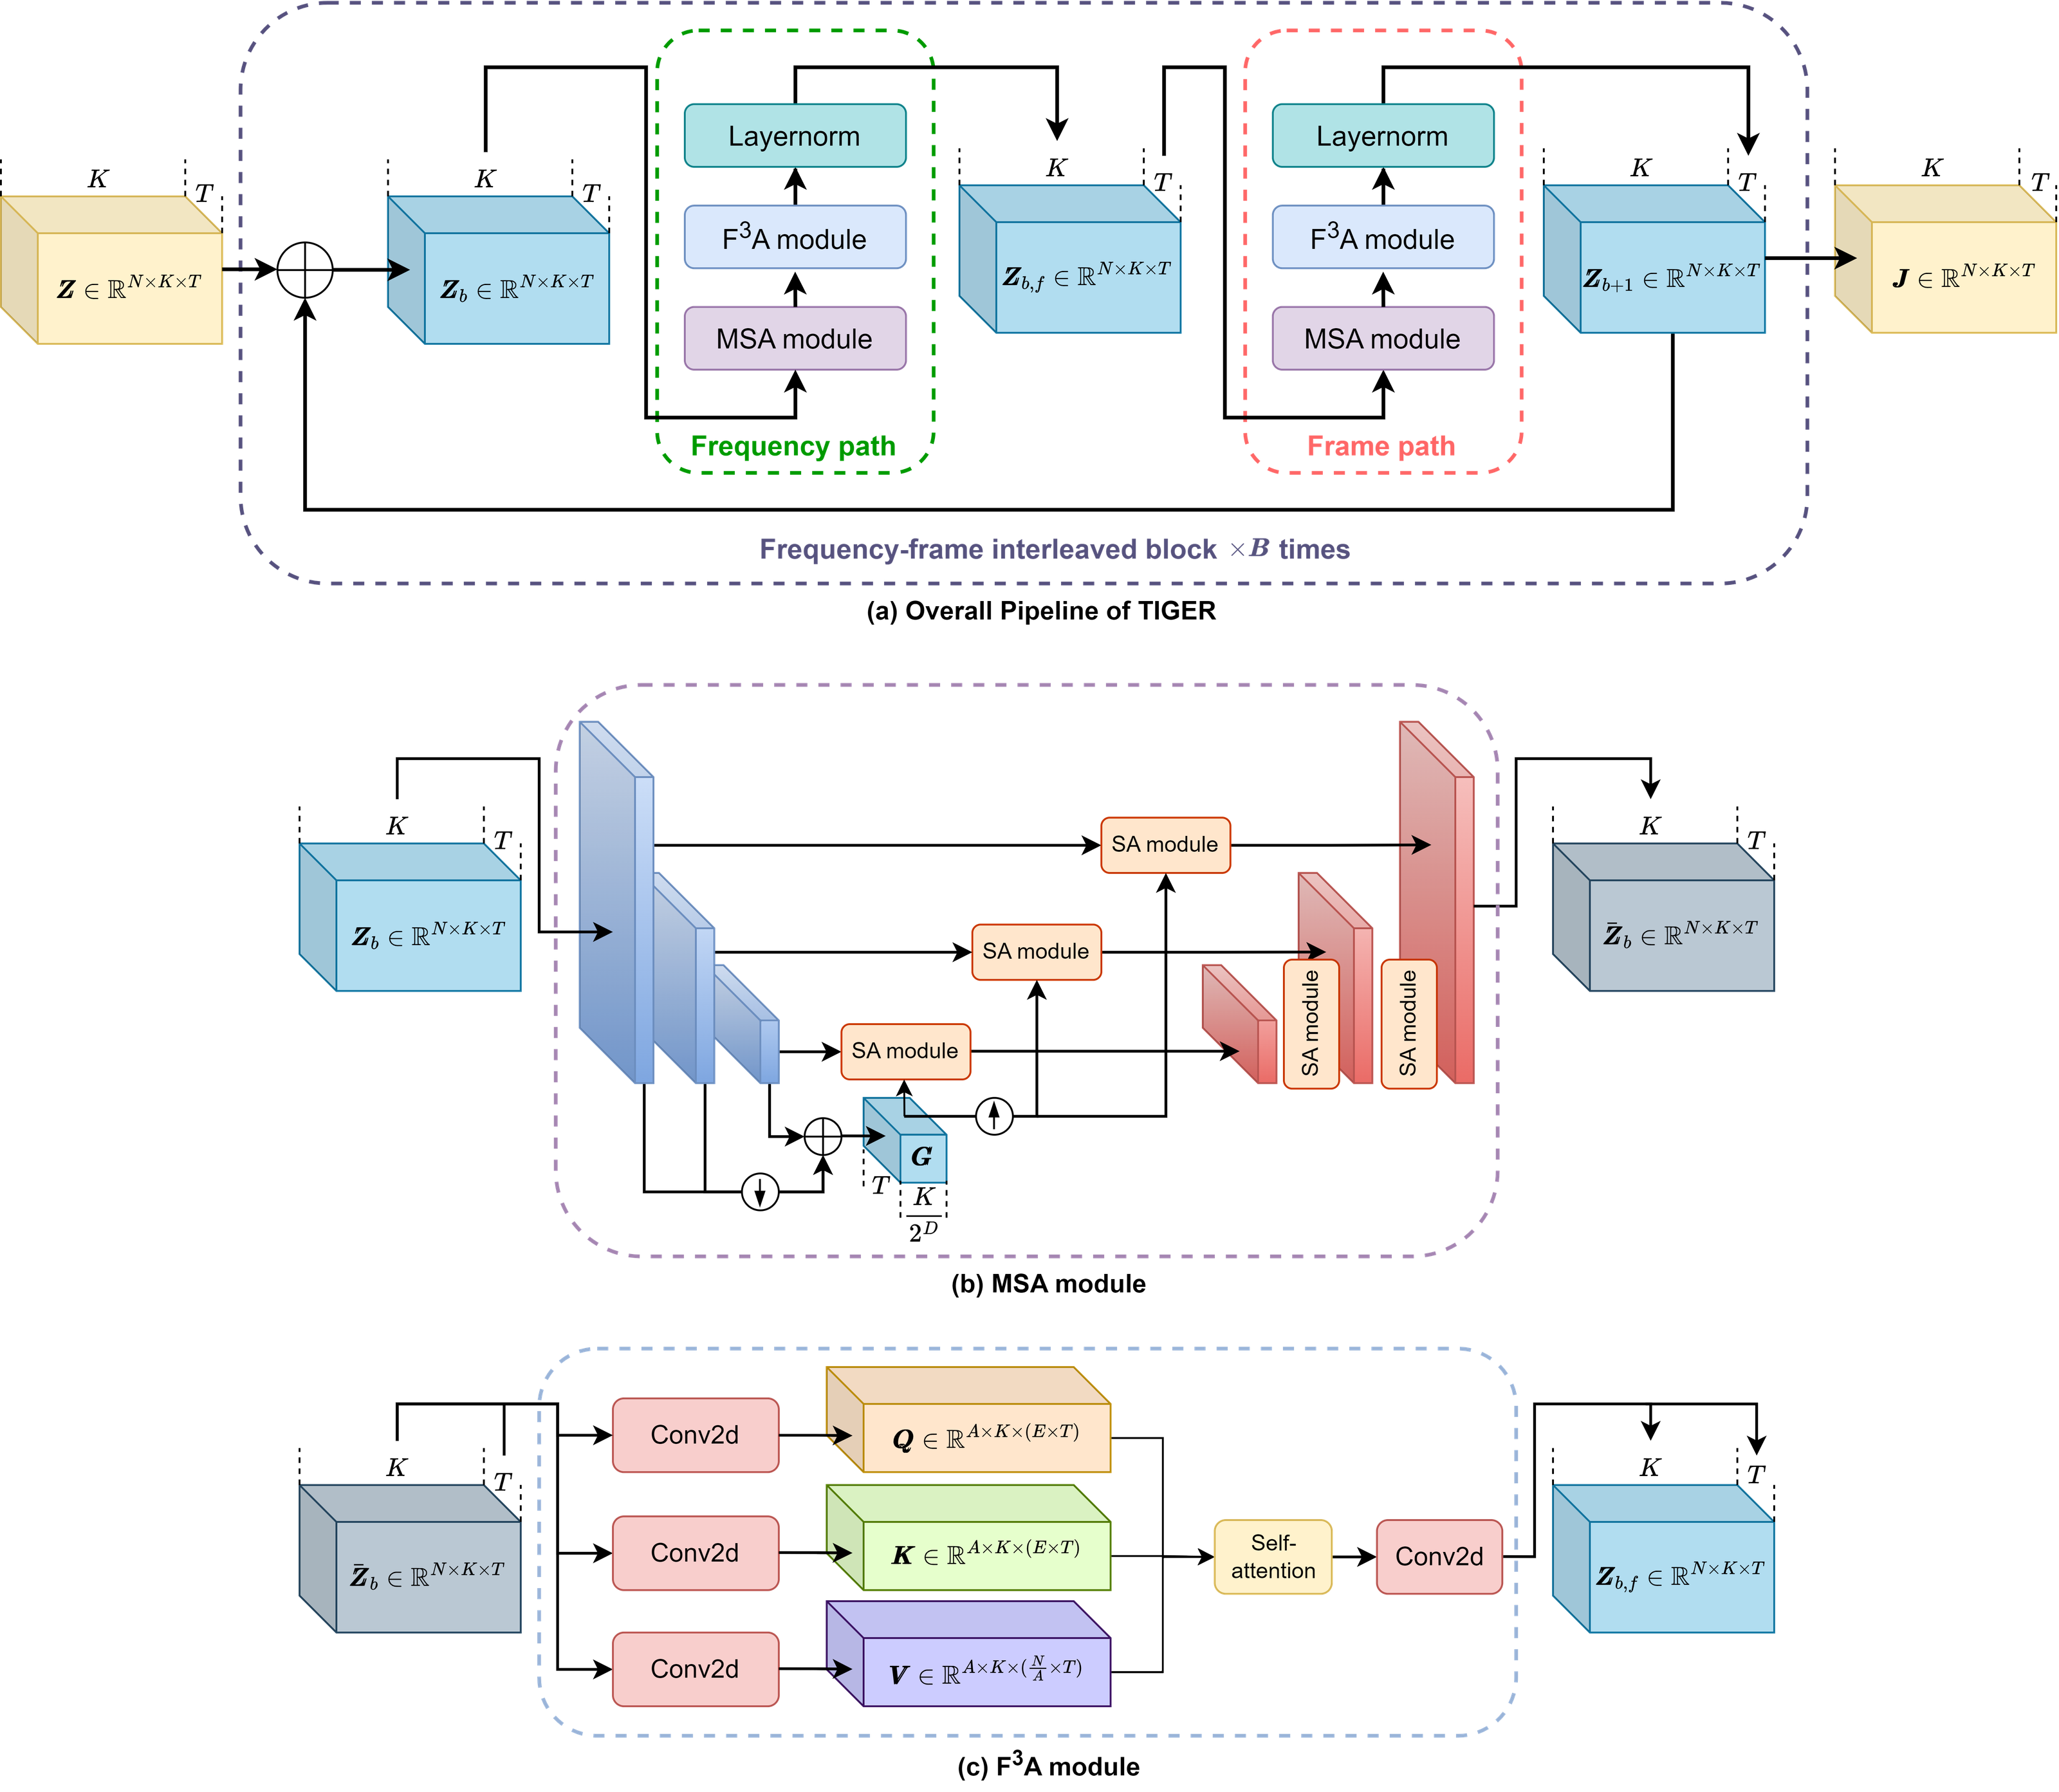 모델
BandIt 및 TIGER-DnR: 영화와 TV의 3트랙 분리 계산 할당을 위한 전쟁
영화 및 TV 사운드 / DnR
기사 읽기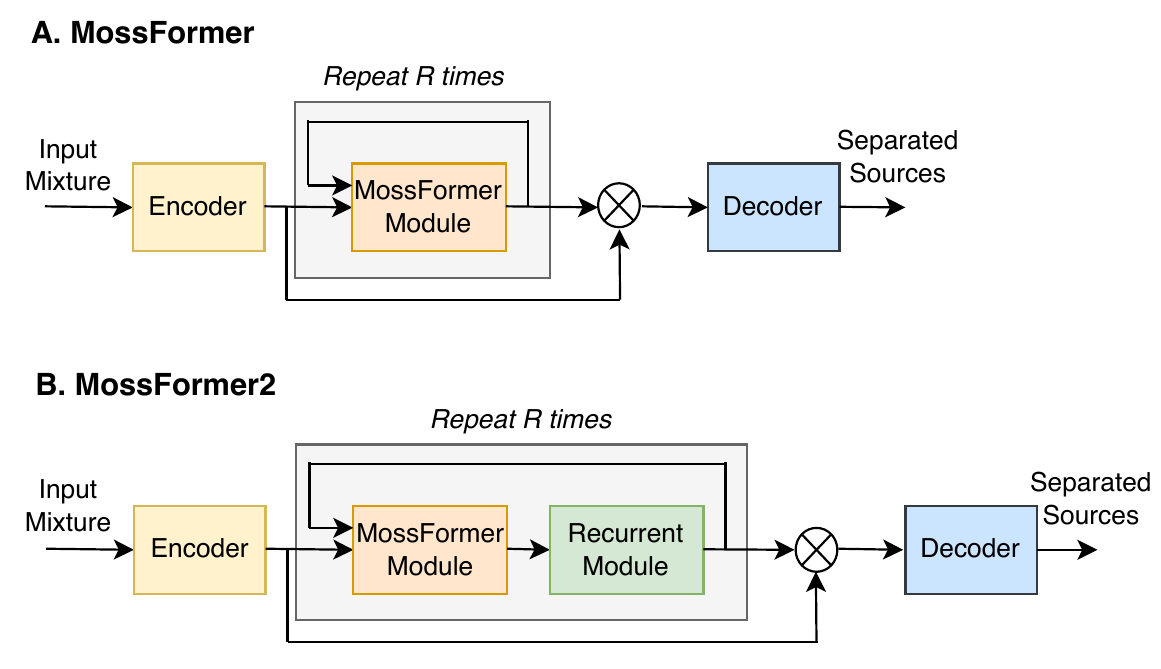 모델
MossFormer2 및 TIGER-speech: 음성 프런트엔드의 세 가지 작업 부문
음성 프론트엔드 / 기술 비교
기사 읽기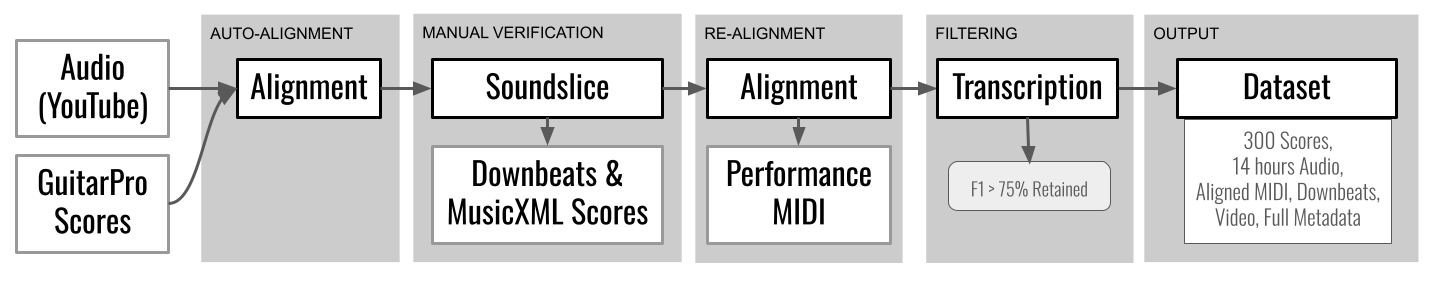 모델
MIDI에 대한 특수 오디오: 5가지 모델, 5가지 F1 시험지
아래 모델은 공개 가중치를 내려받을 수 있으며 TelkNet 도구 또는 profile 연결, 명시적 버전 선택, 불변 런타임 정의까지 갖췄습니다. 공개 표시와 작업 접수는 Admin 상태가 기준이고, 활성화에는 E2~E4 증거가, 기본 경로에는 추가로 E5가 필요합니다.
기사 읽기 모델
MuScriptor-large: 멀티 트랙 MIDI에 대한 13억 6600만 매개변수 전체 믹스의 실제 측정 및 경계
자동 음악 전사
기사 읽기 모델
Qwen-Image, Z-Image 및 FLUX.2 [klein]: 세 가지 개방형 이미지 경로 간의 차이점
오픈 이미지 모델/기술 개요
기사 읽기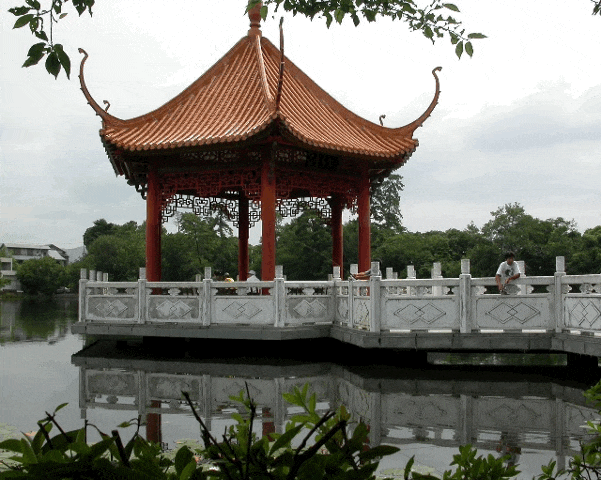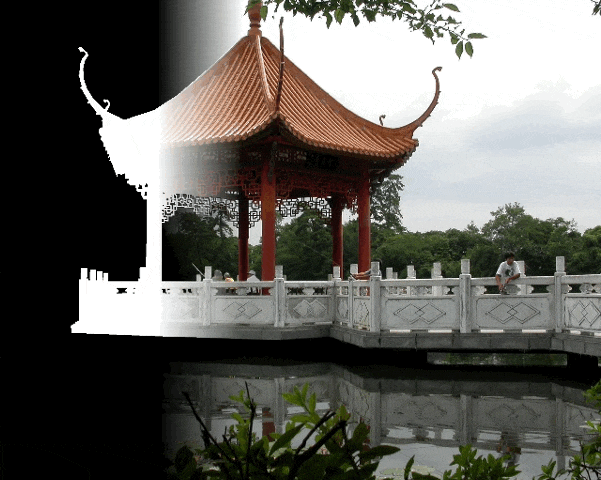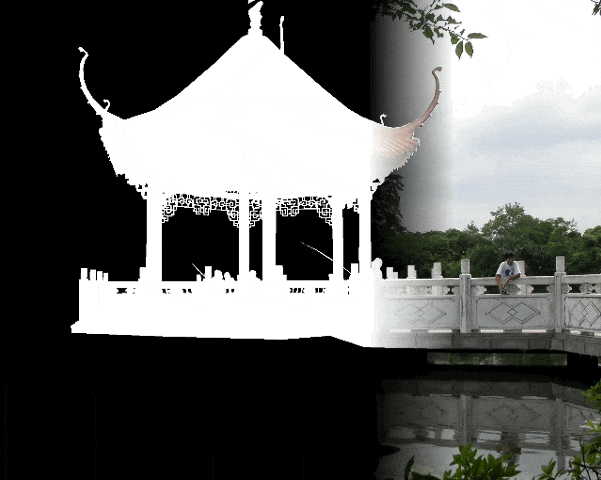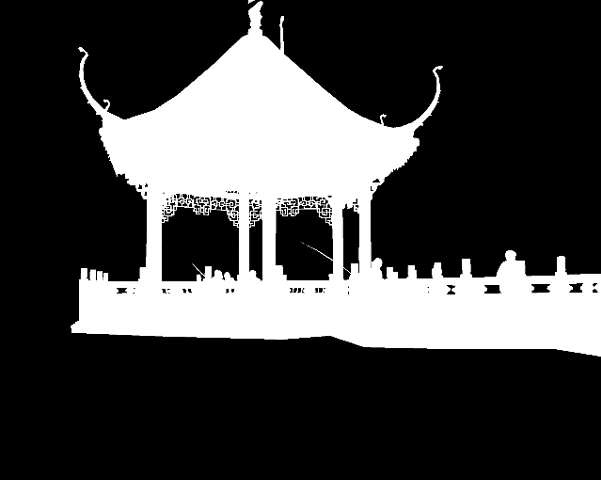 모델
BiRefNet, Moebius, VOSR 및 DDColor: 네 가지 역 문제, 네 가지 실패 방식
이미지 복원 / 특수모델 비교
기사 읽기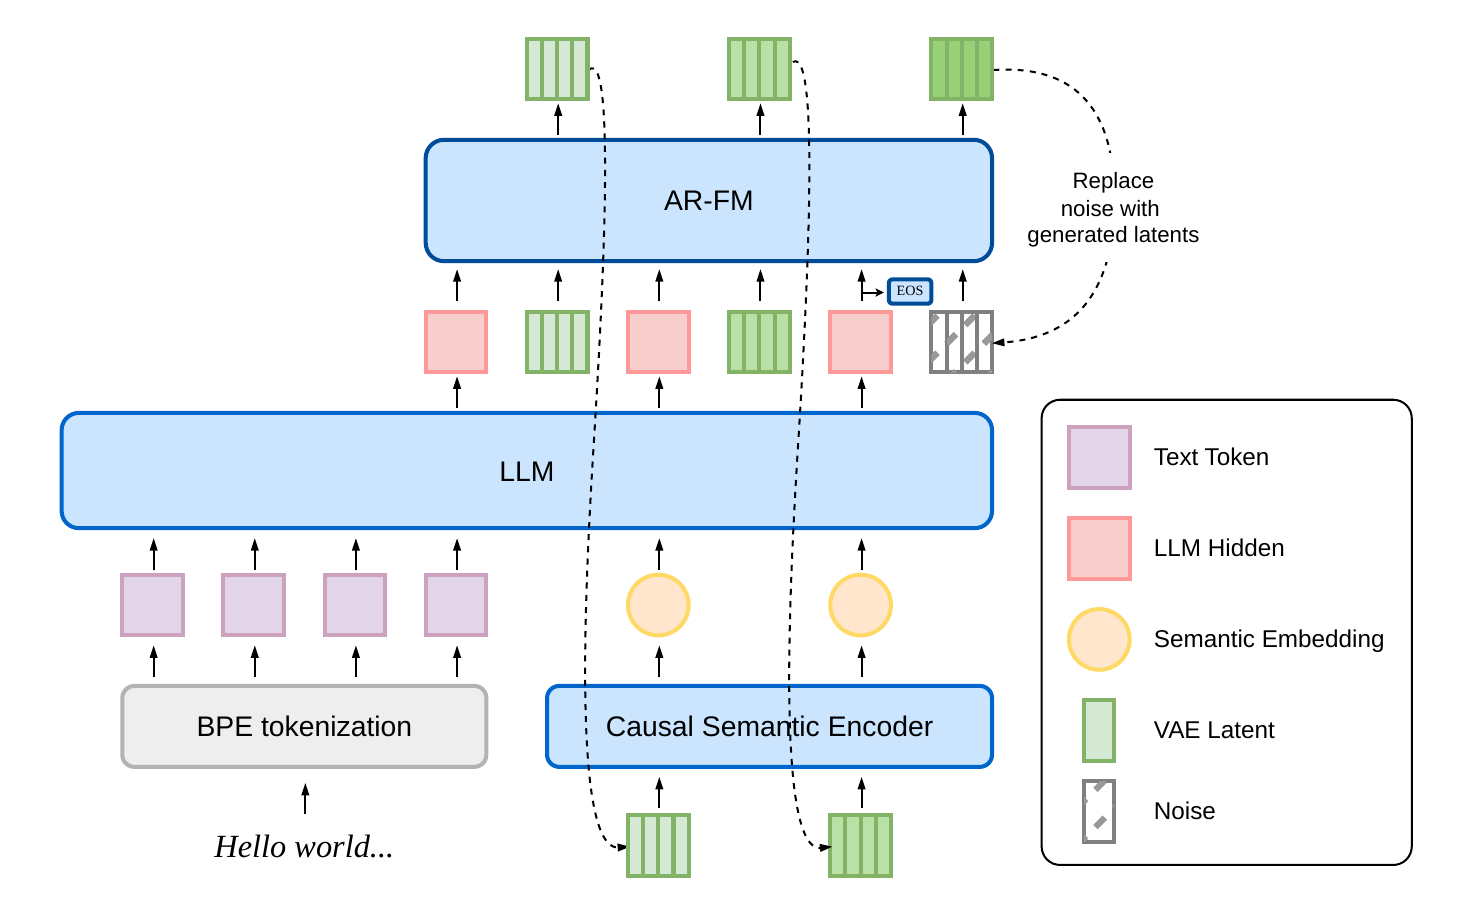 모델
dots.tts: 연속 음향 잠재 변수, 흐름 일치 및 48kHz 장거리 음성
음성합성 / 논문 집중독
기사 읽기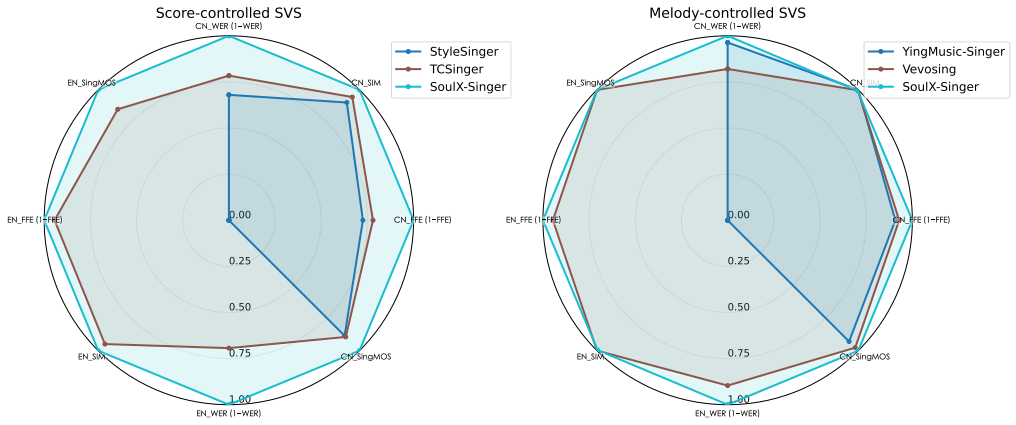 모델
SoulX-Singer 및 YingMusic-Singer-Plus: 악보 드라이브 및 멜로디 참조, 두 가지 노래 음성 합성 경로
노래 합성/루트 비교
기사 읽기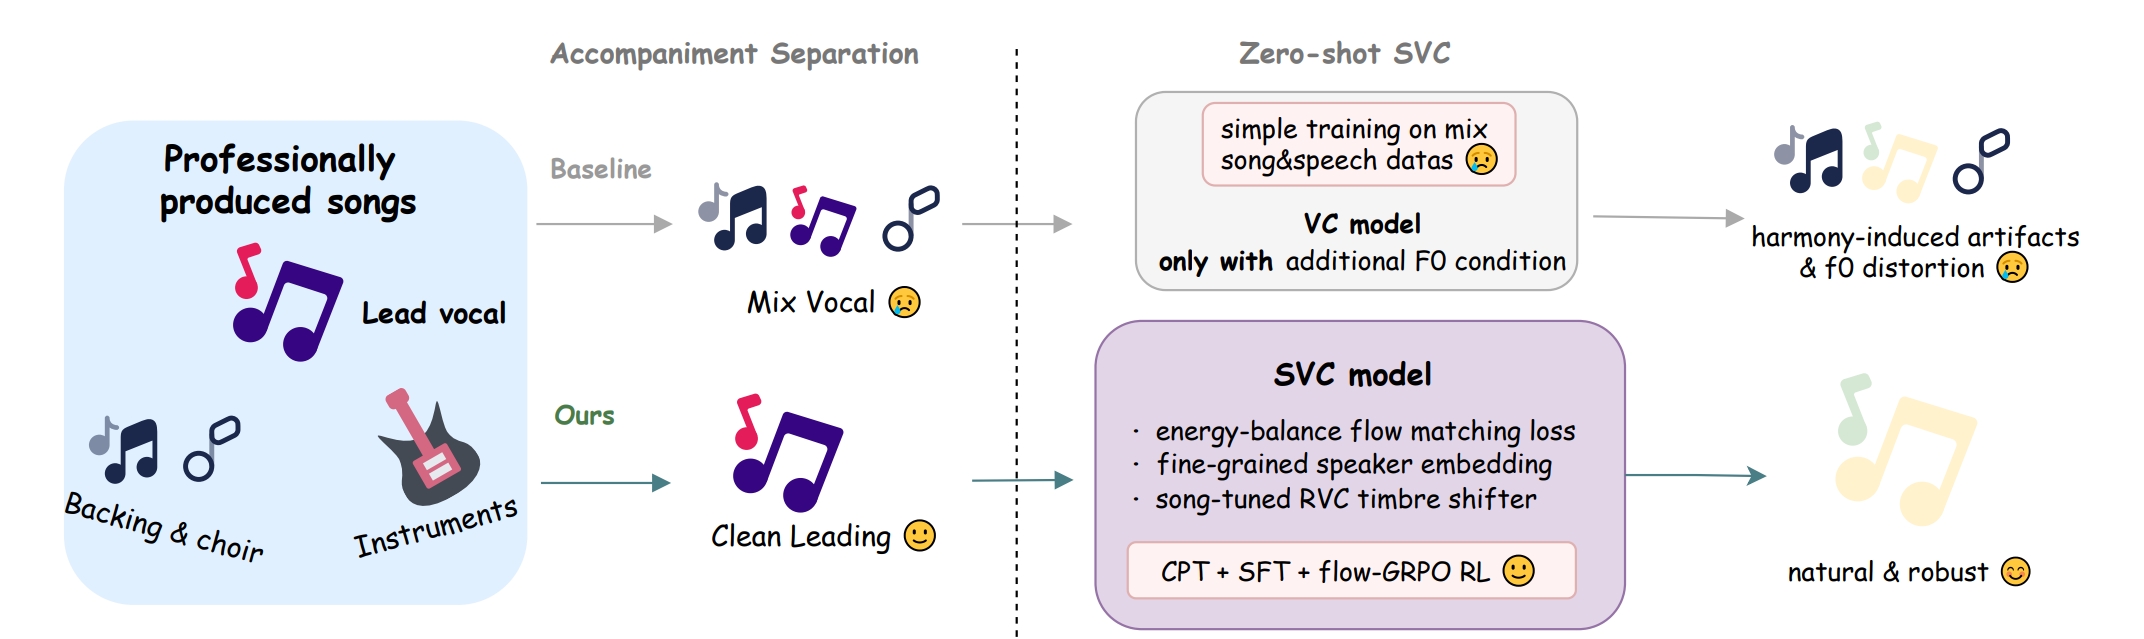 모델
HQ-SVC 및 YingMusic-SVC: 노래 음성 변환의 콘텐츠, F0, 에너지 및 음색을 분해합니다.
가창성변환 / 기술비교
기사 읽기 모델
Beat This!: DBN 엔딩 없는 비트 추적
음악 정보 검색/논문 해석
기사 읽기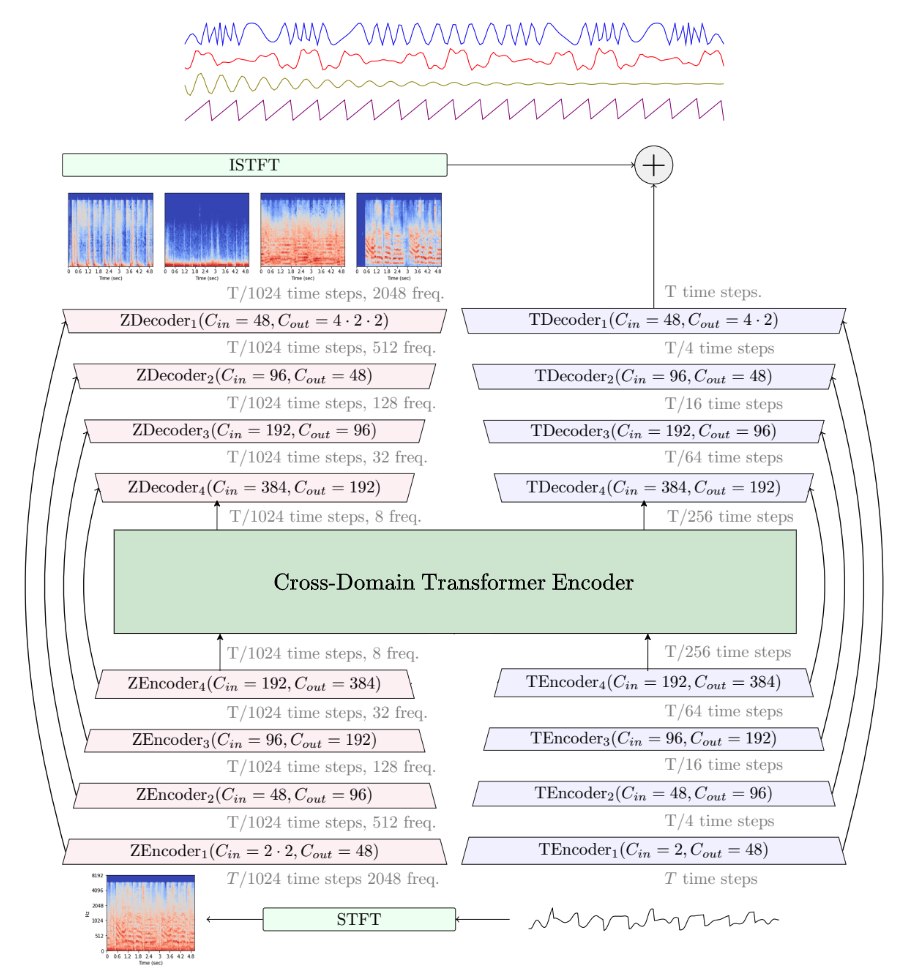 모델
Demucs v3 색소폰 모델: 14.22dB 및 협대역 A/B
기기 분리/기술 노트
기사 읽기 모델
Qwen3-TTS, Fish S2 Pro, MOSS-TTS 및 VoxCPM2: 4개의 음성 조건 인터페이스
음성합성 / 오픈모델 비교
기사 읽기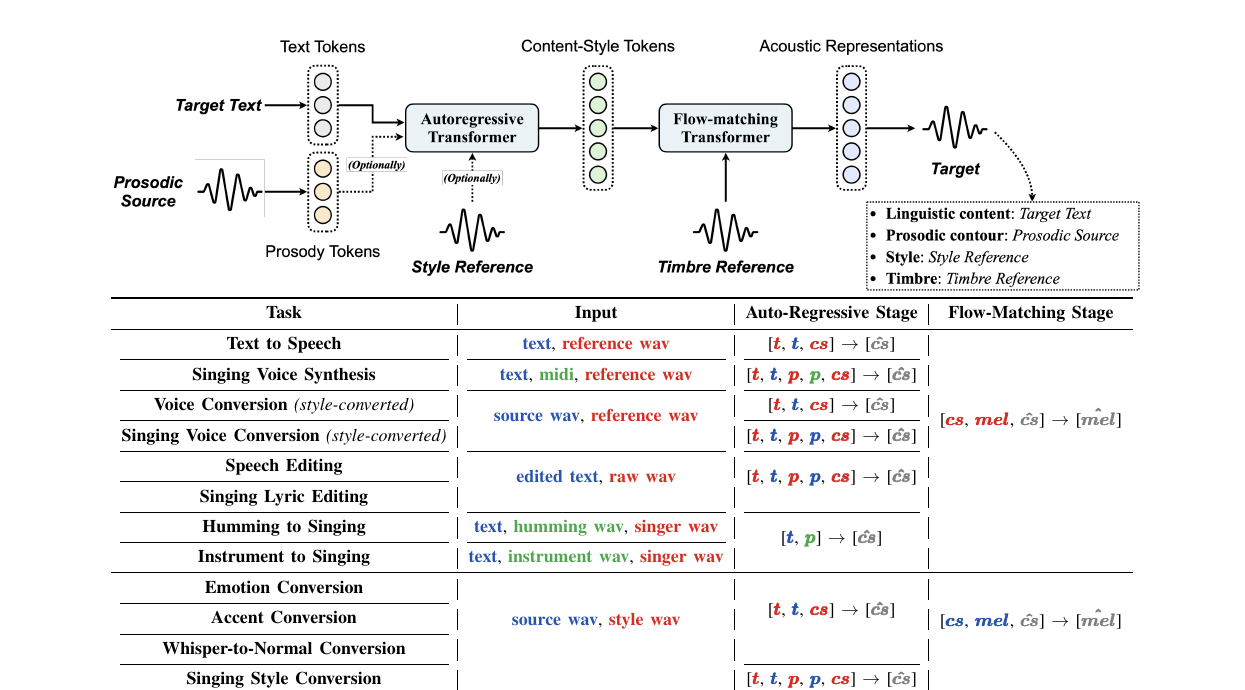 모델
Vevo2: 내용, 음색, 리듬의 세 가지 조건에 따라 노래를 재구성합니다.
노래 합성/기술 노트
기사 읽기 모델
4스템 오디오 분리 백서: Huge-SCNet이 표준 MSS 목표에 맞는 이유
TelkNet의 현재 4스템 도구는 Huge-SCNet-4stems V1.2로 전체 믹스를 vocals, drums, bass, other로 나눕니다. 이 글은 MSS 아키텍처 흐름, Mel-Band RoFormer의 강점과 한계, SCNet의 서브밴드 모델링, 공개 4스템 점수를 통해 선택 이유를 설명합니다.
기사 읽기 모델
Krea 2: Krea AI가 Raw와 Turbo 이미지 생성 가중치를 공개
Krea AI는 Krea 2 Raw와 Krea 2 Turbo를 공개 가중치로 배포했습니다. 기술 보고서는 Krea 2를 처음부터 학습한 12B 텍스트-이미지 확산 모델로 설명하며, 데이터 필터링, caption 파이프라인, 후학습, 강화학습, 안전 및 라이선스 경계를 다룹니다.
기사 읽기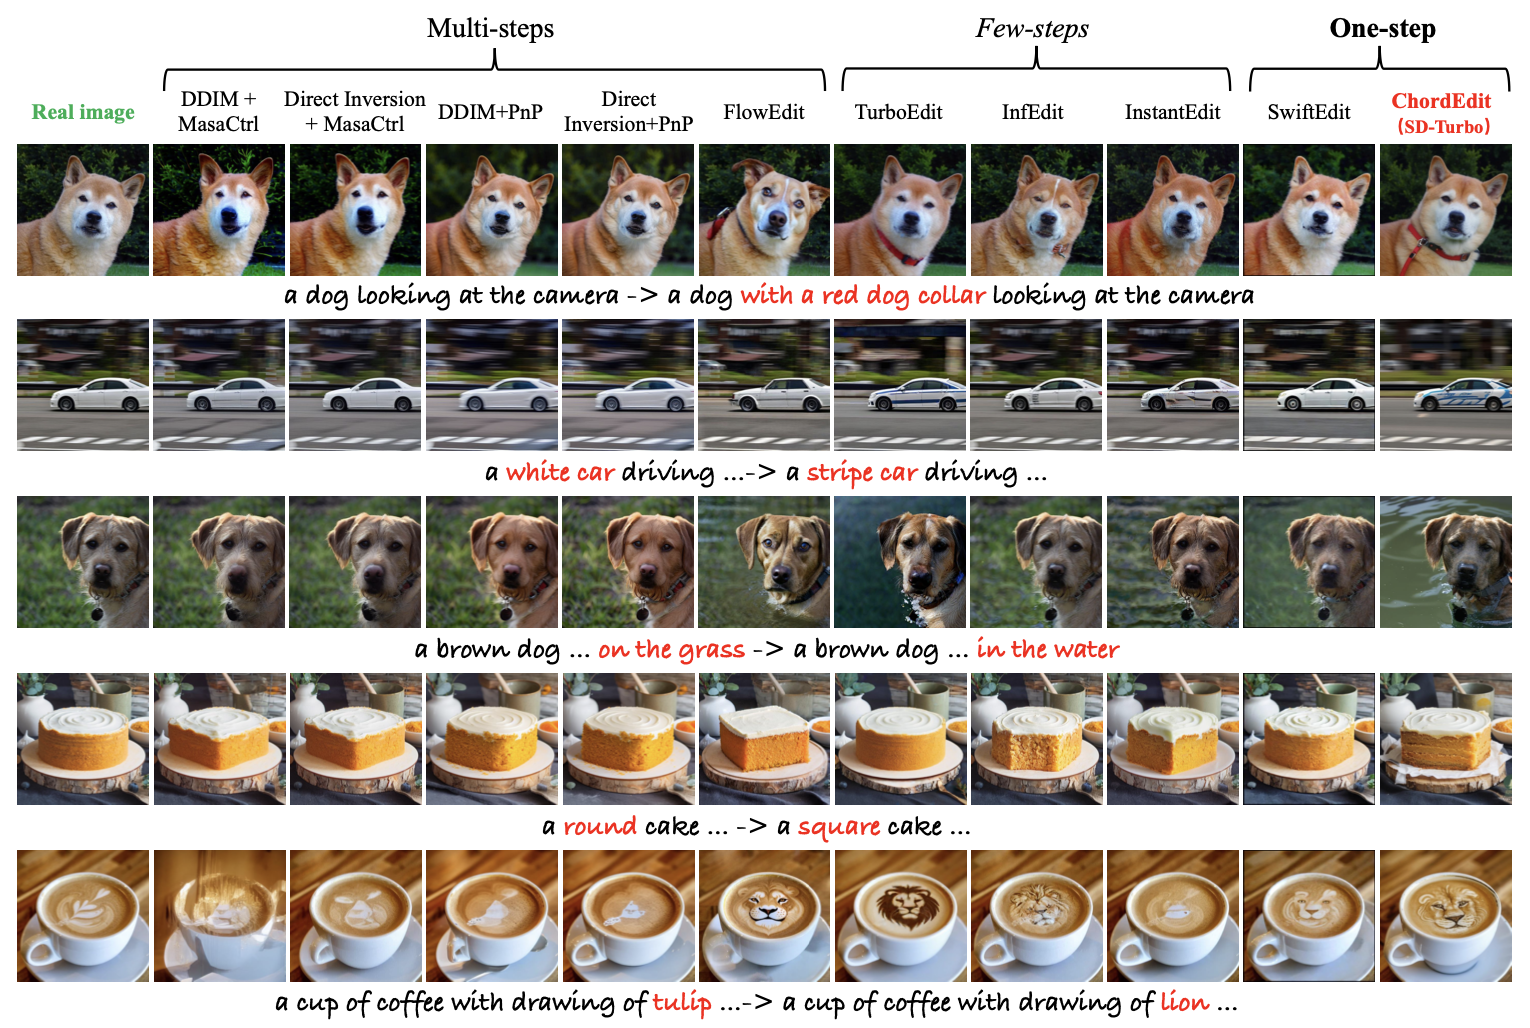 모델
ChordEdit: source-to-target 이미지 편집을 위한 one-step 저에너지 전송
ChordEdit는 CVPR 2026 Oral / Best Student Paper Honorable Mention 논문입니다. one-step 텍스트 기반 이미지 편집을 source prompt와 target prompt 사이의 동적 최적 전송 문제로 보고, Chord Control Field로 물체 왜곡과 배경 손상을 일으키는 고에너지 드리프트를 줄입니다. 이 글은 공식 demo의 source_prompt, target_prompt, seed, sample count, time-window, step-scale 값을 이미지 편집 파라미터 표면으로 매핑합니다.
기사 읽기 모델
Zyphra ZONOS2: 고충실도 음성 클로닝을 위한 오픈 TTS MoE
Zyphra는 Apache-2.0으로 ZONOS2를 공개했습니다. 8B 전체 파라미터, 약 900M 활성 파라미터, 600만 시간 이상의 음성 데이터를 바탕으로 하며, TelkNet은 이를 ZONOS2 Voice Cloning TTS 도구 경험으로 제공합니다.
기사 읽기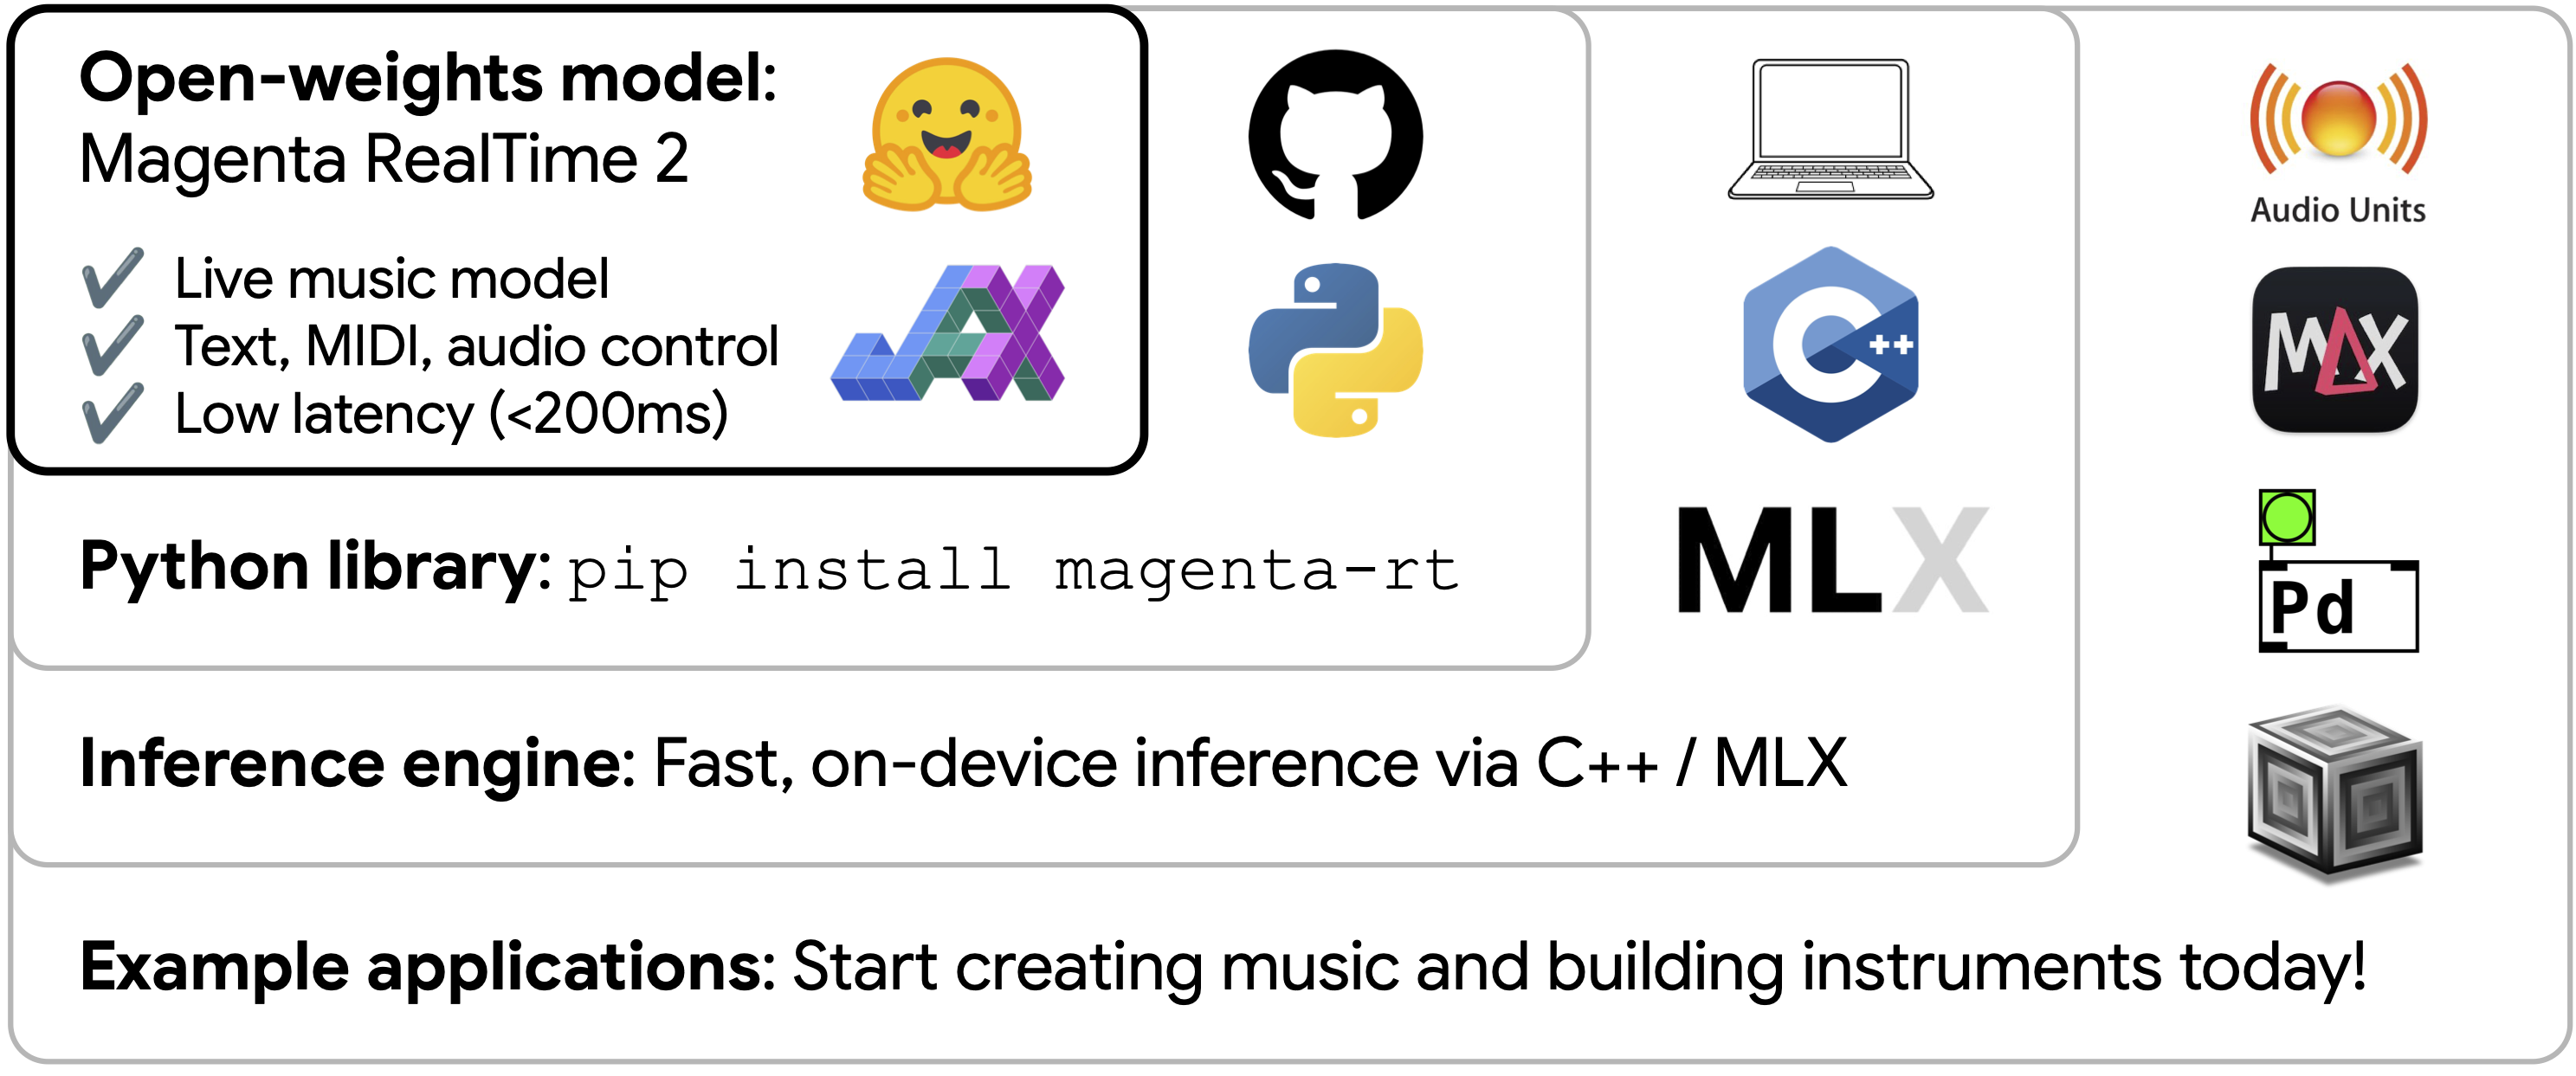 모델
Google Magenta RealTime 2: 음악 모델이 연주 가능한 악기로 바뀌는 순간
MRT2의 40ms 프레임 단위 자기회귀, 저지연 MIDI/텍스트/오디오 제어, 2.4B/230M 모델 구성, SpectroStream codec 경로, MusicCoCa 스타일 임베딩, 실시간 연주 경계를 정리한 기술 백서형 글입니다.
기사 읽기