 Modèle
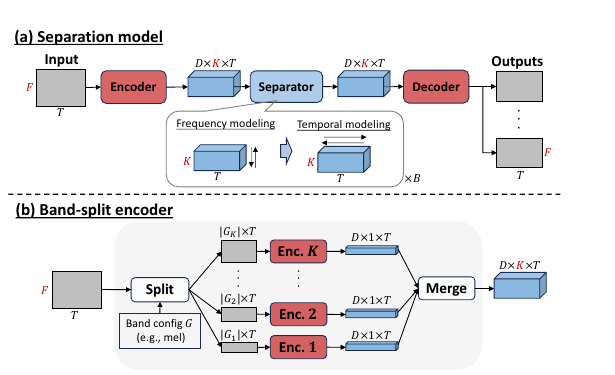
SFC-Locoformer : compression spectrale adaptative et limites de dialogue pour 11,8 dB DnR
Lecture intensive du journal / Séparation du son du cinéma et de la télévision
Lire l’article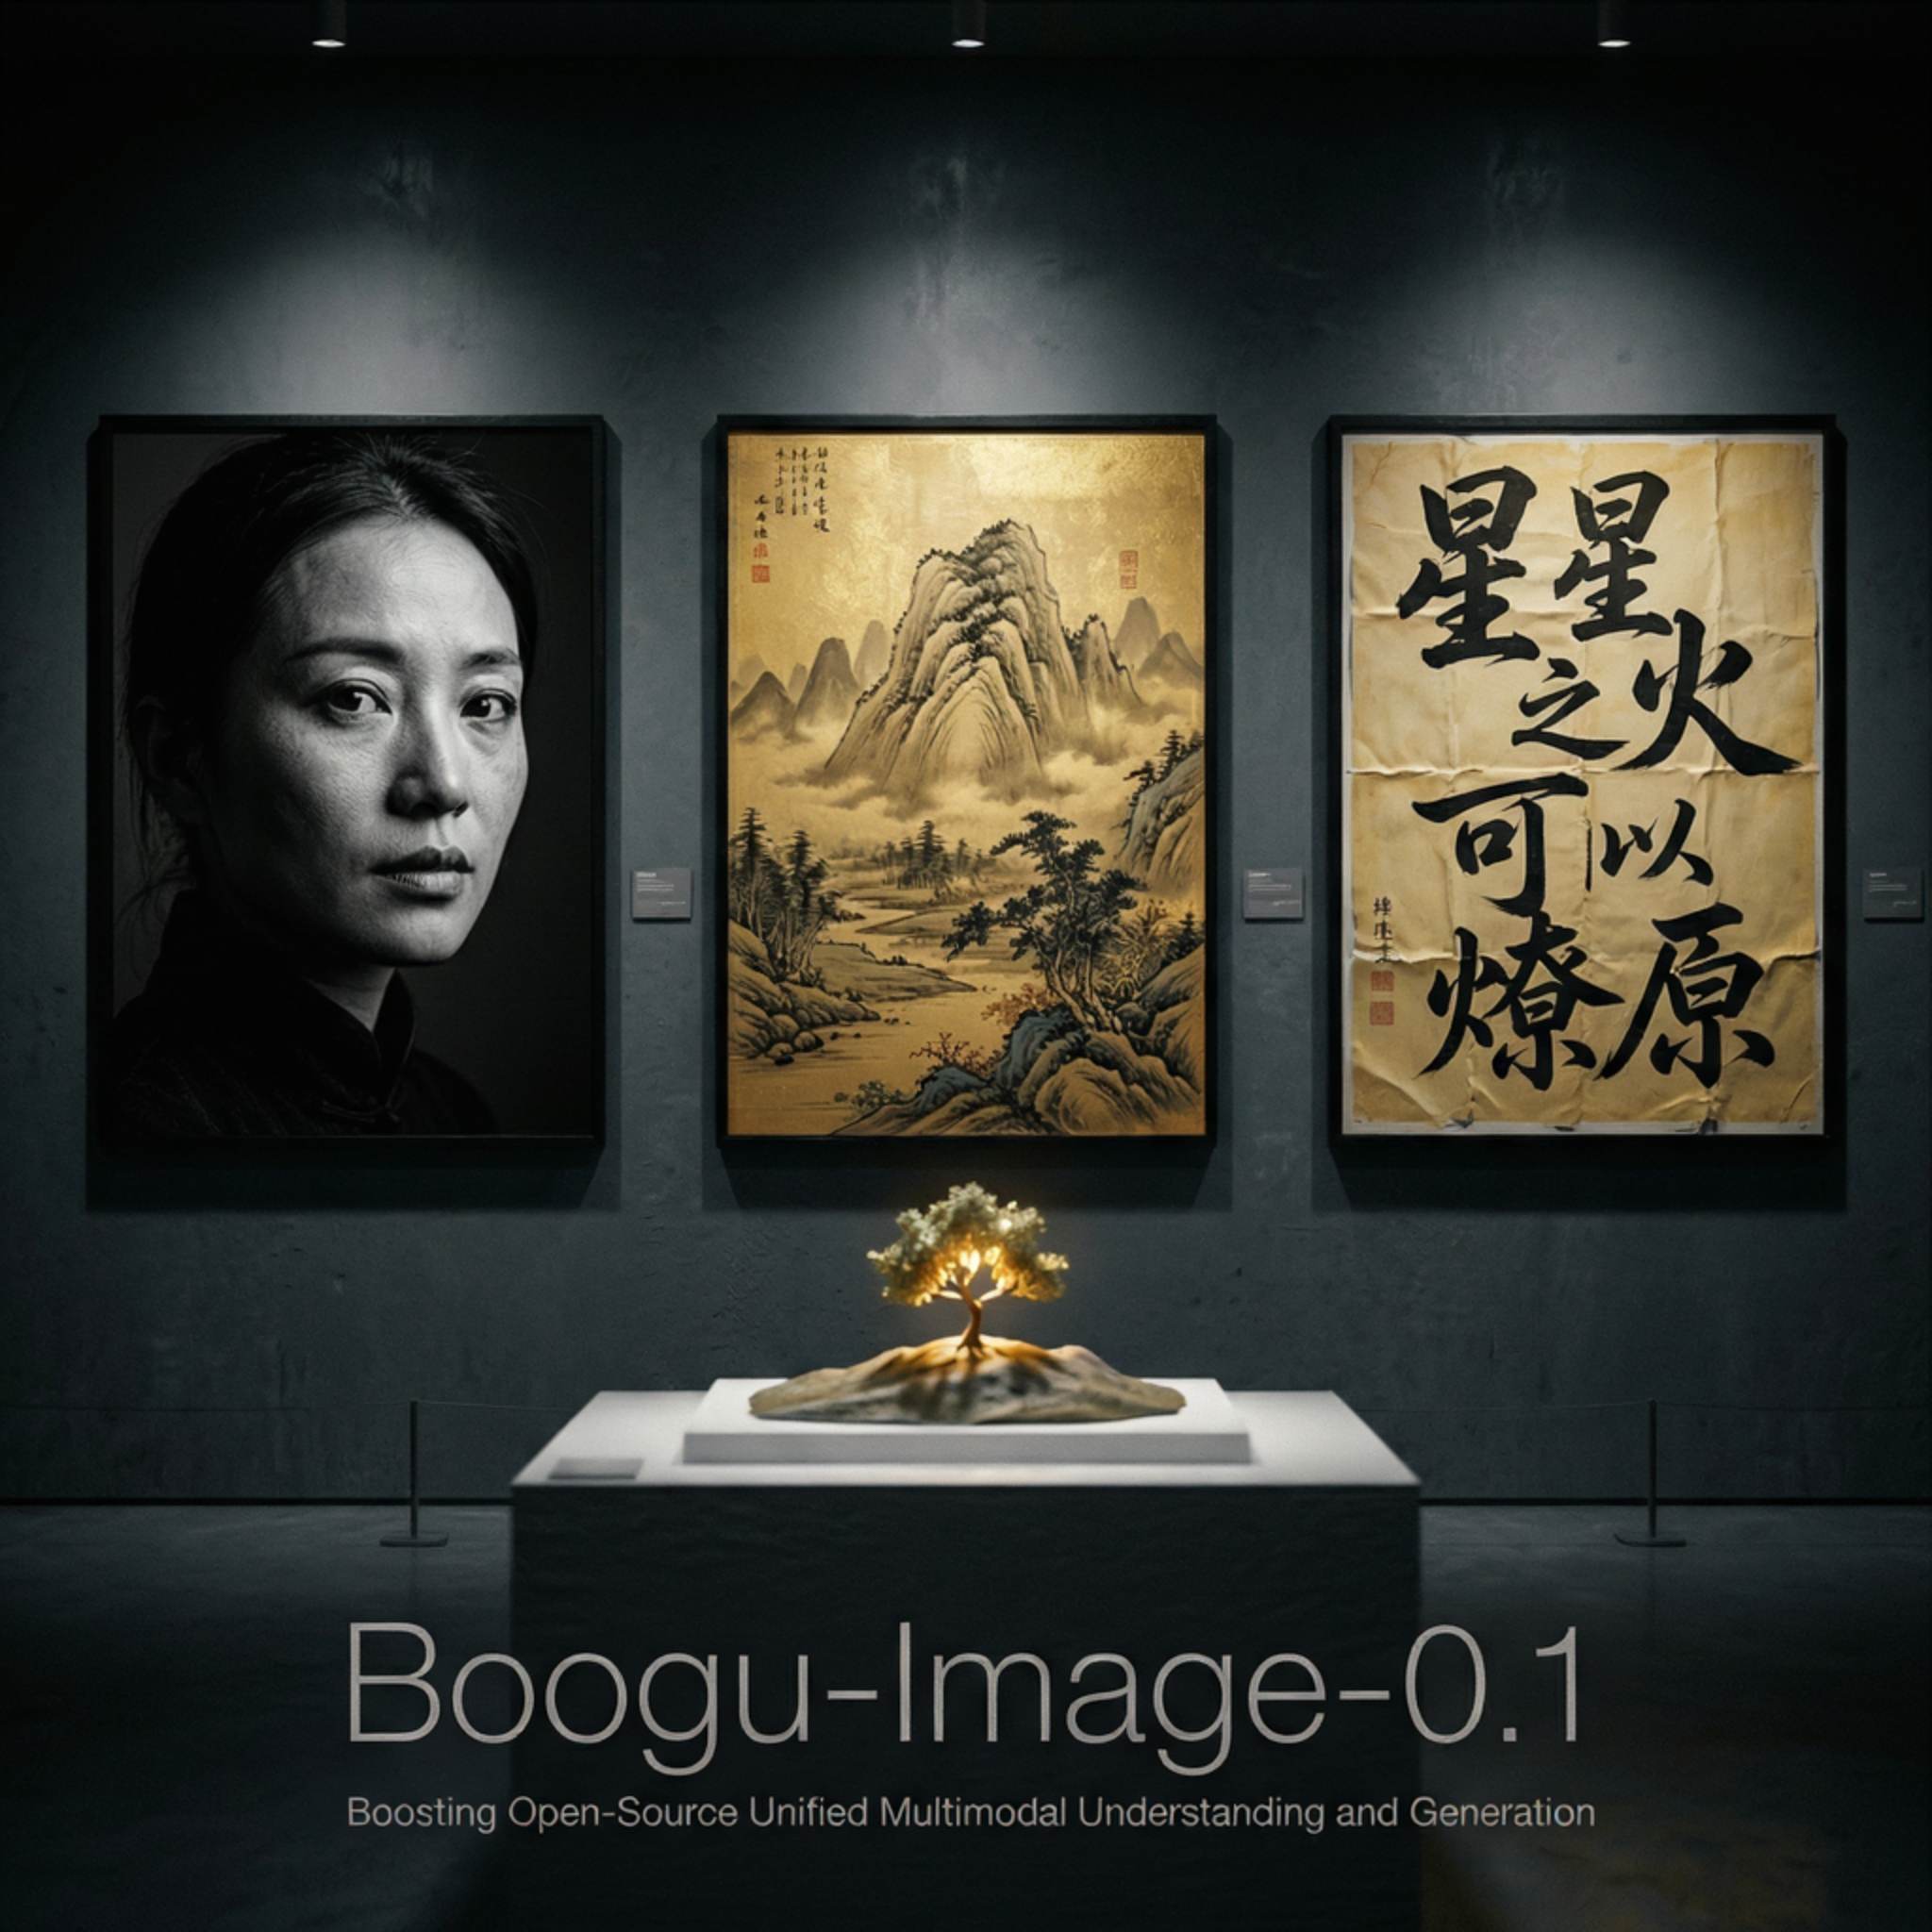 Modèle
Boogu-Image 0.1 : Division du travail et risque de distorsion entre les trois poids Base, Turbo et Edit
Anatomie du modèle/Génération et édition d'images
Lire l’article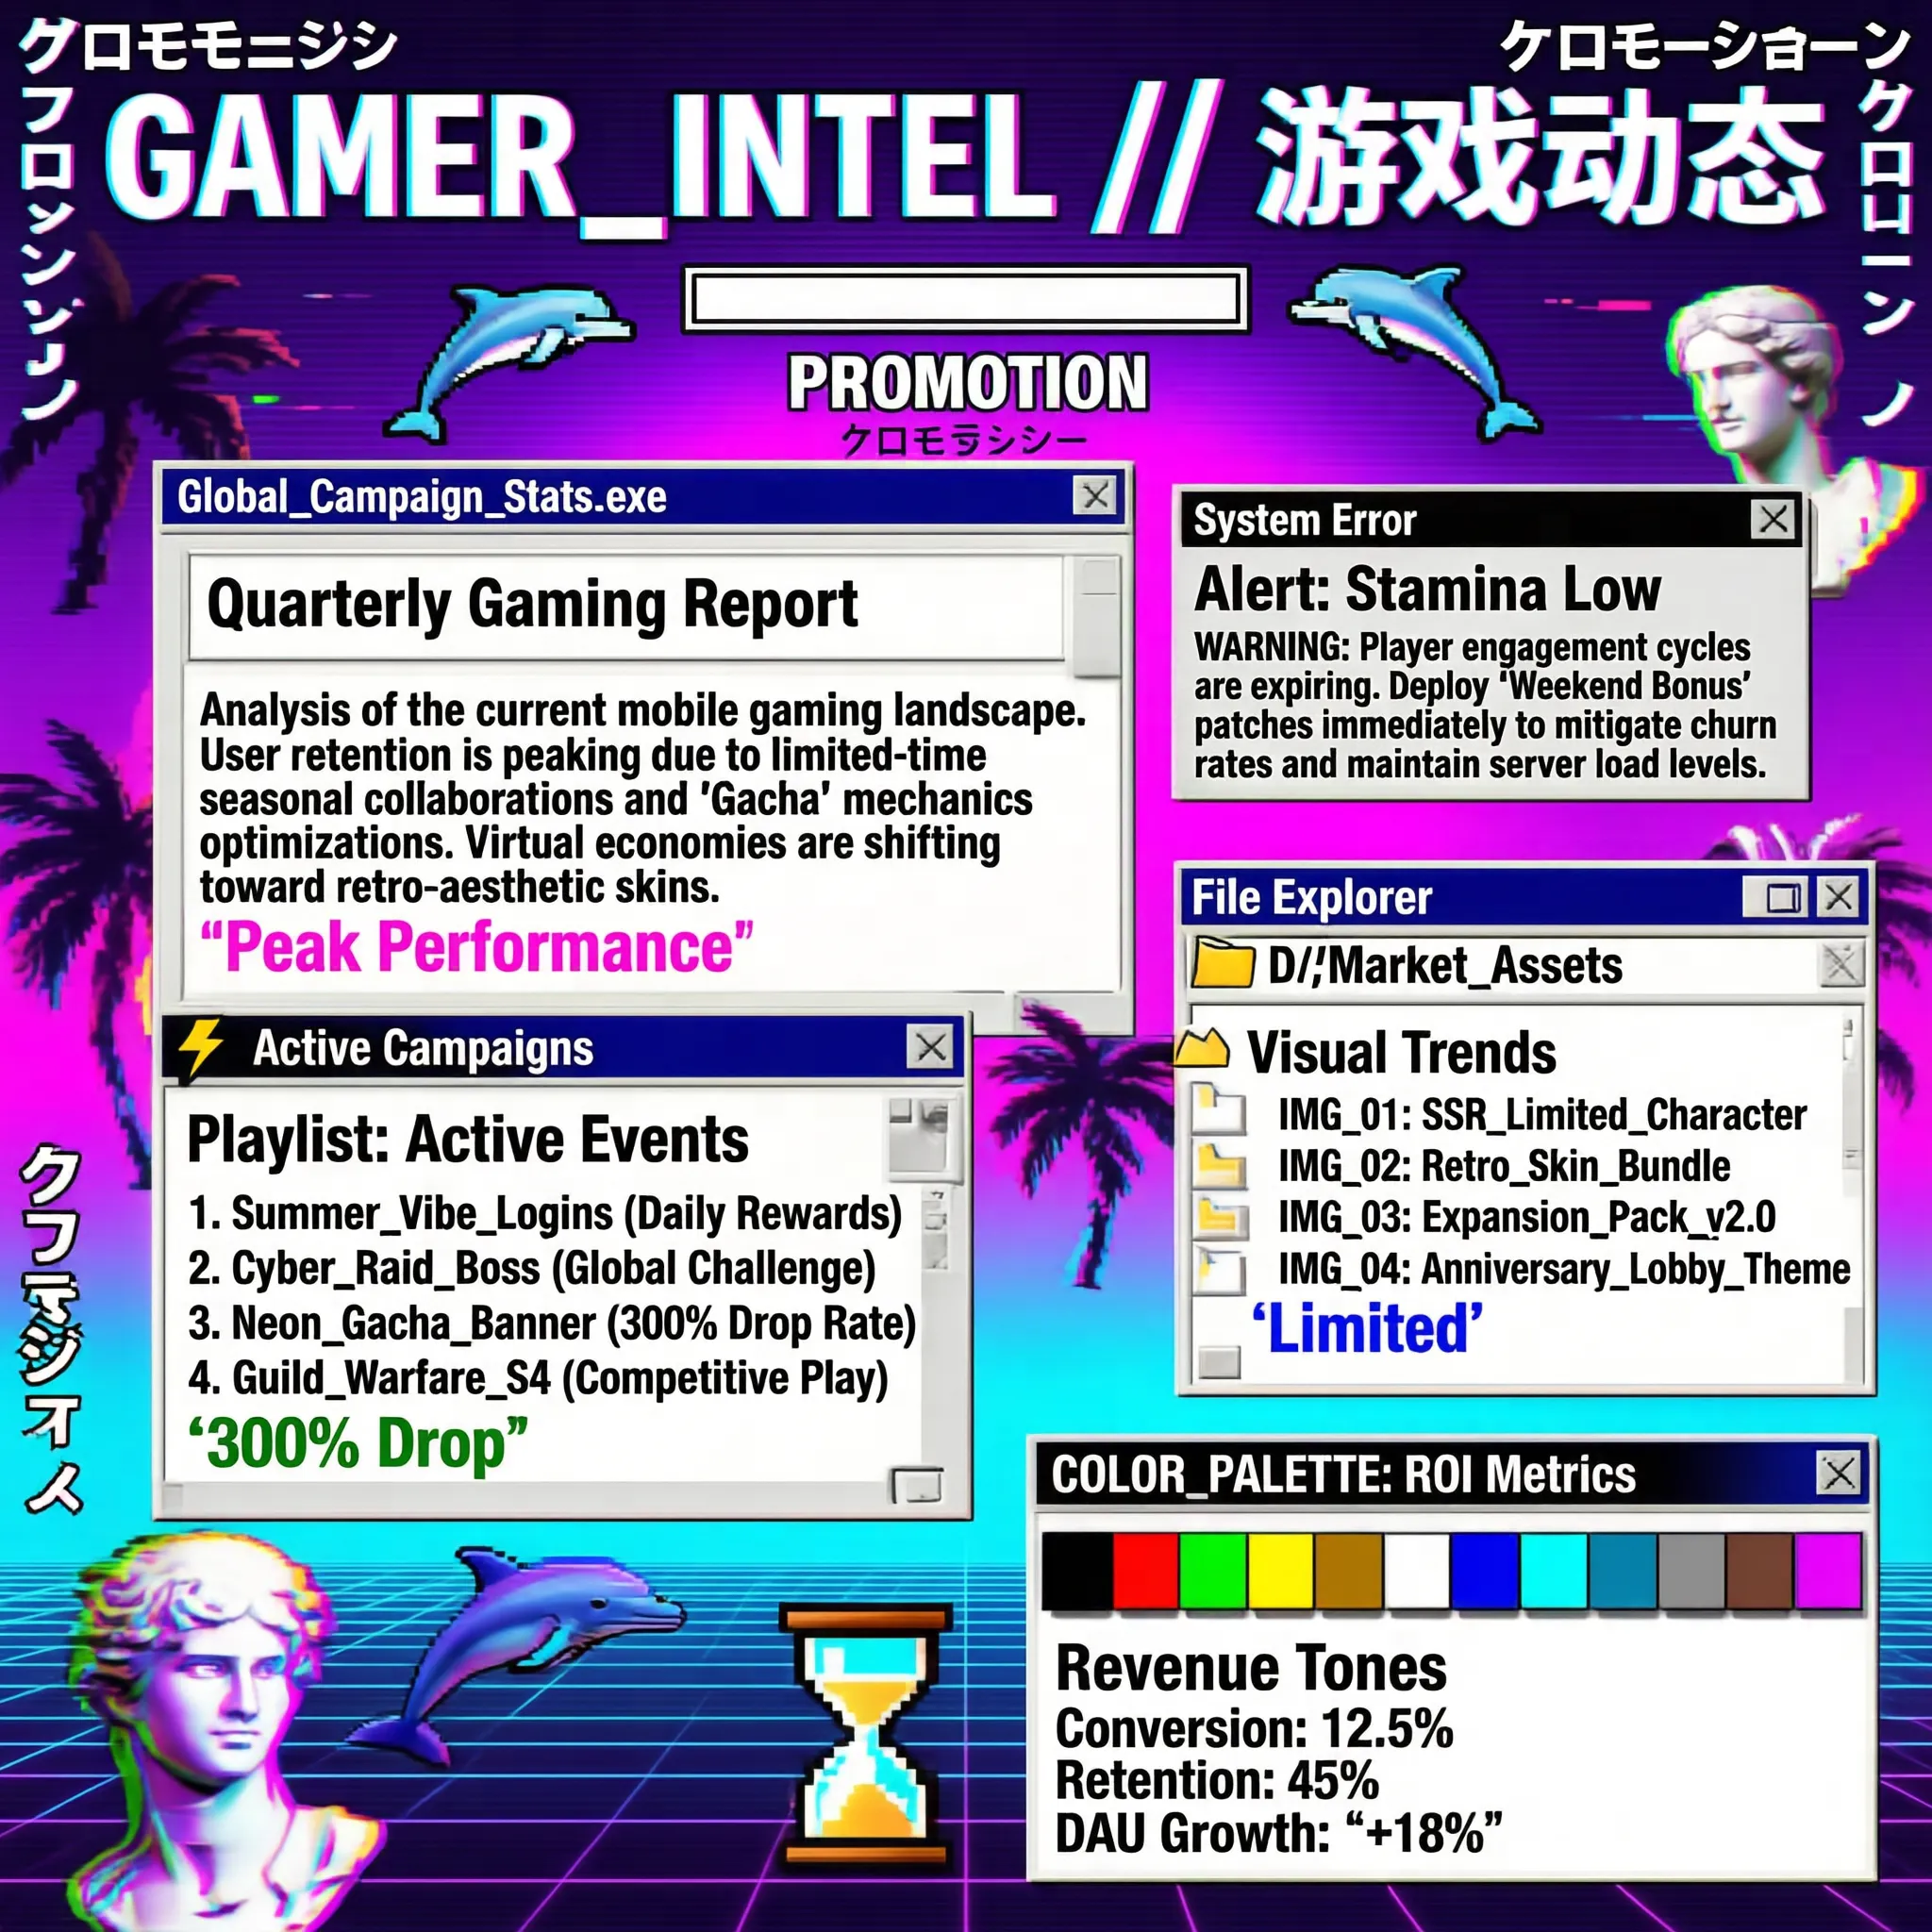 Modèle
SenseNova-U1 Infographie V2 : plage d'évaluation de 50,3 points et limites de l'infographie
Modèle spécial/génération d'infographie
Lire l’article Modèle
LongCat-AudioDiT 3.5B : Écrire les conditions des enceintes dans le transformateur de diffusion audio
Lecture intensive de l'article / Clonage vocal sans échantillon
Lire l’article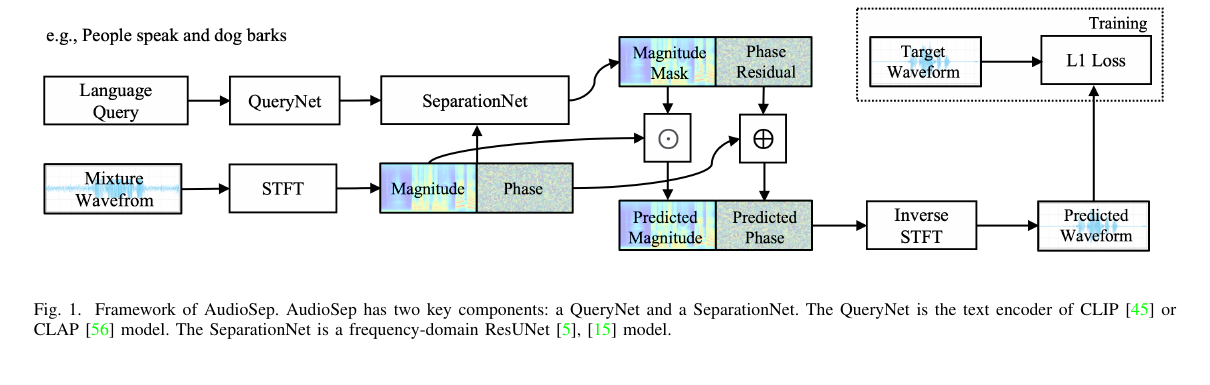 Modèle
AudioSep-Hive : séparez les sons arbitraires avec une requête textuelle
Séparation acoustique / notes techniques
Lire l’article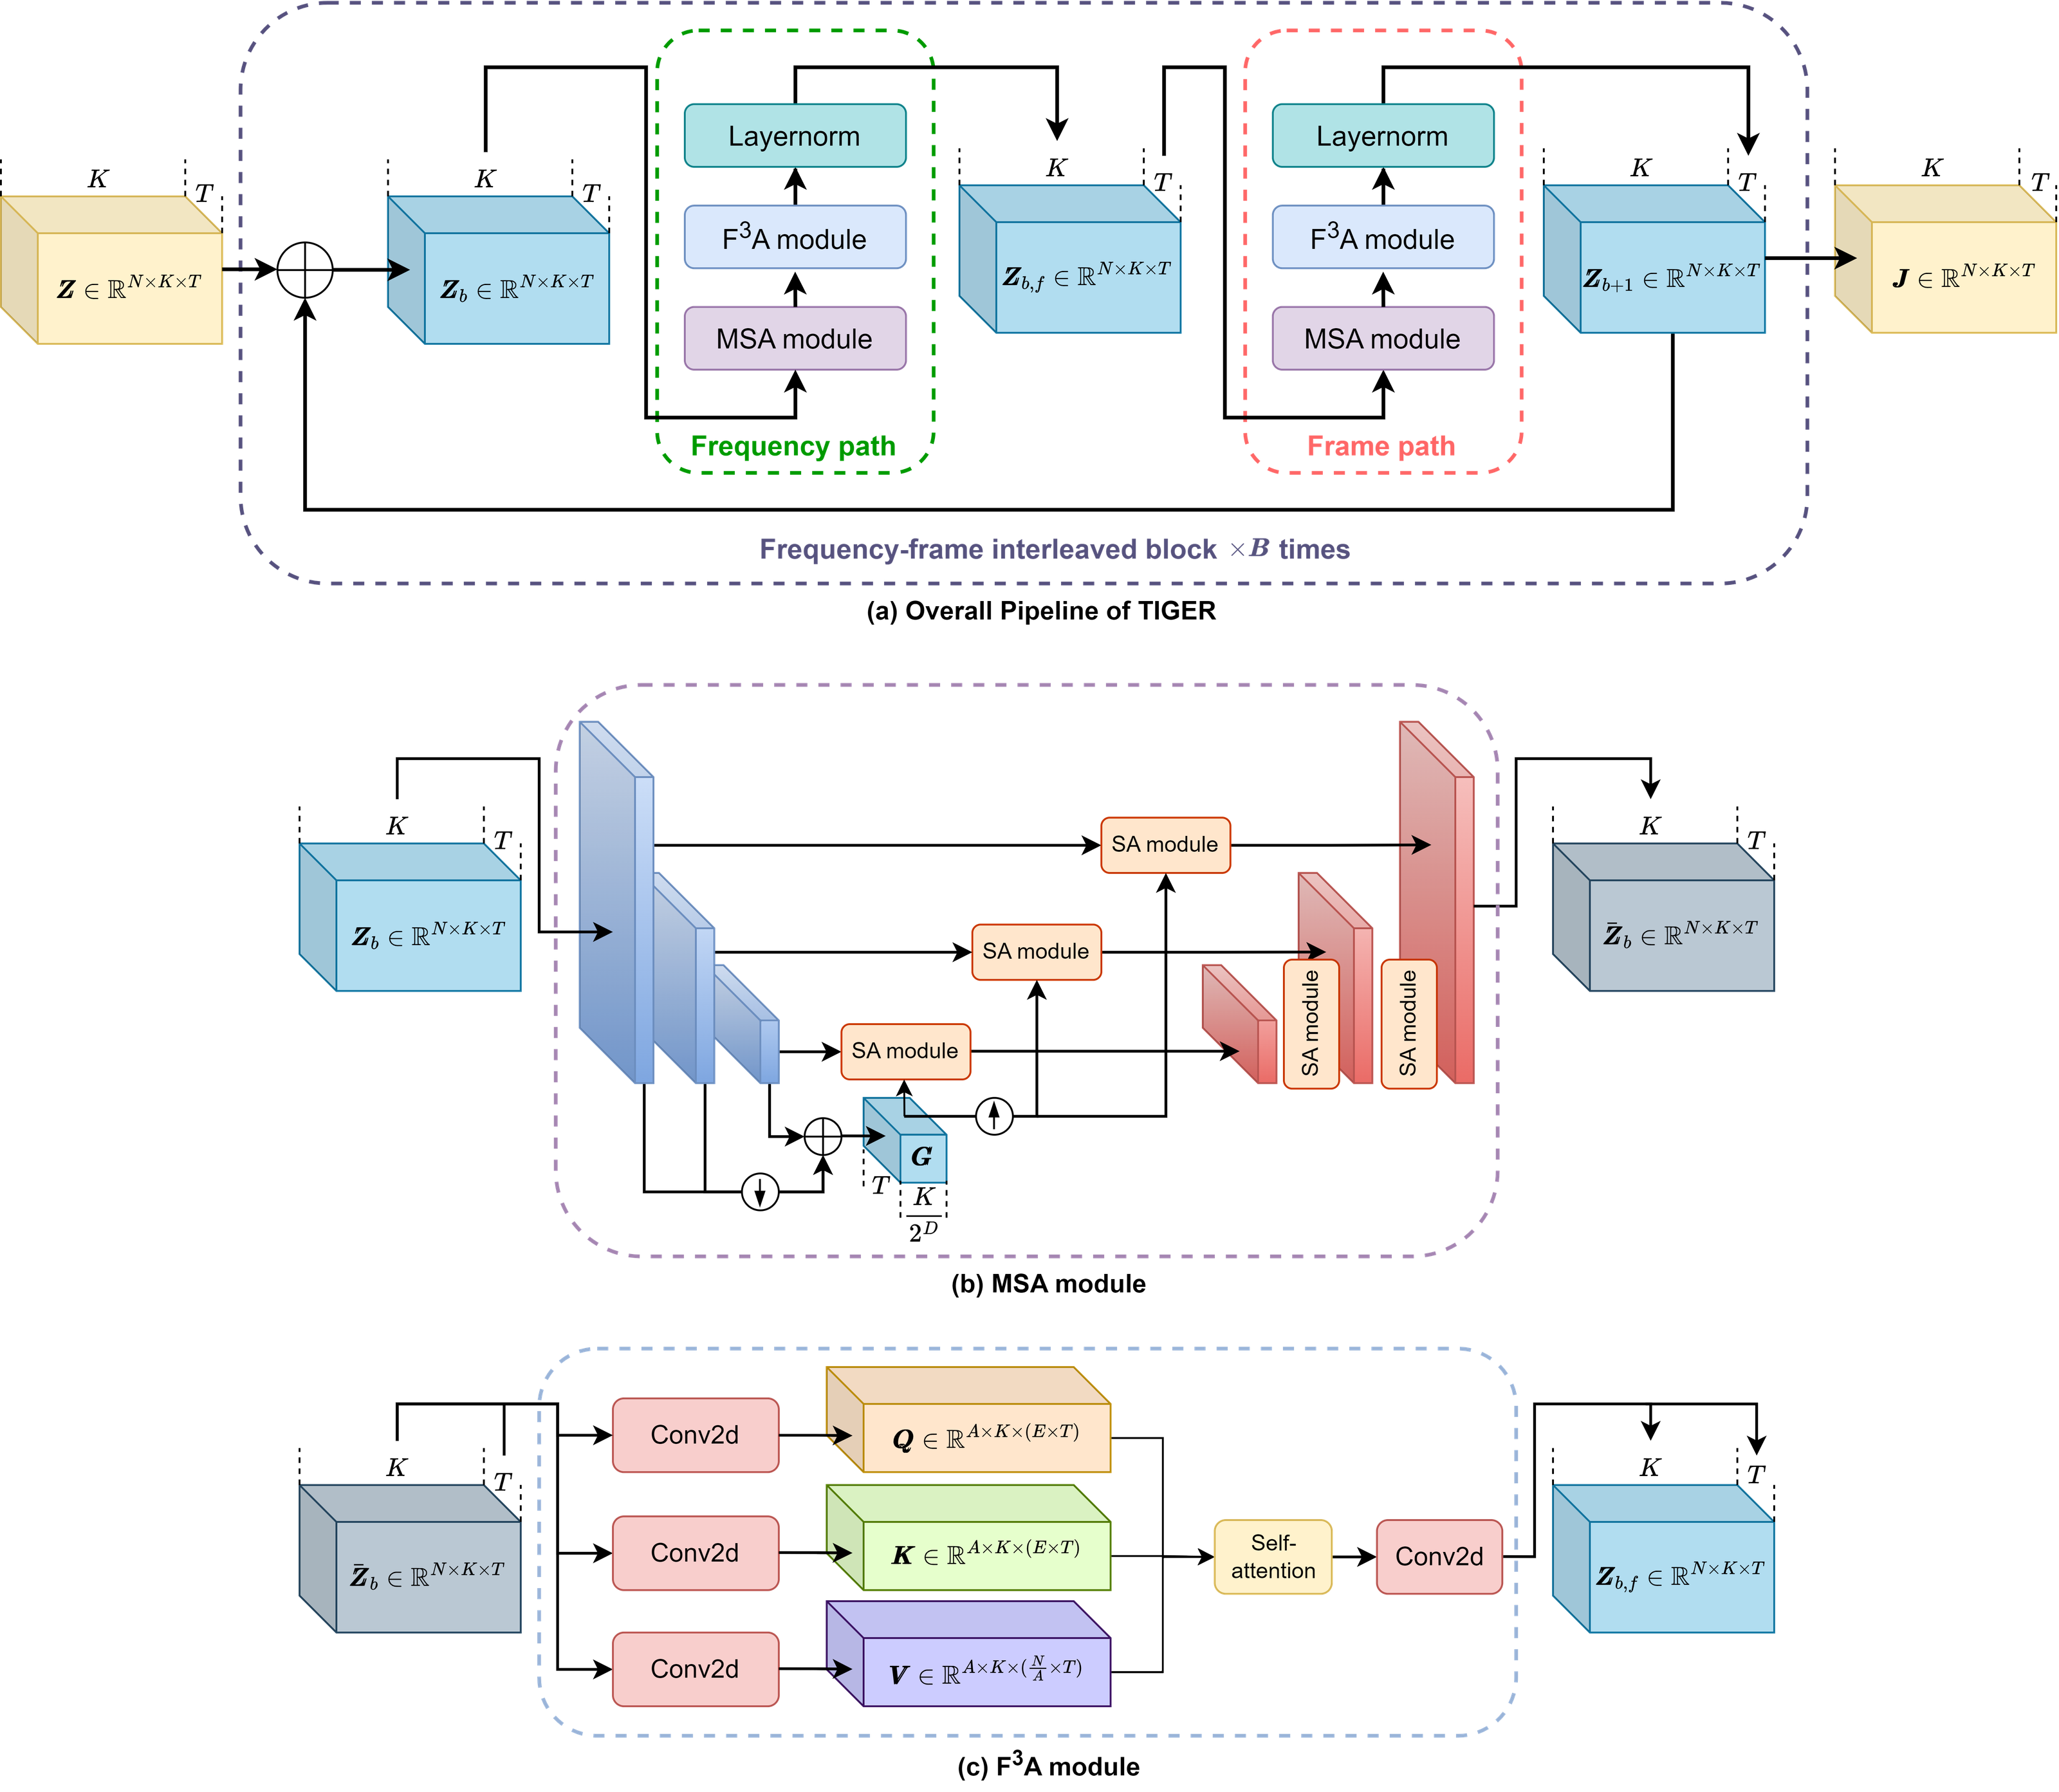 Modèle
BandIt et TIGER-DnR : La bataille pour l'allocation informatique de la séparation à trois pistes pour le cinéma et la télévision
Son cinéma et télévision / DnR
Lire l’article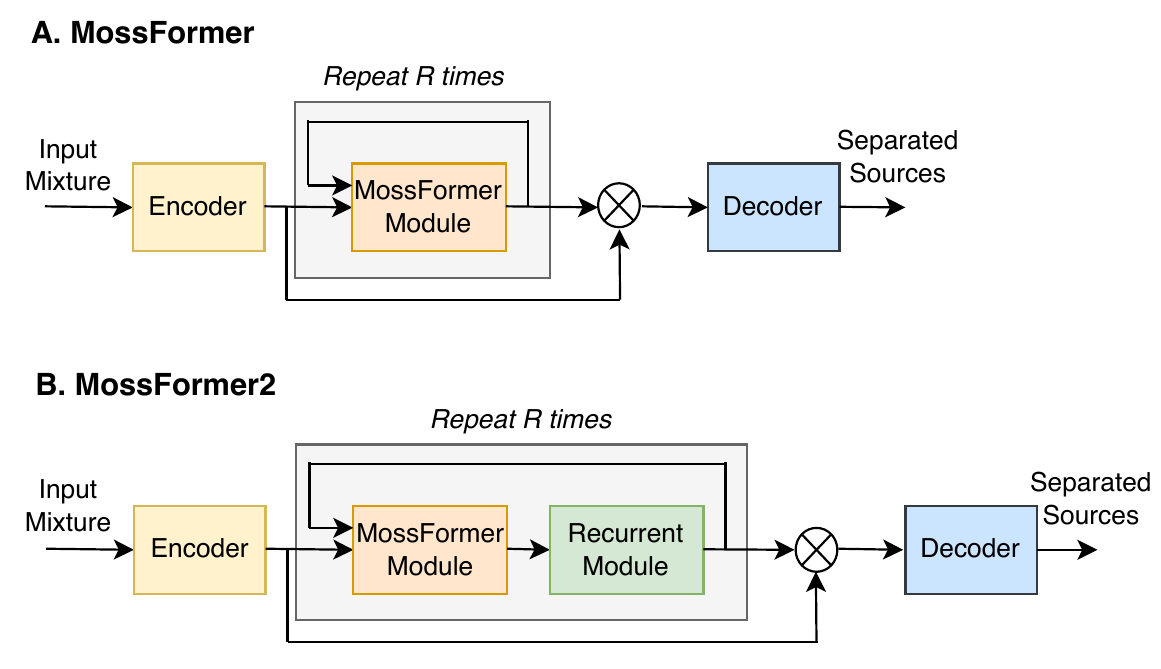 Modèle
MossFormer2 et TIGER-speech : trois divisions de tâches dans le front-end vocal
Comparaison front-end vocal/technologie
Lire l’article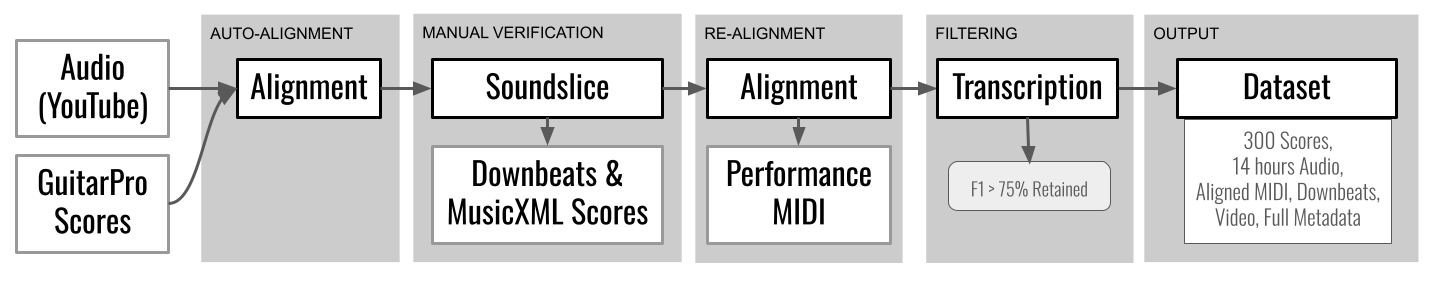 Modèle
Audio spécialisé vers MIDI : cinq modèles, cinq épreuves d'examen F1 différentes
Ces modèles disposent de poids publics, d’un branchement comme outil ou profile TelkNet, d’un choix de version explicite et d’une définition de runtime immuable. Le statut Admin commande l’affichage et l’admission des tâches ; l’activation exige E2–E4, et une route par défaut exige aussi E5.
Lire l’article Modèle
MuScriptor-large : mesure réelle et limites de 1,366 milliard de paramètres, mixage complet en MIDI multipiste
Transcription automatique de la musique
Lire l’article Modèle
Qwen-Image, Z-Image et FLUX.2 [klein] : Les différences entre trois routes d'images ouvertes
Ouvrir l'aperçu du modèle d'image/de la technologie
Lire l’article Modèle
BiRefNet, Moebius, VOSR et DDColor : quatre problèmes inverses, quatre voies d'échec
Restauration d'image / comparaison de modèles spéciaux
Lire l’article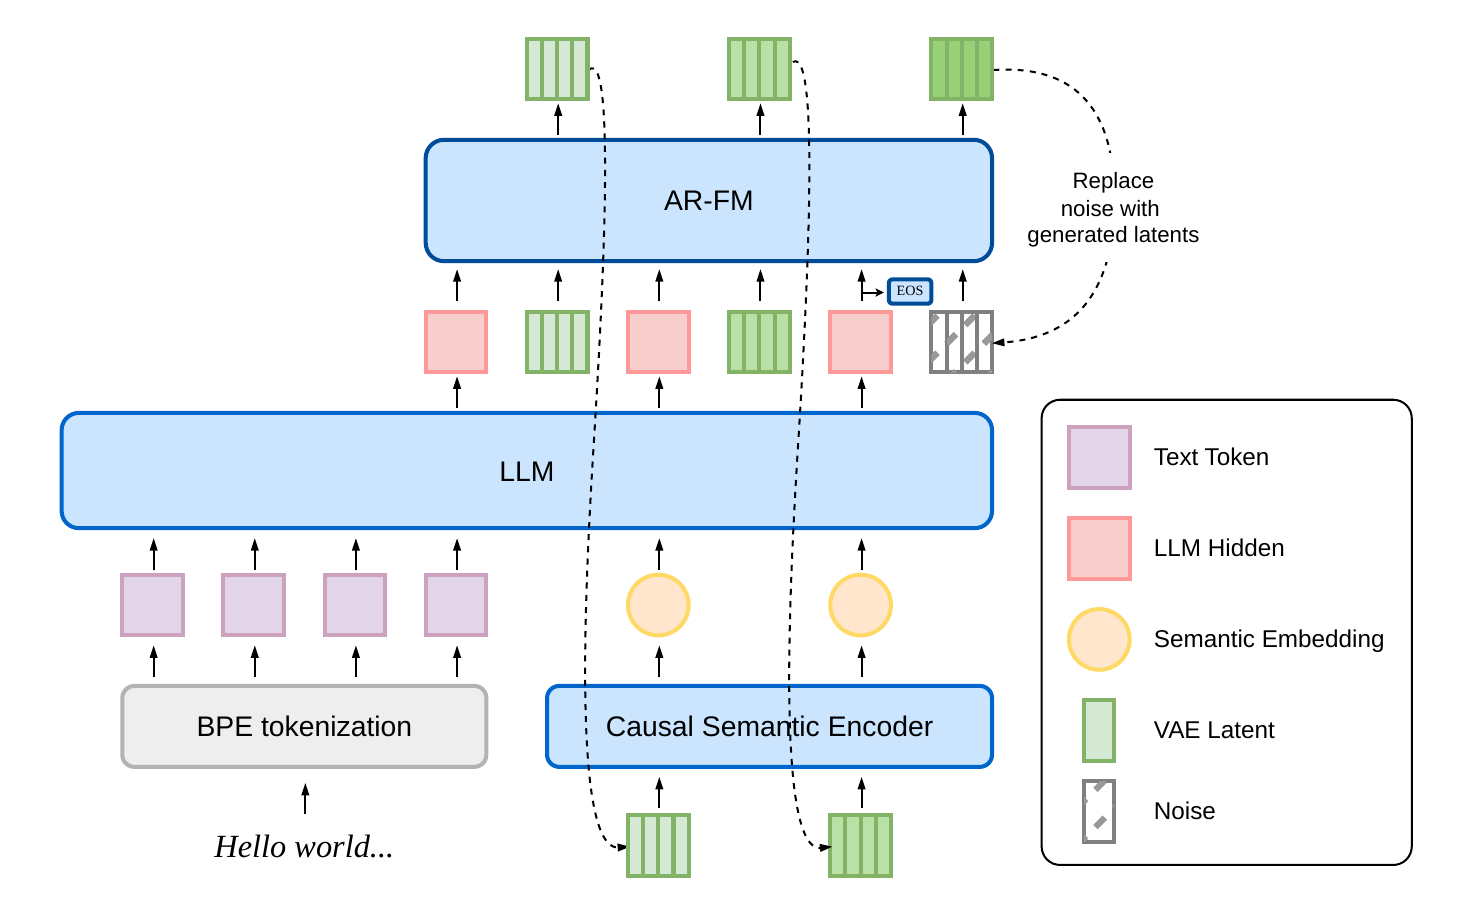 Modèle
dots.tts : variables latentes acoustiques continues, adaptation de flux et parole longue portée de 48 kHz
Synthèse vocale / Lecture intensive d'articles
Lire l’article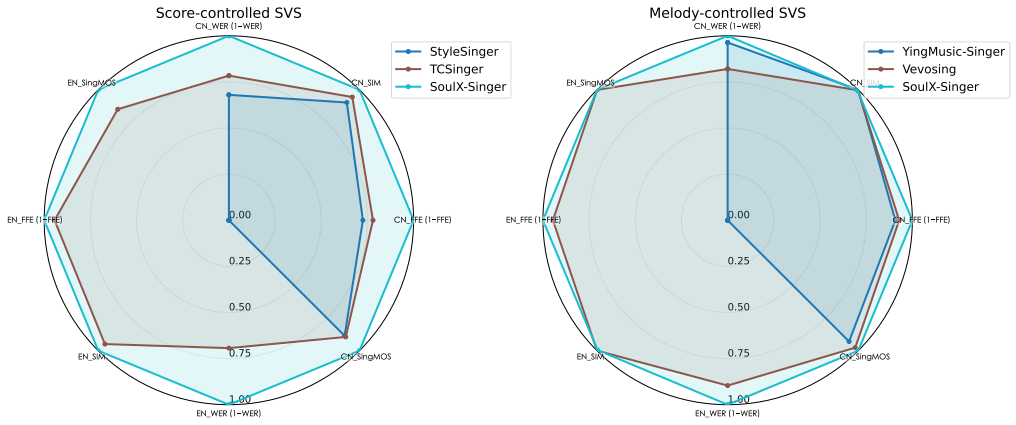 Modèle
SoulX-Singer et YingMusic-Singer-Plus : partition et référence mélodique, deux voies de synthèse vocale chantée
Synthèse chantée / comparaison d'itinéraires
Lire l’article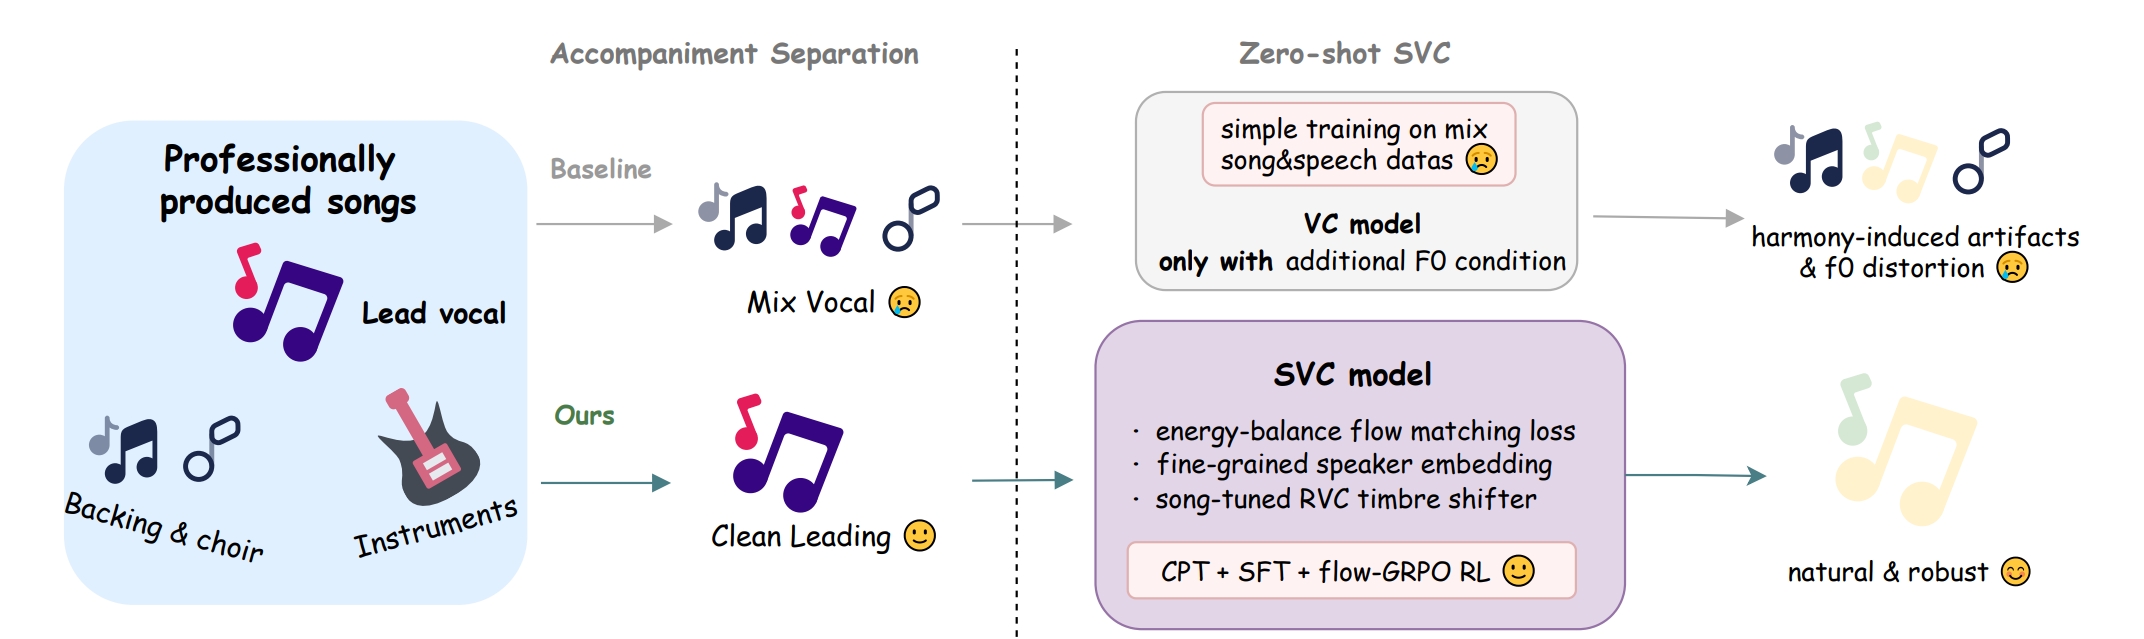 Modèle
HQ-SVC et YingMusic-SVC : démantèlement du contenu, F0, énergie et timbre de la conversion de la voix chantée
Conversion de voix chantée/Comparaison de technologies
Lire l’article Modèle
Beat This ! : suivi des battements sans fin du DBN
Récupération d'informations musicales / interprétation papier
Lire l’article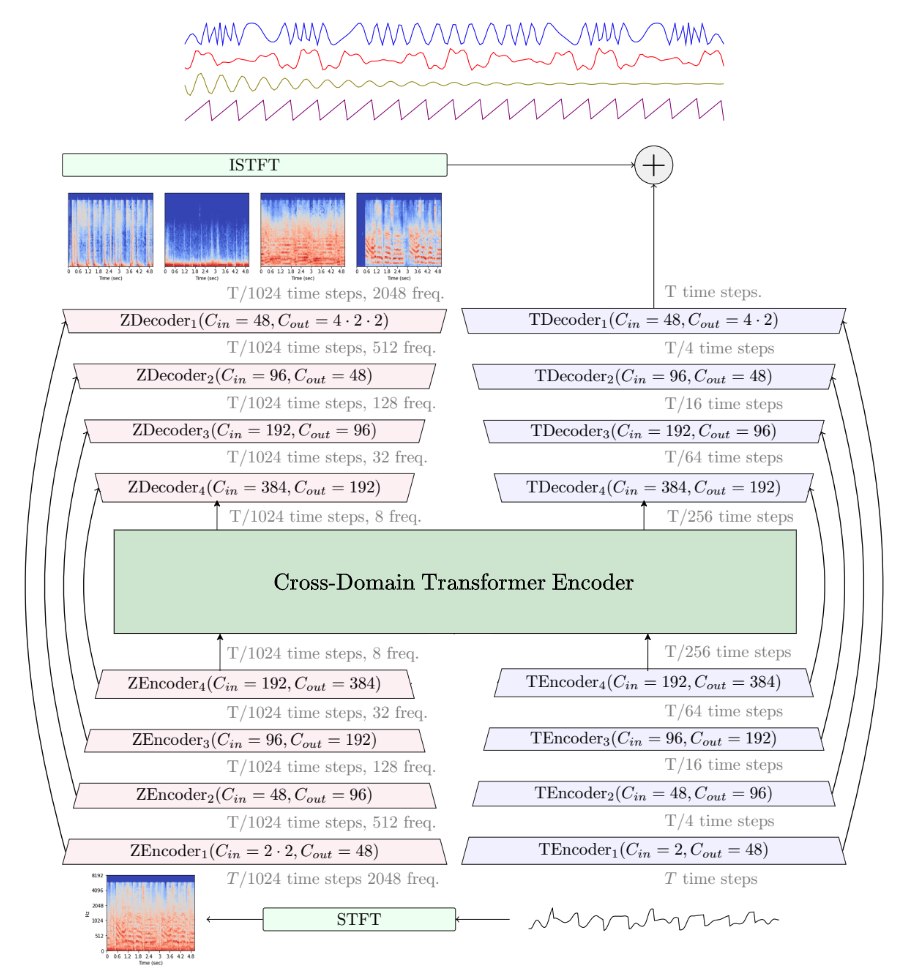 Modèle
 de saxophone Demucs v3 : 14,22 dB et bande étroite A/B
Séparation des instruments/Notes techniques
Lire l’article Modèle
Qwen3-TTS, Fish S2 Pro, MOSS-TTS et VoxCPM2 : quatre interfaces de condition vocale
Synthèse vocale / comparaison de modèles ouverts
Lire l’article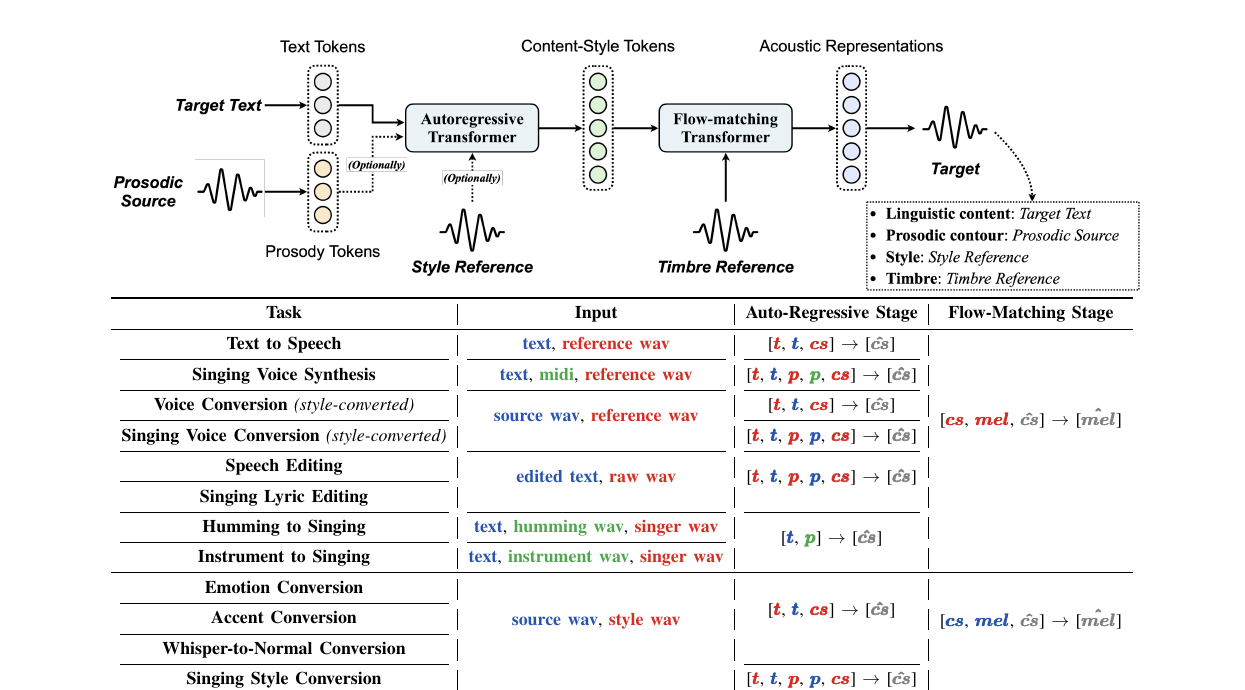 Modèle
Vevo2 : Réorganisation du chant basée sur trois conditions : contenu, timbre et rythme.
Synthèse chantée/notes techniques Article
Lire l’article Modèle
Séparation audio quatre stems : pourquoi Huge-SCNet correspond à la cible MSS
L’outil quatre stems actuel de TelkNet utilise Huge-SCNet-4stems V1.2 pour diviser un mix complet en voix, batterie, basse et autres. L’article explique ce choix par l’historique MSS, les forces et limites de Mel-Band RoFormer, la modélisation en sous-bandes de SCNet et les scores publics quatre stems.
Lire l’article Modèle
Krea 2 : Krea AI publie les poids Raw et Turbo pour la génération d'images
Krea AI publie Krea 2 Raw et Krea 2 Turbo sous forme de poids ouverts. Le rapport technique décrit Krea 2 comme un modèle de diffusion texte-vers-image 12B entraîné depuis zéro et détaille le filtrage des données, le pipeline de captions, le post-entraînement, l'apprentissage par renforcement et les limites de sécurité et de licence.
Lire l’article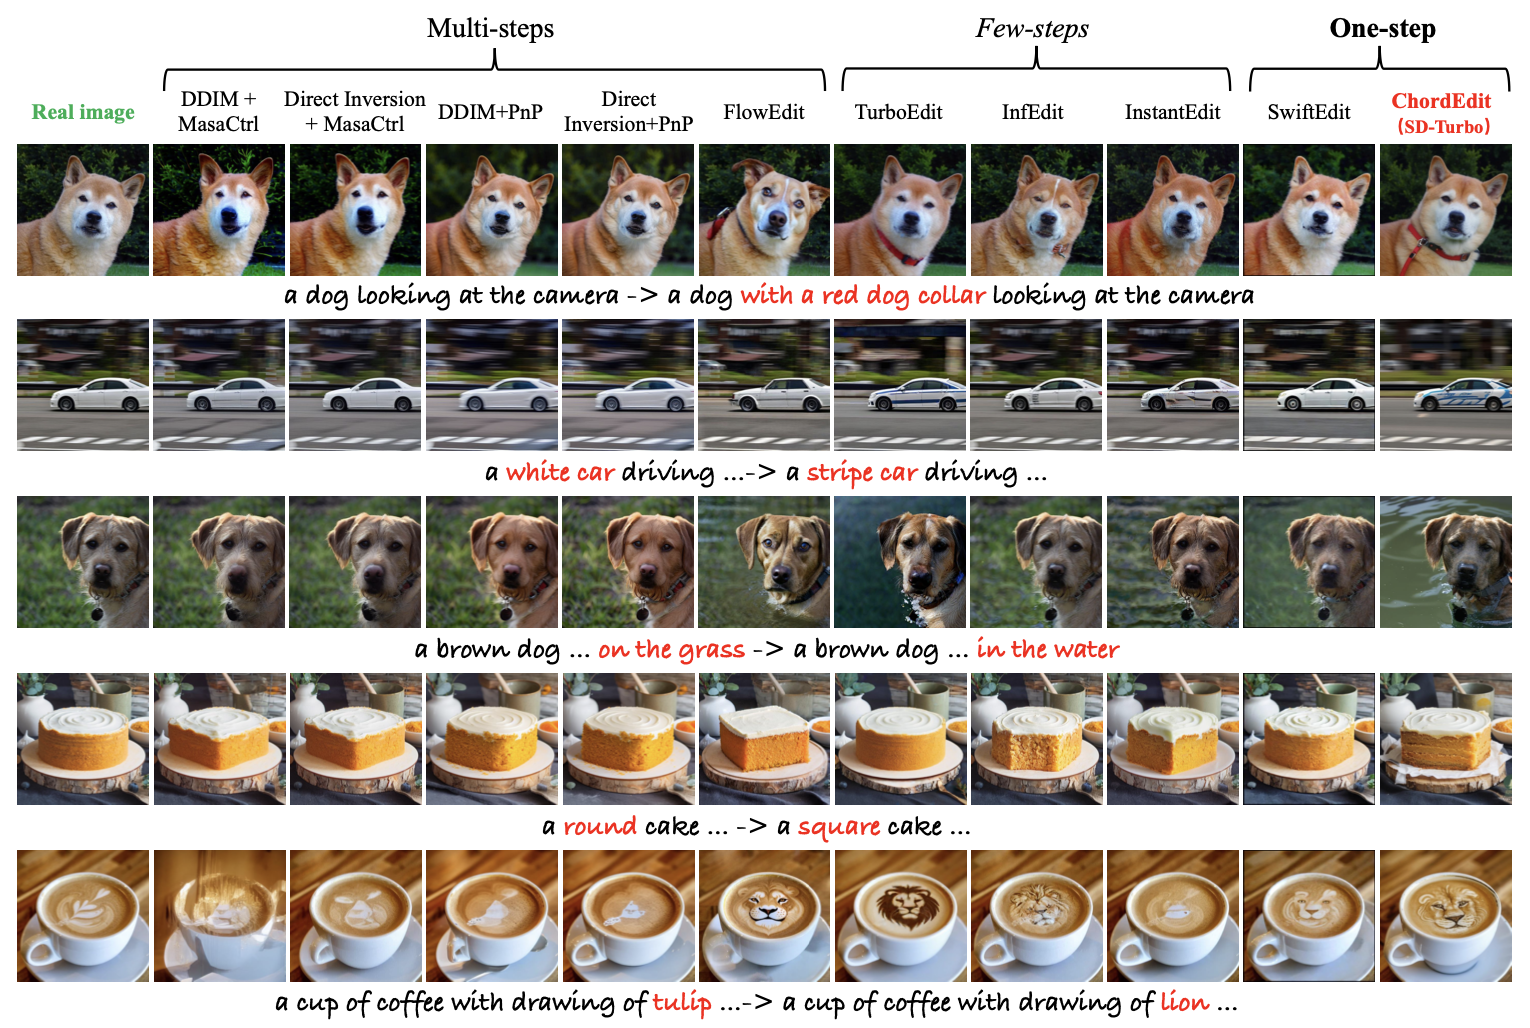 Modèle
ChordEdit : transport basse énergie en une étape pour l'édition source-to-target
ChordEdit est un paper CVPR 2026 Oral / Best Student Paper Honorable Mention. Il formule l'édition d'image guidée par texte en une étape comme un problème de transport optimal dynamique entre source prompt et target prompt, puis utilise un Chord Control Field pour réduire la dérive haute énergie qui déforme les objets et abîme les arrière-plans. L'article associe la méthode à une surface d'édition avec source_prompt, target_prompt, seed, sample count, time-window et step-scale issus de la demo officielle.
Lire l’article Modèle
Zyphra ZONOS2 : un TTS MoE ouvert pour le clonage vocal haute fidélité
Zyphra publie ZONOS2 sous Apache-2.0 : 8B paramètres au total, environ 900M actifs dans une architecture MoE TTS et plus de 6M heures de parole. TelkNet le présente comme l'outil ZONOS2 Voice Cloning TTS.
Lire l’article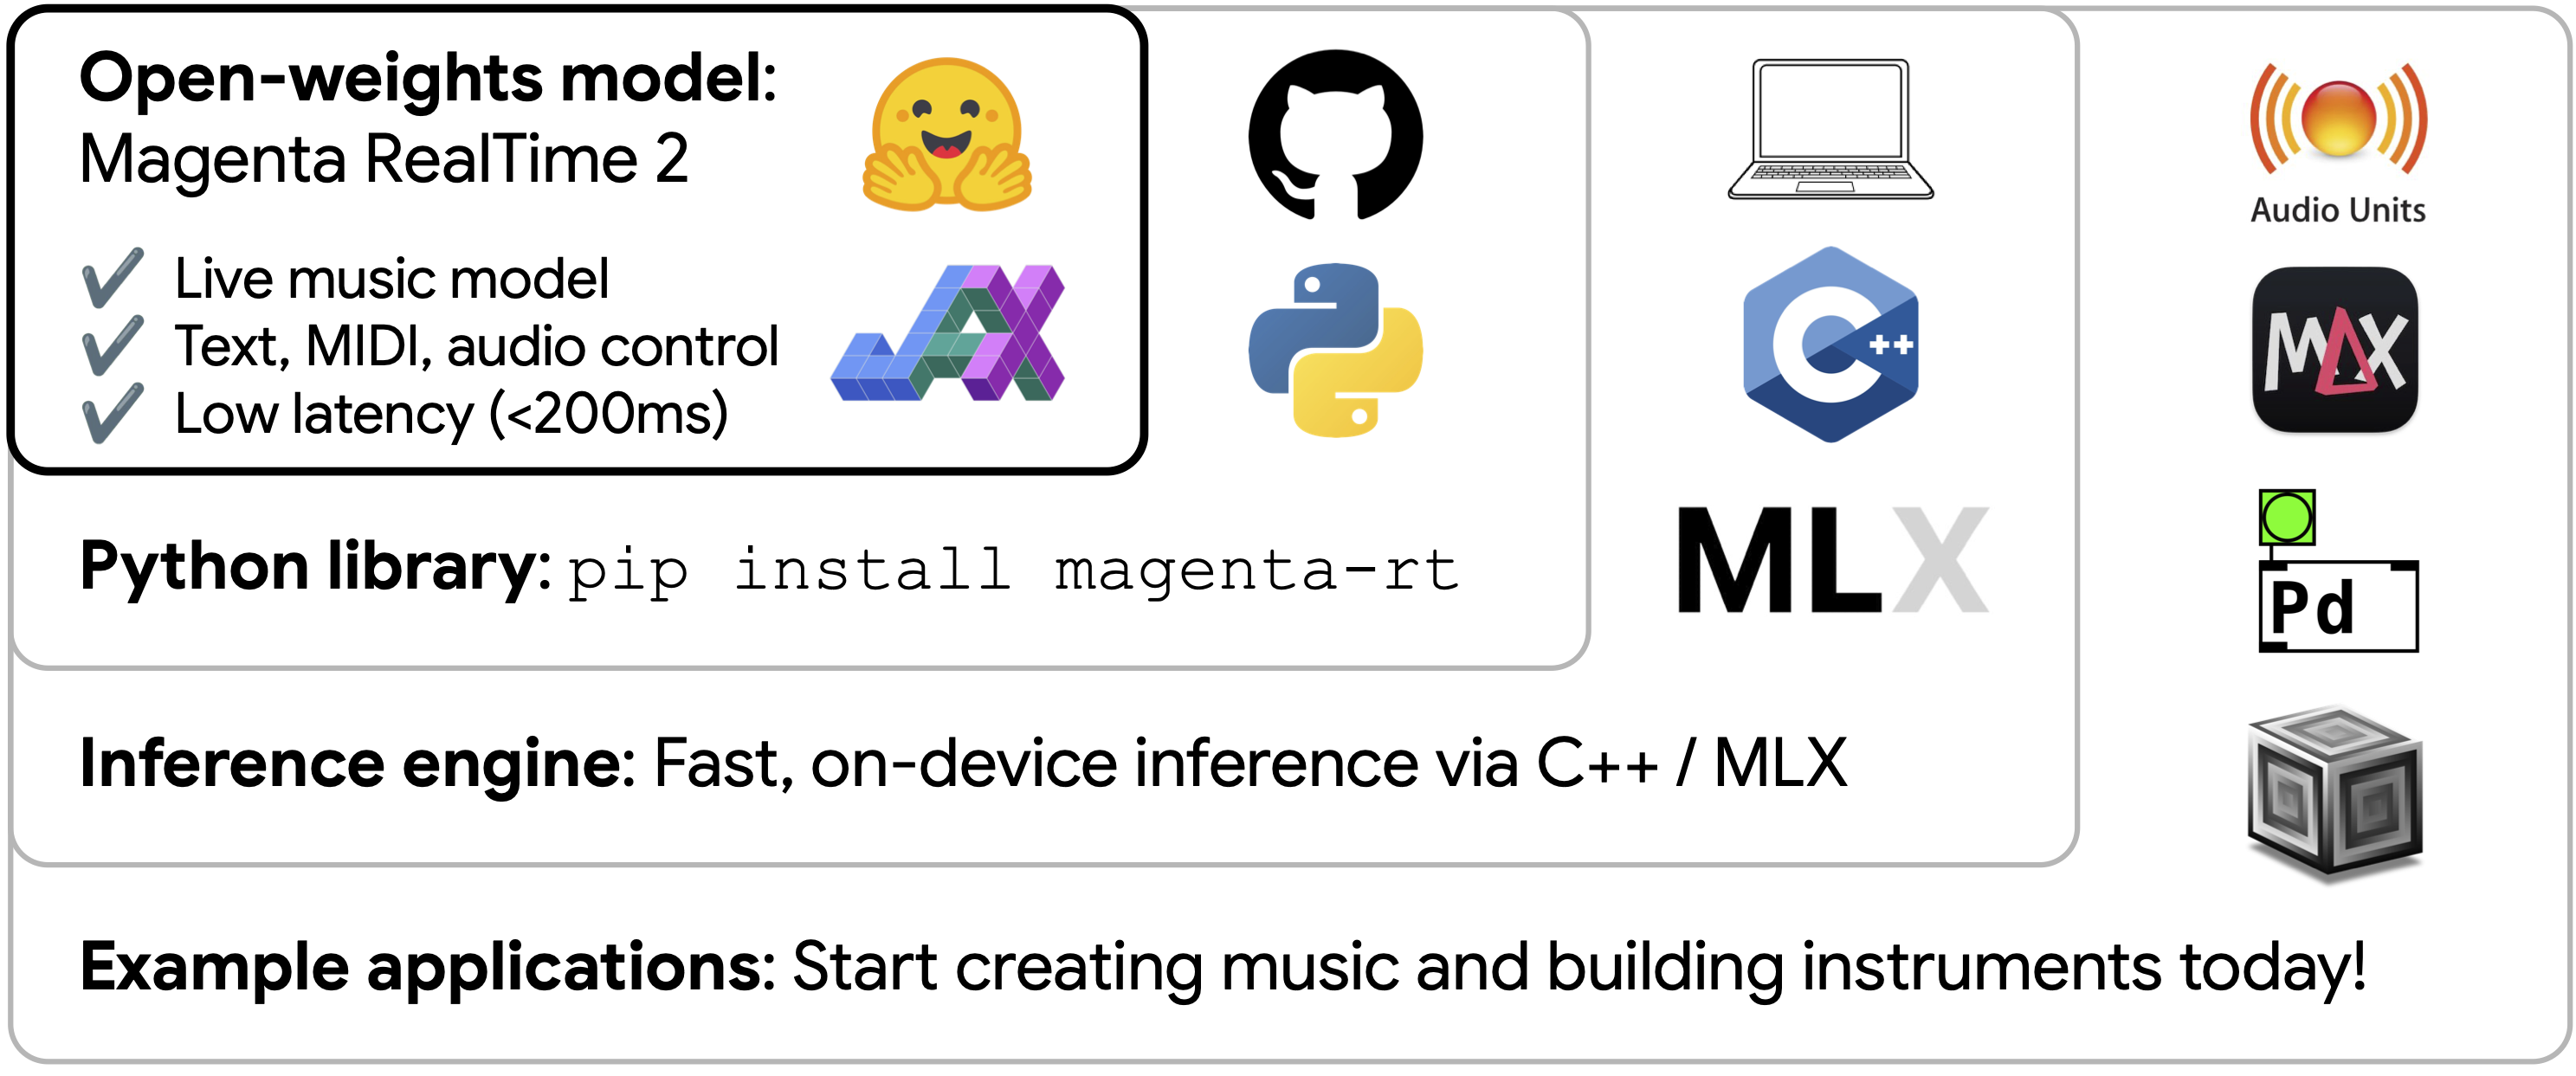 Modèle
Google Magenta RealTime 2 : quand un modèle musical devient un instrument jouable
Présentation technique de MRT2 couvrant l'autorégression par frames de 40 ms, le contrôle MIDI/texte/audio à faible latence, la structure 2.4B/230M, le codec SpectroStream, les embeddings MusicCoCa et les limites de la génération musicale live.
Lire l’article